
Somadores, ULAs e aritmética de largura finita
O objeto matemático implementado
Uma palavra sem sinal de largura w representa um inteiro de zero a 2^w − 1. A adição armazenada nessa palavra é uma adição módulo 2^w: descartam-se múltiplos de 2^w e preserva-se o resto. Isso descreve a representação; não autoriza descartar transbordamentos em tamanhos de alocação ou cálculos de endereços. O chamador deve decidir se o retorno modular é intencional. As flags de carry e overflow fornecem informações perdidas quando o resultado matemático completo é reduzido a uma palavra.
Os mesmos bits podem representar um inteiro com sinal em complemento de dois. Quando o bit mais alto é zero, o valor com sinal coincide com o valor sem sinal. Caso contrário, subtrai-se 2^w. Em oito bits, 0xff representa 255 sem sinal ou −1 com sinal. O somador não precisa de portas de soma diferentes para essas interpretações. Precisa de predicados diferentes para informar se o resultado matemático cabe na interpretação escolhida. Confundir esses predicados é um defeito recorrente em emuladores.
O ChrisOS contém um modelo de software para o estado aritmético em chrisvm/cpu/emulator/flags.c. Esse modelo descreve resultados arquiteturais, não uma rede de transistores. As estruturas de portas abaixo explicam como construir a aritmética de largura finita. Não significam que o ChrisCPU simule cada porta nem que o processador físico hospedeiro use determinada topologia de carry.
Derivação do somador completo
Em uma posição, a e b são bits dos operandos e c é o carry de entrada. Existem oito combinações. O inteiro a + b + c varia de zero a três. Seu bit baixo torna-se a soma s; seu bit alto torna-se o carry de saída k.
| a | b | c | s | k |
|---|---|---|---|---|
| 0 | 0 | 0 | 0 | 0 |
| 0 | 0 | 1 | 1 | 0 |
| 0 | 1 | 0 | 1 | 0 |
| 0 | 1 | 1 | 0 | 1 |
| 1 | 0 | 0 | 1 | 0 |
| 1 | 0 | 1 | 0 | 1 |
| 1 | 1 | 0 | 0 | 1 |
| 1 | 1 | 1 | 1 | 1 |
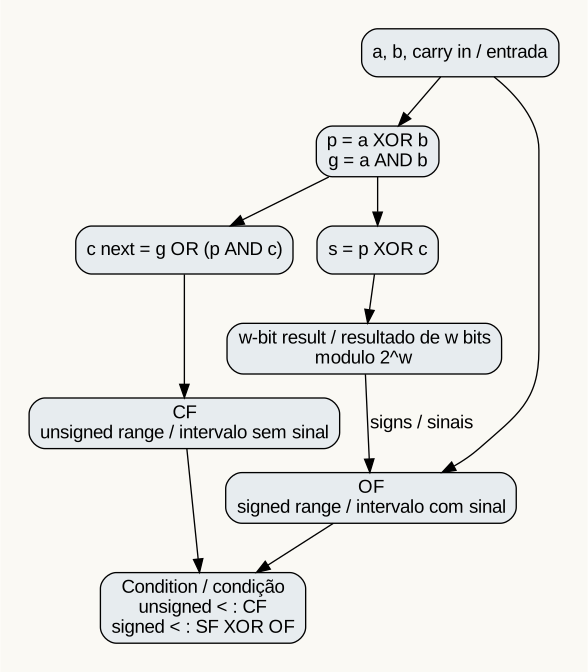
Definindo propagação p = a XOR b e geração g = a AND b, obtêm-se s = p XOR c e k = g OR (p AND c). Geração significa que a posição produz carry independentemente da entrada. Propagação significa que o carry recebido atravessa a posição. Quando ambos os operandos são zero, a posição elimina o carry recebido. Esses significados explicam as equações, em vez de apenas fornecer uma expressão para memorizar.
Um somador ripple de n bits conecta cada k ao c seguinte. Cada estágio tem tamanho constante, portanto a área cresce linearmente com a largura. No pior caso, um carry afeta todos os estágios; em um modelo fixo de portas, a profundidade de propagação é O(n). Somar um a uma palavra composta apenas por uns fornece um exemplo: o resultado é zero e o carry final é um. As saídas de soma não precisam estabilizar simultaneamente.
Antecipação de carry e custo do paralelismo
Para grupos adjacentes, um grupo propaga somente quando todas as posições propagam. Combinando um grupo alto H com um grupo baixo L, obtêm-se P = P_H P_L e G = G_H OR (P_H G_L). O carry de saída é G OR (P c_in). Essa combinação é associativa: agrupar três intervalos adjacentes em qualquer ordem produz a mesma função de carry. A associatividade permite que uma árvore ou rede de prefixos calcule carries com profundidade lógica logarítmica, em vez de uma cadeia linear.
A profundidade lógica é apenas uma restrição. Uma rede de prefixos introduz mais nós intermediários, fios, fanout e capacitância. Um projeto com menos níveis de portas pode perder parte da vantagem após posicionamento e roteamento físicos. Ripple, seleção de carry e diferentes organizações de prefixos representam compromissos de área, potência e atraso. Um emulador que utiliza o operador + do hospedeiro não expõe qual estrutura o processador utiliza. Seu desempenho deve ser medido na fronteira do software.
A soma carry-save resolve outro problema: reduzir três palavras a duas sem propagar carry imediatamente por toda a largura. Em cada posição, um somador completo produz um bit de soma e um carry para o peso seguinte. Reduções repetidas são úteis nos produtos parciais da multiplicação; ainda é necessário um somador final com propagação de carry. Carry-save é, portanto, uma representação intermediária redundante, não uma nova interpretação do registrador arquitetural final.
Subtração e empréstimo
Em uma largura w, a − b equivale a a + NOT(b) + 1 módulo 2^w. Um somador compartilhado pode inverter b condicionalmente e selecionar o carry inicial. Um bit de controle de subtração pode alimentar portas XOR em cada bit de b e a entrada de carry baixa. Isso permite reutilizar o circuito sem mudar o significado da palavra de saída.
O carry final dessa adição complementada não tem a mesma polaridade de uma indicação de empréstimo sem sinal. Se a sem sinal é menor que b sem sinal, a subtração exige empréstimo. O estado de subtração do ChrisCPU utiliza essa convenção em CF. Em SBB com CF de entrada igual a um, há empréstimo quando a ≤ b; sem esse empréstimo de entrada, quando a < b. Testar a < b + 1 na largura original seria incorreto quando b fosse a palavra máxima, pois b + 1 também retornaria modularmente a zero. A implementação compara a e b diretamente.
Em oito bits, 0x00 − 0x01 produz 0xff, CF = 1 e OF = 0. O resultado sem sinal fica abaixo do intervalo, mas zero menos um com sinal é representável. Já 0x80 − 0x01 produz 0x7f, CF = 0 e OF = 1: 128 sem sinal menos um cabe, mas −128 com sinal menos um ultrapassa o limite. O resultado retido isoladamente não distingue esses casos.
Overflow com sinal como predicado booleano
Na adição, ocorre overflow com sinal quando os operandos têm o mesmo sinal e o resultado tem o sinal oposto. A expressão vetorial ((a XOR r) AND (b XOR r) AND sign_bit) != 0 detecta esse caso. Na subtração, os operandos devem ter sinais diferentes e o resultado deve diferir do sinal de a: ((a XOR b) AND (a XOR r) AND sign_bit) != 0.
| Operação de oito bits | Resultado | CF | OF | Interpretação |
|---|---|---|---|---|
0x7f + 0x01 |
0x80 |
0 | 1 | 127 + 1 excede o máximo com sinal |
0xff + 0x01 |
0x00 |
1 | 0 | −1 + 1 cabe no intervalo com sinal |
0x80 + 0x80 |
0x00 |
1 | 1 | −128 + −128 não cabe |
0x80 - 0x01 |
0x7f |
0 | 1 | Resultado negativo retorna como positivo |
SF informa o bit mais alto do resultado armazenado, não o sinal do resultado matemático ilimitado. Após subtração, SF XOR OF recupera o predicado menor-que com sinal. A comparação sem sinal usa CF. A igualdade usa ZF nas duas interpretações. Isso explica por que chris_cc_true utiliza sf != of na condição 12, mas CF na condição 2. Um compilador que seleciona a condição errada pode produzir resultados aparentemente corretos com inteiros positivos pequenos e falhar perto de uma fronteira de sinal.
A interface concreta do ChrisCPU
chris_flags_bin(alu, a, b, os, flags, result) recebe os em bytes. As larguras previstas são 1, 2, 4 e 8 bytes. A função mascara os operandos, deriva o bit de sinal da largura, armazena opcionalmente o resultado em um ponteiro pertencente ao chamador e retorna o estado atualizado. Não aloca memória nem contém estado mutável compartilhado. Um ponteiro de resultado nulo suprime o armazenamento, mas não o cálculo das flags.
A função pressupõe largura e seletor de ULA válidos. Não retorna um erro de validação. Em particular, a máscara utiliza 64 bits como caso padrão, enquanto a expressão do bit de sinal depende de os; larguras arbitrárias não podem ser passadas com segurança como se fosse um serviço aritmético público genérico. A operação lógica residual é XOR. Essas são precondições da interface, não garantias de sanitização. A fronteira de decodificação deve restringir os valores antes da chamada.
Para ADD e ADC, a implementação amplia o cálculo para unsigned __int128, retém o resultado na largura escolhida e obtém CF dos bits acima dessa largura. Ampliar antes da soma é essencial para operandos convidados de 64 bits: somar apenas em uint64_t perderia carry antes de testá-lo. O compilador hospedeiro precisa suportar essa extensão. Para SUB, CMP e SBB, a subtração sem sinal fornece o resultado modular e comparações fornecem empréstimo. Não é necessário provocar overflow com sinal no hospedeiro para modelar overflow com sinal do convidado.
Responsabilidade e preservação das flags
write_status limpa e substitui seis bits, preserva os demais bits recebidos e força o bit 1 para um. A preservação importa porque a aritmética não pode apagar acidentalmente outro estado da máquina. A tabela descreve o comportamento observável dessa função na revisão analisada.
| Bit | Nome | Cálculo |
|---|---|---|
| 0 | CF | Carry de adição; empréstimo de subtração |
| 2 | PF | Paridade par do byte menos significativo |
| 4 | AF | Carry ou empréstimo do nibble baixo, pelo bit 4 de a XOR b XOR r |
| 6 | ZF | Resultado mascarado pela largura igual a zero |
| 7 | SF | Bit mais alto da largura selecionada |
| 11 | OF | Resultado com sinal fora do intervalo representável |
A paridade é reduzida por dobramentos XOR sucessivos em um byte; os bytes superiores não afetam PF. Em AND, TEST, OR e XOR, a função coloca CF, OF e AF em zero. Esse é o comportamento determinístico escolhido pelo emulador para AF; o capítulo não o transforma em garantia universal de x86. CMP calcula o estado de subtração e TEST calcula o estado de AND. Escrever ou não um destino arquitetural é responsabilidade do executor, fora do contrato dessa função.
A função é reentrante para armazenamento independente dos chamadores, mas isso não torna o estado inteiro de uma CPU seguro para modificação concorrente. Duas threads hospedeiras escrevendo no mesmo ponteiro de resultado continuam exigindo sincronização. Flags e registradores de destino também precisam de atualização coerente no nível da instrução. Uma rotina de cálculo puro não fornece, sozinha, exceções precisas ou operações atômicas em memória.
Multiplicação, divisão e deslocamentos na ULA
A multiplicação sem sinal deriva da escrita de b como soma dos seus bits multiplicados por potências de dois. Para cada bit b_i igual a um, soma-se a deslocado i posições à esquerda. Dois operandos de w bits exigem até 2w bits de resultado. Truncar é uma decisão arquitetural separada. Multiplicadores em matriz ou árvore implementam reduções paralelas; projetos iterativos de deslocamento e soma reutilizam um somador durante vários passos. Essas construções explicam as alternativas sem atribuir um multiplicador específico ao ChrisCPU.
A divisão sem sinal seleciona bits do quociente e mantém um resto. Uma operação concluída corretamente satisfaz a = q b + r e 0 ≤ r < b para b diferente de zero. Divisão por zero e quociente não representável exigem tratamento arquitetural explícito. A divisão com sinal inclui o caso excepcional do valor mínimo dividido por −1. Essas operações não são implementadas por chris_flags_bin; seu resultado não serve como evidência da semântica de divisão.
Um deslocamento descarta bits em uma extremidade e insere bits na outra. O deslocamento lógico à direita insere zeros; o aritmético estende o bit de sinal. Um barrel shifter pode escolher deslocamentos em potências de dois por uma quantidade logarítmica de estágios multiplexadores. Rotações recirculam bits descartados. Mascaramento da contagem e comportamento das flags são regras adicionais: nem o deslocamento matemático nem o operador C do hospedeiro estabelecem isoladamente o contrato da instrução convidada.
Validação e limites da evidência
O repositório inclui a verificação reproduzível scripts/check_arithmetic.py --source .source. Ela compila o flags.c real em uma biblioteca compartilhada temporária e compara todos os pares de operandos de oito bits de ADD, ADC, SUB, SBB e CMP com um modelo independente de intervalos inteiros. Ambos os valores de carry de entrada são testados nas operações que o consomem. CF esperado vem do intervalo sem sinal ilimitado, OF do intervalo com sinal, AF do intervalo do nibble baixo e PF da contagem de uns no byte baixo. A verificação também cobre operações lógicas, todos os predicados condicionais, preservação de flags não relacionadas e fronteiras representativas em larguras maiores.
Essa verificação estabelece o comportamento testado da função na revisão fornecida e com o compilador hospedeiro utilizado. Não executa instruções decodificadas, valida operandos de memória, inicializa um convidado, caracteriza atrasos físicos ou prova todo o conjunto x86. Uma verificação isolada é útil precisamente porque seu escopo é explícito. Testes de integração devem demonstrar separadamente que decodificação, seleção de operandos, escrita de resultados e exceções utilizam essa aritmética corretamente.
Aprofundamento teórico
As notas do MIT 6.004 fornecem material didático primário sobre síntese combinacional e multiplicadores. As derivações e a análise da implementação acima são próprias deste capítulo; o material externo permite aprofundar o projeto de circuitos. As afirmações sobre a implementação estão vinculadas à revisão indicada nos metadados.