
Arquitetura do ChrisFS: layout, alocação, journal e validação
Sobre este capítulo Estruturas e recuperação do ChrisFS
Neste capítulo
- Arquitetura do ChrisFS: layout, alocação, journal e validação
- Escopo
- Posição na stack
- Objeto principal em memória
- Layout on-disk de alto nível
- Geometria dinâmica do v5
- Superblock como ABI persistente
- Versões do formato
- Formatação do volume
- Inode table
- Integridade de inode
- Endereçamento de data blocks
- Assimetria importante de tamanho máximo
- Caminho de whole-file write
- Caminho incremental
- Implementação de truncate
- Bitmap de espaço livre
- Rollback local de allocation
- Lifetime de pointer blocks
- Representação de diretórios
- Capacidade de diretório
- Sintaxe de paths
- Traversal
- Operações públicas
- Semântica de rename
- Permissões
- Modification time
- Cache de setores
- Coerência do cache
- Read-ahead
- Lock do filesystem
- Consequências de concorrência
- Estrutura do journal
- Journal begin
- Logging do journal
- Switch data-vs-metadata
- Ordem de commit
- Replay
- Por que descartar BEGIN não é rollback completo
- Clean flag e fsck
- Arquitetura do fsck
- Limites do fsck
- Modelo de erros
- Validação no mount
- Persistence boundary
- Evidência de validação
- Perfil de performance
- Segurança e integridade
- Limitações atuais
- Fronteira de roadmap
- Mapa de source e revisão
Escopo
ChrisFS é o filesystem nativo usado pelo ChrisOS para árvores persistentes do sistema, imagens instaladas e operações comuns de arquivos e diretórios. Ele trabalha diretamente sobre a abstração genérica BlockDevice e atualmente assume setores de 512 bytes.
A implementação reúne, em um filesystem compacto:
- geometria on-disk versionada;
- allocator por bitmap;
- inodes de tamanho fixo;
- endereçamento direto e por múltiplos níveis de indireção;
- dirents de tamanho fixo;
- parsing e traversal de paths;
- pequeno cache de setores;
- mecanismo de journal voltado principalmente a metadata;
- bits de permissão;
- lock global reentrante;
- consistency checker utilizável em runtime.
Este capítulo é a visão arquitetural. Os capítulos seguintes de ChrisFS detalham separadamente os contratos de superblock, inodes, diretórios, journal, cache e fsck.
O comportamento atual foi reconciliado com ChrisOS e05a17fd76333114a3fb5c2452f38ca747d4ac56.
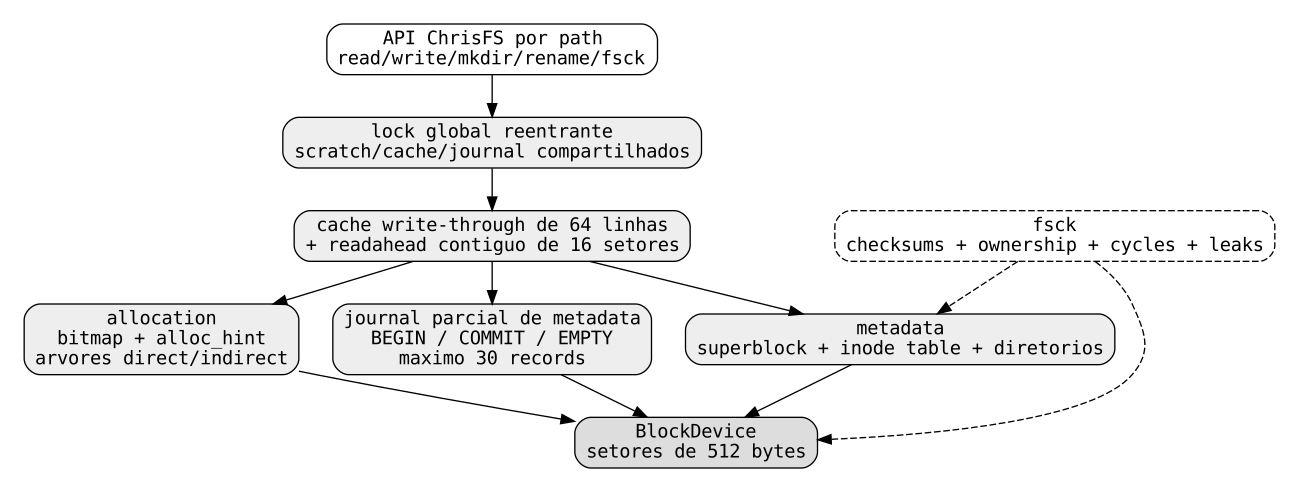
Posição na stack
ChrisFS não fala diretamente com ATA, AHCI, NVMe, VirtIO Block ou USB.
Sua fronteira é:
Em uma instalação GPT normal, ChrisFS aparece por meio de PartView. Imagens antigas podem colocar ChrisFS diretamente no LBA 0 do disk inteiro.
No mount, o filesystem conhece apenas um block device lógico de setores de 512 bytes e seu número de setores.
Objeto principal em memória
O estado montado é representado por Cfs.
Campos importantes:
dev             BlockDevice de backing
super           superblock decodificado
cache[64]       linhas de cache de setores
sector[512]     scratch sector compartilhado
clock           contador de idade do cache
cache_hits
cache_misses
mounted
jnl             estado da transação de journal
jnl_active
jnl_data
alloc_hint      próximo índice preferido de allocation
O objeto é pequeno, porém vários campos são scratch state compartilhado. Por isso a serialização global do filesystem faz parte da correção, e não apenas da performance.
Layout on-disk de alto nível
Um volume v5 atual é:
LBA 0                    superblock
região de bitmap         mapa livre/usado dos data blocks
região de inodes         2048 inodes de tamanho fixo
região de journal        64 setores
região de dados          arquivos, diretórios e pointer blocks
No v5, o tamanho do bitmap é calculado a partir do sector count real do backing device.
A inode region e o tamanho do journal permanecem fixos.
Geometria legada
Versões 3 e 4 são aceitas com a geometria histórica de 512 MiB:
sector size          512
total sectors        1.048.576
bitmap start         1
bitmap sectors       256
inode start          257
inode sectors        512
journal start        769
journal sectors      64
data start           833
Um volume v5 de 512 MiB naturalmente chega ao mesmo data-start LBA, preservando compatibilidade de layout enquanto volumes v5 maiores podem ampliar o bitmap.
Geometria dinâmica do v5
cfs_geom_for_count calcula iterativamente o tamanho do bitmap.
Cada setor de bitmap descreve:
O algoritmo reserva:
- um setor para superblock;
- 512 setores de inodes;
- 64 setores de journal;
- bitmap suficiente para cobrir a data region restante.
A iteração termina quando o bitmap escolhido consegue representar todos os data sectors resultantes.
O invariante final é:
e a capacidade do bitmap precisa ser pelo menos igual a data_sectors.
Assim, o v5 usa a capacidade real do block device em vez de limitar todos os filesystems silenciosamente ao antigo layout de 512 MiB.
Superblock como ABI persistente
CfsSuper armazena:
- versão do formato;
- generation;
- clean flag;
- total sectors;
- bitmap LBA/count;
- inode LBA/count;
- journal LBA/count;
- data LBA/count.
O encoder não despeja uma struct C diretamente no disk. Ele grava offsets little-endian definidos em um setor de 512 bytes.
O setor contém:
magic
version
sector size
campos de geometria
root inode id
clean flag
generation
geometria do journal
checksum
O checksum é o checksum de 32 bits do projeto, semelhante a FNV-1a, sobre os primeiros 60 bytes.
O decoder valida magic, versão suportada, sector size, checksum e geometria antes de permitir que o restante do código use os LBAs armazenados.
Isso é uma fronteira de segurança e confiabilidade: metadata corrompida não validada poderia transformar offsets em reads/writes arbitrários no block device.
Versões do formato
As constantes atuais definem:
O decode de v3/v4 exige exatamente a geometria legada.
O v5 grava e valida geometria dinâmica.
A camada explícita de encode/decode é necessária porque filesystem é ABI persistente. Alterar CfsSuper ou CfsInode em memória não pode redefinir discos antigos por causa de padding ou alinhamento do compilador.
Formatação do volume
cfs_format exige:
- block device não nulo;
- setores de 512 bytes;
- mídia writable;
- geometria representável pelo v5.
O fluxo de format:
- calcula a geometria v5;
- zera todos os setores de metadata de LBA 0 até o início dos dados;
- marca o data-block index 0 como usado no bitmap;
- inicializa todos os inodes como livres;
- cria inode 0 como root directory;
- aponta o primeiro direct block do root para o primeiro data LBA;
- zera esse bloco de diretório;
- grava o superblock codificado;
- inicializa o header do journal como EMPTY;
- chama
bd_flush.
O root inode consome, portanto, o primeiro data block desde o início.
Inode table
O inode possui:
e existem:
Quatro inodes cabem em um setor de 512 bytes.
Inode 0 é reservado para root. Allocation começa em ID 1.
CfsInode inclui:
- type;
- flags;
- file size;
- generation;
- 12 direct pointers;
- indirect pointer;
- double-indirect pointer;
- triple-indirect pointer;
- uid/gid;
- mode de permissão;
- mtime de 64 bits dividido em high/low;
- checksum na representação on-disk.
Inodes livres possuem type zero.
Integridade de inode
Cada inode codificado guarda checksum dos primeiros 124 bytes nos quatro bytes finais.
inode_read rejeita inode cujo checksum não coincide e retorna corrupção de filesystem.
Como quatro inodes compartilham o mesmo setor, updates de inode são read-modify-write pelo cache.
Endereçamento de data blocks
Um pointer block de 512 bytes contém:
A árvore é:
Os níveis até double-indirect cobrem:
Com triple-indirect, a árvore pode descrever 2.113.676 blocks, aproximadamente 1,008 GiB, embora o tamanho real também dependa da capacidade do volume e da API pública usada.
Assimetria importante de tamanho máximo
As APIs atuais não expõem o mesmo limite.
cfs_write e cfs_truncate limitam:
correspondente a direct + indirect + double-indirect.
Porém file_lba implementa triple-indirect, enquanto cfs_write_at e cfs_read_at verificam contra:
Aqui CFS_DATA_SECTORS é a constante compile-time da geometria legada, e não fs->super.data_sectors do volume v5 montado. I/O incremental pode, portanto, exercer triple indirection, mas aumentar um filesystem v5 não eleva esse ceiling de API.
Isso é comportamento atual, não um contrato unificado. Os limites deveriam ser derivados de um único contrato baseado no volume montado.
Caminho de whole-file write
cfs_write substitui o conteúdo completo do arquivo.
Se o arquivo não existe, primeiro o cria.
Depois:
- carrega o inode;
- calcula número antigo e novo de blocks;
- inicia uma transação de journal;
- resolve/aloca cada block necessário;
- grava todos os novos data sectors;
- libera blocks antigos excedentes ao reduzir tamanho;
- elimina pointer structures não mais necessárias;
- atualiza size, mtime e inode generation;
- grava o inode;
- incrementa filesystem generation;
- executa journal commit.
O último setor parcial é zerado antes da cópia dos bytes do caller.
Caminho incremental
cfs_write_at altera uma faixa de bytes.
Pode criar um arquivo ausente, aumentar file size e fazer read-modify-write de setores parciais.
Para cada block tocado:
- resolve ou aloca o LBA;
- lê o setor;
- modifica somente a faixa desejada;
- grava o setor.
Depois atualiza o inode e faz commit.
Não existe representação válida de sparse hole. Extensão para offset distante é particularmente problemática: cfs_write_at aumenta o inode size para offset + size, mas aloca somente os blocks efetivamente tocados pela escrita. Full blocks pulados entre o EOF antigo e o novo offset podem continuar não alocados; leituras sequenciais posteriores podem retornar CFS_ECORRUPT e fsck pode reportar size vs blocks. Callers devem atualmente evitar extensão que atravesse gaps de blocks não alocados.
Implementação de truncate
cfs_truncate é funcional, porém custoso.
Ele aloca um work buffer de:
lê o arquivo inteiro, zera a região nova quando há crescimento e chama cfs_write para o tamanho final.
Consequências:
- até cerca de 8,07 MiB de memória temporária;
- O(file size) de cópia para pequenas mudanças;
- não consegue truncar arquivos acima do limite de
cfs_write, mesmo que tenham crescido viacfs_write_at.
Não é um algoritmo de truncate escalável.
Bitmap de espaço livre
Cada data block corresponde a um bit do bitmap.
bitmap_get e bitmap_set traduzem um data-block index para:
Allocation faz busca semelhante a first-fit a partir de alloc_hint.
Sem o hint, cada allocation recomeçaria do zero e grandes cópias ficariam progressivamente mais caras.
Com o hint, workloads sequenciais normalmente continuam próximos da última posição usada.
O pior caso ainda é:
quando o volume está cheio ou fragmentado.
Rollback local de allocation
Quando block_alloc encontra um bit livre:
- marca como usado;
- zera o data block correspondente;
- se a escrita do zero falhar, limpa o bit novamente;
- avança
alloc_hint.
Isso cobre uma janela local de falha, mas não torna uma operação complexa inteira transacional.
Lifetime de pointer blocks
Pointer blocks são alocados no mesmo data-block allocator.
Ao reduzir ou apagar arquivos, ChrisFS libera:
- data blocks;
- indirect blocks;
- blocos de segundo nível;
- árvores triple-indirect.
Há helpers específicos de prune/free porque liberar somente folhas e manter pointer blocks causaria vazamento no bitmap.
Representação de diretórios
Diretório é um inode cujos data blocks contêm records CfsDirent de tamanho fixo.
Cada dirent possui:
e inclui:
- inode;
- type;
- name length;
- flags;
- 64 bytes para nome.
Cabem apenas:
entries por setor; 32 bytes de cada setor de diretório ficam sem uso.
Nomes são byte strings e matching é case-sensitive.
Os testes verificam explicitamente que foo e Foo são nomes distintos.
Capacidade de diretório
Diretórios usam somente:
e não a árvore completa de double/triple-indirect usada por arquivos.
Com seis dirents por block, o limite estrutural é aproximadamente:
assumindo inodes e blocks livres suficientes.
Entries removidas viram slots reutilizáveis.
O campo size do inode de diretório muda em incrementos lógicos de 80 bytes, mas lookup/listing escaneiam a faixa de blocks suportada em vez de usar size como única autoridade.
Sintaxe de paths
O parser aceita paths como:
e também um único slash inicial:
Limites:
O parser rejeita:
- componentes vazios no meio;
- trailing slash em path não-root;
- backslash;
.;..;- componentes acima de 64 bytes;
- mais de 32 componentes.
ChrisFS não possui current-working-directory interno; traversal parte sempre do root.
Traversal
walk_parent resolve todos os componentes menos o leaf final.
walk_full resolve o path completo.
Objetos intermediários precisam ser directories e passar a permissão WALK.
Lookup de diretório é linear nos blocks e dirents.
Para path de profundidade d e diretórios com n entries, lookup é aproximadamente O(d × n), sem hash ou árvore de índice.
Operações públicas
A API expõe:
- create;
- mkdir;
- rmdir;
- unlink;
- rename;
- stat;
- read;
- read_at;
- write;
- write_at;
- truncate;
- list;
- list_at;
- chmod;
- permission check;
- consulta de mtime;
- sync;
- fsck.
Não há symlinks, hard links, device nodes, sockets, extended attributes ou open-file handles dentro do ChrisFS.
A API é majoritariamente pathname-based.
Semântica de rename
cfs_rename:
- resolve parent antigo e novo;
- verifica write permission nos dois;
- rejeita collision no destino;
- adiciona dirent novo apontando para o mesmo inode;
- remove o dirent antigo.
Pode mover entre diretórios dentro do mesmo filesystem.
Um limite importante é que o add/remove não é encapsulado uniformemente por jnl_begin/jnl_commit. Falha entre os dois passos pode deixar rename parcial. Também não existe descendant/ancestor check: mover um diretório para dentro de um de seus próprios descendentes pode criar cycle no graph de diretórios.
Permissões
ChrisFS define quatro bits:
Novos inodes recebem os quatro.
A política atual não equivale a um modelo Unix multiusuário.
cfs_perm_need rejeita inode com:
e, caso contrário, testa o bit da mode mask.
uid/gid existem no formato, mas a semântica implementada é essencialmente de objetos root-owned com máscara simples.
chmod grava os quatro bits inferiores tanto em mode quanto em flags por compatibilidade.
Modification time
Cada inode guarda mtime de 64 bits em dois campos de 32 bits.
ChrisFS mantém um logical clock global.
cfs_set_now pode inicializá-lo a partir de uma fonte externa, e alterações incrementam o valor antes de gravar o mtime.
Isso não é um serviço completo de wall clock; é um mecanismo de timestamp de inode controlado pelo ambiente do kernel.
Cache de setores
Cada Cfs montado possui:
mais tags e age counters.
O cache é read-through e write-through.
Hit atualiza age. Miss escolhe uma linha inválida ou a linha com menor age, aproximando LRU.
Writes vão imediatamente ao block device e depois atualizam uma linha de cache.
Não há dirty cache lines aguardando writeback.
Coerência do cache
Antes de instalar um valor novo para determinado LBA, a implementação invalida linhas duplicadas desse LBA.
Read-ahead multi-sector também remove do cache os setores envolvidos ao bypassar o caminho single-sector.
O lock global protege scratch sector, metadata do cache e buffer global de read-ahead.
Read-ahead
Para reads alinhados, cfs_read_at detecta file blocks fisicamente contíguos.
Ele lê até:
em uma única chamada bd_read.
Isso representa até 8192 bytes por run.
Reads fragmentados ou desalinhados usam setores individuais pelo cache.
A otimização exige adjacency física, não apenas lógica.
Lock do filesystem
As principais operações públicas entram no g_cfs_lock.
O lock guarda:
- locked flag;
- owner;
- reentrancy depth.
No kernel, owner é:
permitindo reentrada no mesmo CPU.
O header deixa explícito que esse lock não deve ser usado em interrupt handler.
Waiters usam loop com pause sem desabilitar interrupções.
Apesar de um comentário chamá-lo de “yielding lock”, não há scheduler yield na primitiva atual; ela se comporta como espera spin reentrante com interrupts habilitados.
Consequências de concorrência
O lock global serializa operações ChrisFS entre CPUs.
Ele protege:
fs->sector;- cache;
- estado do journal;
alloc_hint;- read-ahead buffer global;
- mutações de metadata.
O custo é não haver I/O ChrisFS paralelo para arquivos independentes.
test_cfs_lock usa threads host concorrentes e verifica que não surgem reads torn e que o filesystem final passa fsck.
Estrutura do journal
O journal possui 64 setores.
Header:
Estados:
Cada record consome dois setores:
- setor de metadata com target LBA e checksum;
- setor com payload completo de 512 bytes.
O limite em memória é:
que cabe na região fixa junto do header.
Journal begin
jnl_begin:
- associa a transação ao filesystem;
- usa filesystem generation como sequence;
- zera record count;
- seta
super.clean = 0; - grava o superblock diretamente;
- grava header BEGIN.
O retorno da escrita do superblock dirty é atualmente ignorado; o resultado do BEGIN header determina o retorno da função.
Isso é uma lacuna real de propagação de erro.
Logging do journal
Quando journaling está ativo e jnl_data == 0, cache_write chama primeiro jnl_log.
jnl_log grava:
- destination LBA;
- checksum do payload;
- setor de payload.
Depois do record ser escrito, cache_write também escreve imediatamente o mesmo setor em seu home LBA.
Essa ordem é crítica: o mecanismo atual não é um journal clássico em que todas as home writes aguardam um commit durável.
Switch data-vs-metadata
jnl_data desativa logging.
Em cfs_write e cfs_write_at, ele permanece 1 durante escrita de file data e durante allocation/pointer updates, voltando a 0 apenas para a escrita final do inode.
Consequentemente, o journal atual não captura todas as estruturas modificadas durante essas operações.
Bitmap e pointer blocks alterados enquanto jnl_data == 1 também ficam fora do journal, não somente o payload do usuário.
Outras operações, como mkdir e unlink, usam metadata logging de forma diferente.
Mutações como cfs_create, cfs_rmdir e cfs_rename também não encapsulam uniformemente todas as mudanças em begin/commit.
Portanto, o journal é infraestrutura parcial de recuperação, não atomicidade transacional universal do filesystem.
Ordem de commit
jnl_commit executa:
Não existe bd_flush entre esses estados.
cache_write_raw é write-through, mas não é persistence barrier.
Dispositivos que reordenam ou mantêm cache interno podem observar ordenação mais fraca do que a sequência lógica do código.
Um journal transacional forte exigiria flush/barriers explícitos e protocolo claro de home writes.
Replay
No mount:
- header do journal é inspecionado;
jnl_replayvalida magic e checksum;- EMPTY não faz nada;
- BEGIN é tratado como uncommitted e o journal é limpo;
- COMMIT reaplica records válidos aos target LBAs;
- o journal volta para EMPTY.
Cada payload é validado por checksum antes do replay.
State inválido ou checksum errado resulta em corrupção/erro, não em continuidade silenciosa.
Por que descartar BEGIN não é rollback completo
O teste host de journal prova que um record explicitamente logado e não committed é descartado após remount.
Porém o cache_write normal grava record e logo depois também grava o home block antes do commit.
Assim, um crash em estado BEGIN pode deixar parte das home writes já aplicada, mesmo que o replay descarte o log.
Não existe undo log para restaurar o conteúdo anterior.
O teste atual não simula essa janela comum de “home write executada antes do commit”.
Esse é um dos limites mais importantes da recuperação atual.
Clean flag e fsck
Transactions marcam o superblock como dirty no begin e clean no commit bem-sucedido.
Na inicialização de storage, filesystem montado com clean flag pode pular fsck.
Filesystem dirty passa por verificação.
Como replay não converte todo estado interrompido automaticamente em superblock limpo, fsck continua sendo a segunda linha de validação.
Arquitetura do fsck
cfs_fsck verifica invariantes cruzados, não apenas checksums locais.
Ele examina:
- superblock/checksum;
- journal state;
- bitmap;
- todos os inodes;
- type e checksum de inode;
- size versus blocks referenciados;
- direct/indirect pointer trees;
- ownership duplicado ou inválido de blocks;
- type do root;
- dirents;
- directory cycles;
- inode references;
- bitmap allocations vazadas.
Ele constrói estado “seen” e compara com o bitmap on-disk.
A parte de directory graph é menos completa que o ownership de blocks: atualmente examina apenas os 12 direct directory blocks, não a faixa single-indirect; duplicate-name tracking reinicia a cada block; e não há enforcement de reachability de todo inode alocado a partir do root.
A validação de file size também é assimétrica: direct pointers são cruzados estritamente com EOF, enquanto a ocupação obrigatória das árvores single/double/triple não é derivada de forma exata de inode size. Indirect blocks extras além de EOF podem, portanto, continuar aceitos como owned. O checker também não trata super.clean == 0 como erro por si só.
Para bitmaps v5 maiores, pode alocar mapas de trabalho dinamicamente em vez de depender somente dos arrays fixos legados.
Limites do fsck
O checker é principalmente validador.
Ele retorna status/error count e reason string; não é um repair engine genérico.
Razões incluem:
super checksum
journal dirty
journal pending replay
inode checksum
inode type
size vs blocks
dir cycle
bitmap leak
Reparo automático exigiria políticas explícitas para conflitos e reconstrução, ausentes no estado atual.
Modelo de erros
ChrisFS possui seu próprio espaço de erros:
CFS_EINVAL
CFS_EIO
CFS_EFORMAT
CFS_ENOENT
CFS_EEXIST
CFS_ENOSPC
CFS_EFBIG
CFS_ENAMETOOLONG
CFS_ECORRUPT
CFS_ENOTMOUNTED
CFS_ENOTDIR
CFS_ENOTEMPTY
CFS_EISDIR
CFS_EXDEV
CFS_EPERM
Falhas de block device normalmente viram CFS_EIO.
Isso simplifica a API, mas perde distinções como timeout versus media error no nível do filesystem.
Validação no mount
cfs_mount rejeita:
- filesystem/device nulo;
- sector size diferente de 512;
- block device com zero setores;
- superblock ilegível;
- superblock inválido ou incompatível;
- backing device menor que o total declarado;
- journal irrecuperavelmente corrompido;
- root inode inválido ou que não seja directory.
Ele reseta o cache, executa replay e confirma que inode 0 é directory.
O backing device pode ser maior que o total registrado pelo filesystem.
Persistence boundary
cfs_sync chama apenas:
A eficácia depende totalmente do backend.
Vários drivers atuais não fornecem callback de flush, e bd_flush considera callback ausente como sucesso.
Assim, ChrisFS pode pedir uma persistence boundary, mas diversos devices atuais não implementam flush real de hardware.
Isso também limita as garantias que o journal pode oferecer.
Evidência de validação
ChrisFS possui cobertura host-side relativamente ampla.
test_cfs_host
Cobre:
- format/mount;
- persistência após remount;
- cache;
- I/O failure injection;
- proteção contra magic desconhecido;
- limite whole-file;
- limite de nomes;
- muitos arquivos/diretórios.
test_cfs_paths
Cobre:
- nested directories;
- nomes case-sensitive;
- listing;
- rename no mesmo diretório e cross-directory;
- unlink/rmdir;
- rejeição de
.e..; - depth limit;
- remount;
- fsck.
test_cfs_journal
Cobre:
- geometria legada;
- descarte de BEGIN no remount;
- replay de COMMIT forçado;
- detecção de journal dirty por fsck.
test_cfs_lock
Usa duas threads host para exercitar serialização de read/write e verificar ausência de conteúdo torn.
test_cfs_maxwrite
Verifica exatamente o limite CFS_MAX_FILE_SIZE.
test_cfs_v5
Valida:
- compatibilidade v4;
- geometria dinâmica v5;
- allocation além da antiga fronteira de 512 MiB.
Testes adicionais de indirect pointers e fsck exercitam árvores mais profundas e corrupção.
Perfil de performance
ChrisFS prioriza transparência.
Custos principais:
- inode allocation linear;
- bitmap scan;
- directory lookup linear;
- lock global;
- cache write-through;
- APIs por path com traversal repetido;
- truncate com buffering do arquivo inteiro.
Otimizações presentes:
- allocation hint;
- cache com 64 linhas;
- read-ahead de 16 setores;
- formatos de metadata fixos;
- multi-level block pointers.
Para volumes grandes, muitos arquivos ou I/O concorrente, serão necessários índices e sincronização mais granular.
Segurança e integridade
Defesas atuais:
- decoders little-endian explícitos;
- checksum e validação de geometria do superblock;
- checksum de inode;
- limites de path/component/depth;
- rejeição de
.,..e backslash; - range checks de blocks;
- validação de inode em dirent;
- detecção de ownership/cycles no fsck;
- serialização global.
Lacunas:
- sem integridade criptográfica;
- sem autenticação;
- sem modelo multiusuário completo;
- sem ACL list;
- sem mount read-only/immutable;
- crash atomicity incompleta;
- flush guarantees limitadas;
- sem online repair;
- sem quotas.
Limitações atuais
Na revisão documentada:
- somente setores de 512 bytes;
- block/LBA accounting de 32 bits;
- 2048 inodes fixos;
- inode allocation linear;
- bitmap allocator com pior caso linear;
- directory lookup sem índice;
- cerca de 840 entries por directory sob a política atual;
- sem symlinks ou hard links;
- sem sparse files;
- sem file handles nesta camada;
- serialização global;
- cache somente write-through;
- journal parcial, sem atomicidade transacional completa;
- sem flush barriers entre transições de journal;
- mutações não uniformemente journaled;
- limite de
cfs_write/truncatediferente do alcance dewrite_at; - truncate com uso alto de memória;
- permission model simples e root-owned;
- fsck valida, mas não repara em geral;
- recovery limitado quando o block backend não fornece flush real.
Fronteira de roadmap
Uma evolução robusta deveria incluir:
- contrato unificado de file size;
- block addressing de 64 bits;
- allocation de inode escalável;
- diretórios indexados;
- sparse extents ou extent trees;
- journal com barriers duráveis e cobertura completa de transações;
- journaling consistente de rename/create/rmdir e allocation metadata;
- propagação de flush por partition views e hardware backends;
- locking mais granular;
- writeback com ownership explícito de dirty state;
- repair tooling;
- semântica de usuários/permissões mais forte;
- fuzzing de crash points e metadata corrompida.
Esses itens permanecem roadmap até existirem no source e em testes reproduzíveis.
Mapa de source e revisão
kernel/fs/cfs_format.h define superblock, inode, dirent e regras de geometria persistentes. kernel/fs/cfs.c implementa mount, allocation, block mapping, paths, diretórios, cache, journal e operações públicas. kernel/fs/cfs_fsck.c implementa consistency validation. kernel/fs/fs_lock.h define serialização. kernel/fs/storage.c integra mount e fsck condicional ao boot. tools/test_cfs_*.c fornece evidência comportamental host-side.
Todas as afirmações sobre comportamento atual neste capítulo foram reconciliadas com ChrisOS e05a17fd76333114a3fb5c2452f38ca747d4ac56.