
Datapath da CPU e arquitetura do conjunto de instruções
Sobre este capítulo Datapath, microarquitetura e ISA
Neste capítulo
- Datapath da CPU e arquitetura do conjunto de instruções
- Processador como máquina arquitetural
- Datapath
- Encoding de instruções
- Fetch, decode e execução
- ISA e ABI
- Arquitetura privilegiada
- ChrisOS e contratos arquiteturais
- Transição de estado, observação e implementação
- Uma soma dos bytes ao estado observável
- Gerar endereço não significa ler memória
- Laço de execução e responsabilidade por RIP
- Exceções e necessidade de um ponto de efetivação
- Pipelines físicos e limites do interpretador
- Ciclo de vida, interrupções e propriedade compartilhada
- Evidência e escopo ainda aberto
Processador como máquina arquitetural
Uma CPU não é definida apenas por possuir uma ALU. Na fronteira com software ela é uma máquina de estados governada por uma instruction-set architecture (ISA). A ISA especifica encodings e consequências visíveis: atualização de registradores, acesso à memória, controle de fluxo, exceções e efeitos de privilégio.
Estado arquitetural mínimo contém program counter, registradores gerais, flags e mecanismo de endereçamento de memória. x86-64 acrescenta estado de segmentos, control registers, descriptor tables, MSRs e uma arquitetura extensa de exceções.
Datapath
O datapath move e transforma valores. Conceitualmente inclui registradores, ALU, shifters, address generation, atualização do instruction pointer, caminhos para memória e multiplexadores.
Uma soma entre registradores ilustra o contrato:
A ISA pode definir carry, zero, sign e overflow sem expor o circuito que os produz.
Encoding de instruções
Código de máquina é a representação em bytes das operações e operandos. Assembly atribui nomes simbólicos a esses encodings. O assembler não inventa semântica; traduz uma representação legível para a forma binária definida pela ISA.
Instruções x86 têm comprimento variável e podem conter prefixes, opcode, ModR/M, SIB, displacement e immediate. Decodificação é, por isso, mais complexa que em muitas ISAs de largura fixa.
Fetch, decode e execução
O ciclo pedagógico é fetch → decode → execute. Cores reais usam pipeline e sobreposição, mas o resultado arquitetural deve respeitar as regras da ISA.
Branches alteram o próximo endereço. Calls preservam retorno conforme instrução e convenção de software. Loads e stores interagem com a hierarquia de memória e podem gerar fault antes de produzir resultado arquitetural.
ISA e ABI
ISA define o processador. Uma ABI define convenções usadas por software acima dela: registradores de argumentos, caller/callee-saved, alinhamento de stack, formatos de objeto e regras de símbolos.
Dois sistemas podem usar x86-64 e possuir ABIs de syscall diferentes. O compilador precisa obedecer ao encoding da ISA e à ABI do ambiente.
Arquitetura privilegiada
Sistemas operacionais exigem operações indisponíveis a aplicações comuns. x86-64 fornece níveis de privilégio e instruções privilegiadas para trocar page-table root, instalar descriptor tables, controlar interrupções e configurar a máquina.
A autoridade do kernel não é uma convenção de C. Ela é imposta pelo processador durante a execução.
ChrisOS e contratos arquiteturais
ChrisOS usa x86-64 como alvo principal. kernel/metal manipula diretamente page tables, GDT/IDT, interrupções e transições de contexto.
ChrisVM observa o mesmo contrato pelo outro lado. chrisvm/chris_arch.h define estado arquitetural que ChrisCPU precisa emular. chrisvm/cpu/emulator/execute.c interpreta operações e atualiza esse estado.
| Operação do kernel | Responsabilidade do emulador |
|---|---|
| Executar MOV | Implementar semântica de transferência de dados |
| Carregar CR3 | Atualizar contexto de tradução |
| Receber falta de página | Detectar e entregar a exceção |
| Escrever em porta de E/S | Despachar operação ao barramento |
A mesma ISA é um contrato consumido pelo sistema operacional e produzido pelo emulador.
Transição de estado, observação e implementação
Considere S contendo registradores arquiteturais, memória e estado de dispositivos observável externamente. Uma instrução é uma transição parcial T(S, bytes, eventos), que produz um novo estado ou uma exceção arquitetural. O qualificativo parcial é necessário: uma sequência de bytes pode não representar uma instrução válida, e uma leitura válida pode não apontar para memória acessível. A correção do processador não depende somente do resultado aritmético. Também depende dos efeitos produzidos, de sua ordem e do endereço de instrução informado quando a execução falha.
A ISA permite diferentes implementações. Uma máquina física pode representar um registrador por várias posições de armazenamento renomeadas; um interpretador pode representá-lo por um inteiro C. Ambas precisam apresentar o valor prescrito quando o software observa esse registrador. Topologia de transistores, capacidade de cache e organização de uma estrutura C do hospedeiro pertencem, portanto, a camadas diferentes. ChrisArchitectureState descreve o modelo arquitetural do emulador; não descreve o banco físico de registradores de um processador fabricado nem estabelece um formato portátil de checkpoint serializado.
É necessário separar três categorias de estado. O estado arquitetural inclui RIP e os registradores gerais. O controle interno do emulador inclui halted, exit_reason, rip_dirty e contadores. A máquina que envolve a CPU possui memória e dispositivos alcançados por cpu->machine. Copiar a estrutura arquitetural preserva somente a primeira categoria. Um checkpoint reproduzível da máquina inteira também exige RAM consistente, atividade pendente dos dispositivos e estado interno do emulador. Copiar um ponteiro não copia a máquina para a qual ele aponta.
Uma soma dos bytes ao estado observável
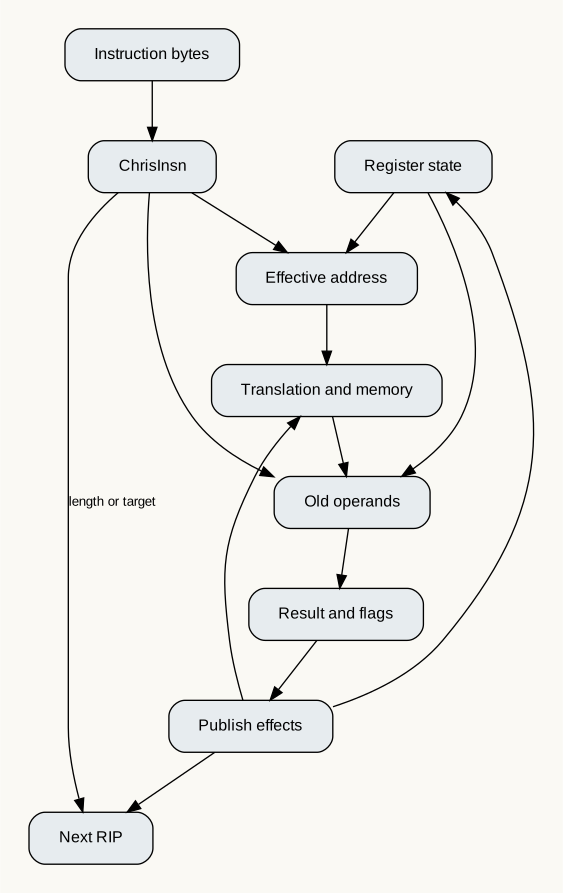
Na codificação 48 01 d8 em modo de 64 bits, REX.W seleciona operando de 64 bits. O opcode 01 seleciona soma com o operando registrador/memória como destino. ModR/M d8 seleciona endereçamento por registrador, RBX como fonte e RAX como destino. A sequência possui três bytes; não é a cadeia textual usada para representá-los em uma listagem assembly.
| Etapa | Representação | Invariante exigido |
|---|---|---|
| Busca | Bytes em RIP | Leituras obedecem às regras de acesso de execução |
| Decodificação | ChrisInsn |
Comprimento, larguras, operandos e operação são consistentes |
| Leitura | RAX e RBX antigos | Ambos são obtidos antes da substituição de RAX |
| Cálculo | Soma módulo 2⁶⁴ e flags | Overflow com sinal difere de carry sem sinal |
| Escrita | Novos RAX e RFLAGS | Campos não afetados preservam seus valores |
| Avanço | RIP mais três | Ocorre uma vez, salvo transferência de controle ou parada |
do_alu implementa a distinção entre formatos de operandos. Em CHRIS_FORM_RM_REG, lê o destino por chris_read_rm e a fonte por chris_read_regop. Como mod == 3, a primeira função também acessa o vetor de registradores gerais. chris_flags_bin recebe os dois valores antigos, a operação, a largura do operando e as flags anteriores; retorna as novas flags e fornece o resultado aritmético por um ponteiro de saída. Por fim, chris_write_rm grava o resultado. CMP e TEST calculam flags sem gravar o resultado no operando.
Se RAX contém todos os bits iguais a um e RBX contém um, o resultado armazenado é zero, CF fica ligado e ZF fica ligado. OF permanece desligado porque −1 mais 1, interpretados com sinal, é representável. Um mesmo padrão de bits fundamenta predicados distintos para comparações com e sem sinal. Desvios condicionais precisam consultar as flags adequadas, em vez de inferir ordenação com sinal usando apenas carry. O capítulo de aritmética e sua sonda verificam essas relações independentemente da decodificação de instruções.
Gerar endereço não significa ler memória
Um endereço efetivo normalmente combina base, índice escalado e deslocamento com sinal. chris_eff_addr calcula esse valor a partir dos campos decodificados. No endereçamento relativo a RIP, usa RIP inicial mais comprimento da instrução mais deslocamento. Nos demais casos, soma a base selecionada quando no_base está desligado, soma o índice deslocado por scale quando no_index está desligado e adiciona o deslocamento. Tamanho de endereço quatro trunca o resultado para 32 bits.
A função não lê o conteúdo da memória endereçada. do_lea usa o valor calculado diretamente como resultado de registrador. Um operando de memória convencional continua por chris_va_read ou chris_va_write, onde tradução e permissões podem causar falha. Essa diferença explica por que calcular um endereço e desreferenciá-lo são operações distintas tanto em C quanto em código de máquina. Também impede atribuir acesso ao cache de dados ou caminhada de tabelas a todo uso aritmético de LEA.
A implementação inspecionada não adiciona bases FS ou GS em chris_eff_addr. A existência de armazenamento para essas bases na estrutura arquitetural não demonstra participação no endereçamento. Uma afirmação sobre armazenamento local de thread precisa acompanhar o percurso completo, desde um prefixo de segmento até o cálculo do endereço efetivo, sem inferir suporte somente pela presença de um campo MSR.
Laço de execução e responsabilidade por RIP
cpu_run primeiro compara um breakpoint configurado com RIP. Busca e decodifica os bytes, formata a instrução e registra o trace, limpa rip_dirty e chama chris_execute. Se a execução retorna erro sem ter escolhido uma parada ou motivo de saída, registra saída por exceção. O avanço de RIP pelo comprimento decodificado ocorre somente quando rip_dirty está desligado e a CPU não está parada.
Essa flag transfere aos handlers a responsabilidade pelo fluxo não sequencial. Um desvio tomado grava o destino e marca RIP como alterado. Uma chamada também salva o endereço de retorno na pilha. Um retorno obtém o destino da memória usando o ponteiro da pilha. Assim, uma única operação conceitual pode alterar o fluxo e falhar em um acesso de dados. A correção depende da ordem desses efeitos, não apenas da soma de um deslocamento a RIP.
O trace é inserido antes da execução. Sua presença demonstra uma tentativa após a decodificação; não demonstra conclusão bem-sucedida da instrução. Da mesma forma, steps e tsc arquitetural são incrementados perto do fim do laço. Esses contadores pertencem à política do emulador e não medem ciclos de um pipeline x86 físico. max_steps limita iterações, não duração em segundos nem atividade elétrica dos transistores.
Exceções e necessidade de um ponto de efetivação
Uma exceção precisa permite identificar a instrução que falhou e recuperar a execução a partir de um estado arquitetural definido. Implementações frequentemente separam preparação de efetivação: leem e validam entradas, calculam resultados provisórios e depois tornam os efeitos observáveis conforme as regras da instrução. Esse é um contrato conceitual; escrever handlers em C não torna automaticamente suas operações transacionais.
Existe uma questão concreta de ordenação em do_alu: novas RFLAGS são atribuídas antes da tentativa de escrita no destino. Se o destino é memória e a escrita falha, as flags já foram alteradas. Documentar essa sequência é necessário para compreender o comportamento atual. Isso não significa que x86 permita efeitos parciais arbitrários em uma falta. Uma correção futura exige testes de ordem de falhas específicos das instruções, incluindo destinos em páginas legíveis, mas sem permissão de escrita.
fetch_insn também lê todos os 15 bytes possíveis antes de decodificar. Quinze é o comprimento máximo arquitetural, não a quantidade necessária para qualquer instrução. Uma instrução de um byte no fim de uma página executável pode levar esta implementação a acessar a página seguinte desnecessariamente. Se a próxima página é inacessível, a busca falha antes que o decoder aceite a instrução completa de um byte. Busca incremental ou uma estratégia limitada com contrato explícito podem resolver o problema; nenhuma delas é apresentada como já implementada.
Pipelines físicos e limites do interpretador
Um pipeline coloca registradores entre estágios combinacionais, permitindo que várias instruções ocupem estágios diferentes simultaneamente. Em uma máquina ideal de cinco estágios, cada um com duração t, sem esperas e admitindo uma instrução por ciclo, n instruções demoram aproximadamente (n + 4)t partindo do pipeline vazio. Uma máquina sem sobreposição, com os mesmos cinco estágios, demora aproximadamente 5nt. A primeira instrução continua atravessando cinco estágios; maior vazão não equivale a reduzir sua latência individual por cinco.
Dependências, desvios e latência de memória quebram esse cronograma ideal. Uma leitura após escrita depende do valor produzido anteriormente: é uma dependência verdadeira de dados. Conflitos de escrita após leitura e escrita após escrita podem resultar da reutilização dos nomes arquiteturais; renomear registradores pode removê-los sem remover dependências verdadeiras. Predição de desvios especula sobre o fluxo futuro, mas uma especulação incorreta não pode tornar-se estado arquitetural efetivado.
O laço inspecionado de ChrisCPU é um interpretador sequencial. Não modela ocupação de pipeline, buffer de reordenação, efeitos especulativos em cache ou renomeação de registradores. O processador hospedeiro pode usar esses mecanismos enquanto executa o interpretador, mas isso descreve a execução no hospedeiro, não uma microarquitetura emulada do convidado. Afirmações de desempenho precisam identificar qual máquina está sendo medida.
Ciclo de vida, interrupções e propriedade compartilhada
cpu_create rejeita máquina nula e máquina que já possui CPU, aloca armazenamento zerado, copia configurações de trace e breakpoint, reinicia o estado arquitetural e instala o ponteiro na máquina. Falha de alocação retorna antes da instalação. Isso estabelece uma relação de propriedade de uma CPU nesse construtor; o identificador de CPU não utilizado não demonstra execução multiprocessada.
cpu_reset reinicia a arquitetura e campos selecionados da execução, incluindo interrupção pendente e atraso de STI. Não reinicia toda a memória e todos os dispositivos da máquina. cpu_get e cpu_set copiam a estrutura arquitetural. cpu_shutdown marca a execução como parada e atribui motivo de desligamento; não libera a máquina. Essas operações possuem responsabilidades diferentes e não são substitutas umas das outras em uma aplicação que incorpora o emulador.
A injeção de interrupção grava uma flag pendente e um vetor. Uma segunda injeção pode substituir o vetor guardado; não existe nessa representação uma fila arbitrária de eventos pendentes. maybe_irq primeiro consome o atraso de STI, depois considera parada, pendência e IF. Ao aceitar a entrega, limpa a pendência e chama o caminho de exceções/interrupções. Não há sincronização entre threads hospedeiras visível nessas funções. A execução sequencial das instruções convidadas, por si só, não torna acessos concorrentes do hospedeiro seguros.
Evidência e escopo ainda aberto
A revisão declarada vincula essas observações aos arquivos indicados. Resultados da sonda aritmética se aplicam ao helper de flags; fixtures de decodificação e registradores se aplicam aos seus próprios contratos. Builds da documentação verificam links, metadados e geração; não inicializam ChrisOS nem certificam isolamento de privilégios. Os próximos capítulos precisam desenvolver encodings, aliases de registradores, paginação, verificações de privilégio, coerência de cache e operações atômicas para que mecanismos do kernel possam depender deles sem pré-requisitos ocultos.
A referência normativa é o conjunto de manuais de desenvolvimento da Intel, especialmente semântica de instruções e programação de sistemas. As equações de pipeline apresentadas são uma idealização analítica explícita. As observações sobre busca, cópia de estado e ordem de falhas resultam da inspeção do código, não de medições de hardware físico.