
Barramentos, I/O mapeado em memória e DMA
Sobre este capítulo Dispositivos e descoberta da plataforma
Neste capítulo
- Barramentos, I/O mapeado em memória e DMA
- Por que dispositivos alteram o modelo de memória
- Barramento como sistema de transações
- Endereço, dados e controle
- Mestres e alvos
- Três espaços de endereço
- Port-mapped I/O
- Memory-mapped I/O
- Tipo de memória de MMIO
- HHDM não é mapeador universal de dispositivo
- Janela MMIO do ChrisOS
- volatile e MMIO
- Largura de acesso faz parte do protocolo
- BAR como janela de dispositivo
- Cálculo de tamanho de BAR
- O que DMA remove do caminho da CPU
- Descritores DMA
- Memória de descritores é parte do protocolo
- Coerência de DMA
- DMA coerente e streaming
- Coerência não substitui ordenação
- Barreiras nas virtqueues do ChrisOS
- VIRTIO_F_ORDER_PLATFORM
- Doorbell não transporta o payload
- Contiguidade física
- Largura de endereço DMA
- Pool DMA32
- Bounce buffers
- ATA DMA no ChrisOS
- Exemplo PRDT
- DMA do AC97
- Helpers modernos de DMA
- Propriedade e lifetime
- Rings como máquinas de propriedade
- DMA e interrupções
- Corridas de conclusão
- MMIO posted writes
- Conclusão DMA não significa durabilidade
- IOMMU
- Scatter/gather
- Granularidade de cache em DMA
- DMA como fronteira de segurança
- hwgate como ponto de controle
- Limites atuais de BAR
- Limites atuais de DMA
- Modelo MMIO do ChrisVM
- Limite de largura MMIO no ChrisVM
- ChrisVM e DMA
- Transação DMA futura no ChrisVM
- Interação com o modelo de memória
- Por que volatile não basta em descritores
- MMIO em user mode
- Falhas e contenção de erro
- Aritmética reproduzível
- Exemplo de endereço PCI
- Exemplo de limite DMA32
- Separação de endereço 64-bit
- Limites de validação
- Gatilhos de revisão
- Referências primárias
Por que dispositivos alteram o modelo de memória
Um processador não opera isoladamente. Controladores de armazenamento, placas de rede, áudio, GPUs, controladores USB, controladores de interrupção e dispositivos descritos pelo firmware trocam comandos, estado e dados com o software. O caminho entre CPU e dispositivo não é apenas estado local de uma função. Ele atravessa barramentos e interconexões com regras próprias de endereçamento, transação, ordenação, largura e propriedade.
Três conceitos são fundamentais:
- um barramento ou interconexão transporta requisições e respostas entre agentes;
- memory-mapped I/O (MMIO) faz registradores de dispositivos ocuparem endereços do espaço físico da CPU;
- direct memory access (DMA) permite que um dispositivo leia ou escreva RAM sem a CPU copiar cada palavra do payload por um registrador de I/O.
O ChrisOS já utiliza os três. A configuração PCI descobre dispositivos e recursos. Janelas MMIO expõem capacidades modernas do VirtIO e o LAPIC. Buffers DMA transportam blocos ATA, amostras AC97, descritores VirtIO, quadros de rede e recursos gráficos.
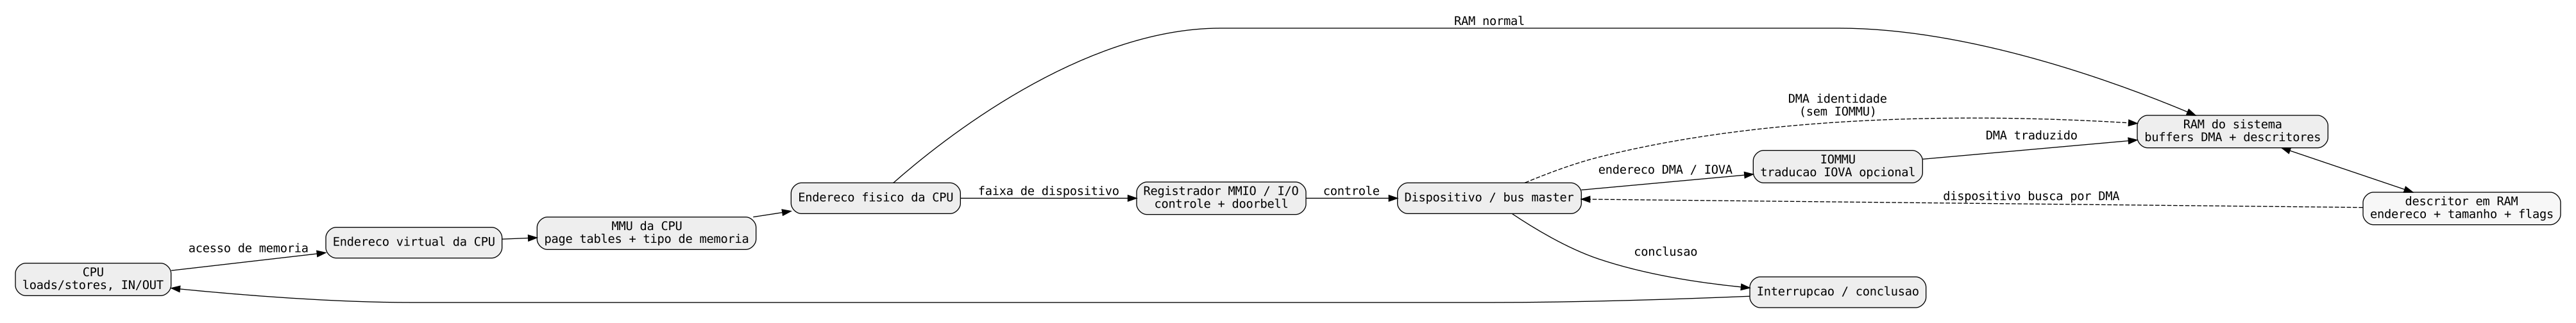
Um driver administra dois caminhos diferentes:
caminho de controle:
CPU -> instrução de I/O ou registrador MMIO -> dispositivo

caminho de dados:
dispositivo <-> endereço DMA -> RAM
Muitos bugs de drivers aparecem quando esses caminhos são confundidos.
Barramento como sistema de transações
A palavra histórica "barramento" sugere fios compartilhados. Plataformas modernas usam também enlaces ponto a ponto e fabrics com switches. A abstração útil é um sistema de transações.
Uma transação contém, conforme a arquitetura:
- identidade do solicitante;
- endereço ou destino decodificado;
- tipo de operação: leitura, escrita, configuração ou mensagem;
- largura e byte enables;
- payload;
- atributos de ordenação;
- conclusão ou estado de erro.
PCI clássico, PCI Express, controladores de memória e fabrics internos implementam esses conceitos de maneiras diferentes.
O software normalmente não conhece o trajeto elétrico exato até o dispositivo. Ele observa espaços de endereço e contratos arquiteturais.
Endereço, dados e controle
Um barramento compartilhado simplificado pode ser decomposto em:
| Classe | Função |
|---|---|
| endereço | seleciona posição ou alvo |
| dados | transporta o payload |
| comando/controle | diferencia leitura, escrita e configuração |
| arbitragem | escolhe qual mestre pode iniciar |
| conclusão/estado | informa sucesso, retry ou erro |
PCIe troca o barramento paralelo por pacotes seriais, mas a separação conceitual continua válida.
Mestres e alvos
A CPU não é necessariamente o único agente que inicia tráfego.
Um bus master inicia transações. Um dispositivo PCI com DMA se torna mestre quando lê ou grava memória do sistema. Um alvo responde às requisições.
Por isso o bit Bus Master do PCI importa. Um controlador pode expor seus registradores e ainda assim não ter permissão para iniciar DMA.
O ChrisOS habilita bus mastering em caminhos como pci_find_virtio_net, pci_find_ide e pci_find_ac97 antes do uso de DMA.
Três espaços de endereço
Software de baixo nível precisa distinguir pelo menos:
- endereço virtual da CPU — ponteiro usado pelo kernel;
- endereço físico da CPU — resultado da tradução de páginas;
- endereço DMA/bus — valor colocado em um descritor para o dispositivo.
Sem IOMMU, o endereço DMA pode ser igual ao físico.
Essa igualdade é uma propriedade da plataforma, não uma identidade universal.
Com IOMMU:
Uma arquitetura de DMA madura deve tratar o endereço visível ao dispositivo como um tipo conceitualmente diferente de um ponteiro da CPU.
O ChrisOS atual ainda não possui uma abstração IOMMU/IOVA. Seus helpers entregam endereços físicos diretamente aos dispositivos.
Port-mapped I/O
x86 possui um espaço separado de portas acessado por IN e OUT.
O ChrisOS o utiliza em serial legado, registradores ATA, mecanismo PCI #1 em 0xCF8/0xCFC, VirtIO PCI legado, AC97 e outros controladores.
I/O por portas não é um load/store comum. A própria instrução seleciona o espaço de I/O.
Exemplo:
Isso acessa configuração PCI, não RAM.
Memory-mapped I/O
MMIO coloca registradores de dispositivo no espaço físico de memória.
Um load pode acionar leitura de registrador. Uma store pode significar comando, acknowledge, doorbell ou configuração.
Embora a sintaxe se pareça com acesso a memória, a semântica é diferente.
Registradores podem ser:
- read-to-clear;
- write-one-to-clear;
- write-only;
- sensíveis à largura do acesso;
- atualizados assincronamente;
- dotados de efeitos colaterais;
- dependentes de ordem em relação a outros registradores ou DMA.
Por isso MMIO não pode ser tratado como RAM comum cacheada.
Tipo de memória de MMIO
Cachear registradores como write-back pode produzir comportamento incorreto: a CPU pode responder a um load pelo cache, combinar stores ou atrasar tráfego.
map_mmio_page do ChrisOS cria a página com:
A intenção é mapear a página como escrita permitida, não executável e com política de cache apropriada a I/O.
Em x86 moderno, PWT e PCD não definem sozinhos o tipo final. PAT e MTRR também participam. Logo, a afirmação precisa é: o ChrisOS solicita uma política orientada a uncached por PWT/PCD, mas um subsistema completo deve auditar explicitamente a combinação PAT/MTRR.
HHDM não é mapeador universal de dispositivo
bootinfo_phys_to_virt calcula atualmente:
Isso é adequado para RAM coberta pelo Higher-Half Direct Map.
Não significa que qualquer endereço físico possa ser desreferenciado com esse deslocamento.
O próprio boot do ChrisOS imprime que HHDM + 0xFEE00000 não constitui mapeamento MMIO válido para o LAPIC.
O LAPIC é acessado por map_mmio_page.
Somar o offset não substitui a criação da entrada de página com atributos corretos.
Janela MMIO do ChrisOS
map_mmio_page:
- exige endereço físico alinhado a 4 KiB;
- reserva a próxima página virtual da janela MMIO;
- cria o mapeamento com WRITE, PWT, PCD e NX;
- devolve o endereço virtual.
hw_bar_map chama essa função para páginas físicas consecutivas. Como a janela virtual também avança sequencialmente, um BAR se torna um intervalo virtual contíguo.
O alocador atual é monotônico. Não há unmap/reuso de janelas em hw_bar_map.
volatile e MMIO
hwgate armazena a janela como ponteiro volatile e acessa registradores com larguras específicas.
volatile impede que o compilador elimine acessos como se fossem memória comum. Não fornece por si só:
- fence de CPU;
- sincronização DMA;
- transação multi-registrador atômica;
- política de cache correta.
Esses problemas pertencem a camadas distintas.
Largura de acesso faz parte do protocolo
Um registrador de 32 bits nem sempre pode ser lido corretamente com quatro leituras de 8 bits.
O hwgate fornece:
e rejeita acessos desalinhados de 16 e 32 bits.
Isso preserva melhor a semântica do dispositivo do que tratar todo BAR como vetor de bytes.
BAR como janela de dispositivo
Base Address Registers do PCI descrevem recursos de I/O ou memória.
O capítulo pci-pcie aprofunda a configuração PCI. Aqui interessa a transformação de metadado de configuração em janela utilizável pela CPU.
hw_bar_map:
- lê o BAR;
- reconhece forma de 64 bits e lê o dword superior;
- forma a base física;
- desabilita temporariamente Memory Space;
- escreve bits 1 para sondar a máscara de tamanho;
- restaura BAR e Command;
- mapeia as páginas na janela MMIO.
Cálculo de tamanho de BAR
Para uma máscara convencional:
obtém-se o tamanho limpando bits de atributos, invertendo a máscara e somando um.
hw_bar_map acrescenta políticas específicas do projeto:
- máscara inválida -> fallback de 64 KiB;
- recurso menor que 64 KiB -> mapeia pelo menos 64 KiB;
- recurso maior que 64 páginas -> limita a 256 KiB.
Isso atende ao conjunto atual de dispositivos; não é um gerenciador genérico de recursos PCI.
Outro limite: a sondagem de tamanho é essencialmente feita pelo dword inferior. Um gerenciador completo de BARs de 64 bits deve considerar a máscara completa e o pareamento entre BARs.
O que DMA remove do caminho da CPU
Sem DMA, um fluxo poderia ser:
registrador do dispositivo -> registrador da CPU -> RAM
registrador do dispositivo -> registrador da CPU -> RAM
...
Com DMA:
CPU:
  prepara buffer
  programa endereço e tamanho
  inicia controlador

dispositivo:
  transfere diretamente entre RAM e dispositivo

CPU:
  observa conclusão
A CPU ainda coordena o protocolo, mas deixa de copiar cada palavra do payload.
Descritores DMA
O dispositivo precisa saber onde está o buffer, seu tamanho e direção.
Um descritor genérico contém:
No ChrisOS aparecem diferentes formas:
- PRDT do ATA bus-master;
- BDL do AC97;
- descriptor/avail/used do VirtIO;
- PRDT do AHCI;
- filas e PRPs do NVMe.
O padrão é o mesmo: software escreve estruturas em RAM que descrevem acessos futuros iniciados pelo dispositivo.
Memória de descritores é parte do protocolo
Sequência típica de submissão:
1. preencher payload
2. preencher descritor
3. ordenar escritas anteriores
4. publicar índice/descritor
5. tocar doorbell/notificar dispositivo
Conclusão:
1. observar estado/índice de conclusão
2. ordenar escritas do dispositivo quando necessário
3. consumir payload/estado
4. reciclar descritor
Uma fila de DMA é estrutura de dados e protocolo de sincronização.
Coerência de DMA
Existem duas perguntas independentes.
Endereço
O dispositivo consegue alcançar o endereço colocado no descritor?
Depende de:
- largura de endereço do dispositivo;
- bridges;
- IOMMU;
- DMA mask;
- restrições de memória baixa.
Cache
Quando CPU e dispositivo acessam os mesmos bytes, os caches da CPU participam de coerência com DMA?
Em plataformas x86 usuais a RAM de sistema é coerente com DMA. Em outras arquiteturas pode ser necessário clean/invalidate explícito.
Endereço válido não implica automaticamente visibilidade correta de cache.
DMA coerente e streaming
Uma abstração útil separa:
DMA coerente — estruturas de controle podem ser compartilhadas sem manutenção explícita de cache a cada transferência, embora barreiras de ordem continuem necessárias.
streaming DMA — um buffer comum é temporariamente entregue ao dispositivo e pode exigir operações de cache em plataformas não coerentes.
O ChrisOS atual usa páginas físicas comuns e depende do ambiente x86/QEMU coerente. Não possui APIs distintas para os dois casos.
Coerência não substitui ordenação
Mesmo memória coerente pode exigir barreira.
É possível que descritores e payload estejam coerentes, mas que a notificação ao dispositivo seja observada antes de todas as escritas anteriores.
VirtIO define requisitos de ordenação para publicação e notificação.
Barreiras nas virtqueues do ChrisOS
kernel/gfx/virtq.c possui vq_mb.
Em x86 ele emite MFENCE com clobber de memória do compilador.
virtq_publish usa barreiras ao redor da publicação no available ring.
O caminho antigo virtio_net, entretanto, define vio_mb apenas como barreira do compilador.
Esse contrato é mais estreito. Ele tem sido suficiente no caminho x86/QEMU atual, mas não deve ser tomado como barreira universal para hardware e outras arquiteturas.
Uma evolução correta deve centralizar a política de barreiras no transporte VirtIO.
VIRTIO_F_ORDER_PLATFORM
VirtIO 1.3 define VIRTIO_F_ORDER_PLATFORM.
Quando negociado, o driver precisa usar a ordenação adequada à plataforma real.
Quando não negociado, a especificação permite hipóteses compatíveis com dispositivos implementados em software e barreiras mais fracas.
Isso importa porque o ChrisOS precisa funcionar progressivamente em:
- QEMU;
- hardware PCI real;
- ChrisVM.
Uma estratégia que funciona em QEMU não é automaticamente suficiente em hardware.
Doorbell não transporta o payload
No VirtIO, notificar a fila não envia o pedido inteiro.
O dispositivo recebe o aviso e então acessa a RAM por DMA.
Essa separação é a base de dispositivos de fila de alto desempenho.
Contiguidade física
Memória virtualmente contígua pode ser fisicamente fragmentada.
Se o dispositivo exige região física contígua, um malloc virtual não basta.
hw_dma_alloc chama pmm_alloc_contig e registra:
São duas visões da mesma RAM para agentes diferentes.
Largura de endereço DMA
Dispositivos antigos podem ter somente 32 bits de endereço.
Sem remapeamento, isso limita DMA a:
O ChrisOS reserva um pool DMA32 e fornece pmm_alloc_dma32/hw_dma_alloc_low.
A motivação atual aparece no próprio código: UHCI precisa de memória abaixo de 4 GiB no caminho suportado.
Por isso um alocador genérico não pode entregar qualquer página para qualquer controlador.
Pool DMA32
pmm_reserve_dma32 procura um run utilizável que termine abaixo de PMM_DMA32_LIMIT.
Dentro desse run um bitmap pequeno controla páginas livres.
Isso evita depender da sorte de pmm_alloc retornar memória baixa.
Uma camada futura deve declarar a DMA mask de cada dispositivo, não apenas distinguir "normal" e "DMA32".
Bounce buffers
Bounce buffer adapta um buffer comum às restrições do hardware.
write:
buffer do chamador -> cópia CPU -> bounce DMA -> dispositivo

read:
dispositivo -> bounce DMA -> cópia CPU -> buffer do chamador
Há custo de cópia, mas o driver controla endereço e alinhamento.
O ATA DMA do ChrisOS utiliza esse modelo.
ATA DMA no ChrisOS
ata_dma_acquire mantém:
- região contígua para até 8192 bytes;
- página para PRDT.
O código rejeita endereços físicos acima de 0xFFFFFFFF.
ata_dma_xfer:
- copia dados de escrita para o bounce;
- monta PRDT;
- programa endereço físico do PRDT;
- limpa estado;
- programa comando ATA;
- inicia DMA;
- espera IRQ/status;
- em leitura, copia o bounce ao chamador.
Isso separa claramente o buffer da API do buffer acessível ao dispositivo.
Exemplo PRDT
O código atual escreve:
Para 8192 bytes:
O bit alto marca fim da tabela no formato usado pelo driver.
DMA do AC97
AC97 aloca uma página para áudio e outra para BDL.
A BDL recebe o endereço físico do payload e o controlador recebe o endereço físico da BDL.
É um exemplo direto de:
Existe uma limitação atual relevante: os endereços físicos são gravados em campos de 32 bits, mas as páginas vêm do PMM geral sem validação explícita de DMA32.
No QEMU atual elas permanecem baixas. Em hardware com páginas alocadas acima de 4 GiB poderia ocorrer truncamento.
A correção arquitetural é transformar isso em requisito explícito de endereçamento DMA.
Helpers modernos de DMA
hwgate fornece:
Cada slot registra endereço físico, endereço virtual HHDM, páginas e estado.
Drivers modernos como virtio-blk podem gravar os 64 bits completos como low/high.
Esse padrão é mais robusto que truncar implicitamente ponteiros ou físicos para 32 bits.
Propriedade e lifetime
Um dispositivo pode continuar acessando memória depois que a função do driver retornou.
Logo, não se pode liberar o buffer apenas porque a CPU terminou de usá-lo localmente.
alocar
preparar
publicar
dispositivo possui/pode acessar
conclusão/cancelamento
dispositivo não acessa mais
reciclar/liberar
Liberar antes da conclusão equivale a hardware realizando use-after-free.
Rings como máquinas de propriedade
No VirtIO:
driver possui descritor/buffer
        |
        | publica em avail
        v
dispositivo possui request
        |
        | escreve used
        v
driver pode recuperar
Os índices definem fronteiras de propriedade, não apenas contagem.
O mesmo raciocínio se aplica a NVMe e outras filas.
DMA e interrupções
Interrupção normalmente informa progresso ou conclusão; ela não move o payload.
Fluxo:
CPU prepara descritor
CPU notifica
dispositivo executa DMA
dispositivo escreve conclusão
dispositivo gera IRQ
CPU reconhece
CPU consome conclusão
Polling muda a forma de observar a conclusão, não o protocolo de memória.
Corridas de conclusão
A operação pode concluir antes do primeiro poll da CPU.
O ChrisOS já encontrou esse bug no ATA DMA. ata_dma_wait atual aceita o bit de conclusão mesmo quando já está ativo na primeira leitura.
Exigir observar primeiro "não concluído" e depois "concluído" é incorreto se a especificação não garante que a transição será amostrada.
Drivers devem raciocinar por estados estáveis, não por tempo esperado.
MMIO posted writes
Interconexões podem permitir stores MMIO postadas: a CPU aposenta a escrita antes de ela alcançar fisicamente o periférico.
Quando o driver precisa confirmar que uma escrita chegou, pode ser necessário readback específico do dispositivo ou mecanismo arquitetural apropriado.
Uma fence genérica não significa universalmente "o periférico consumiu o comando".
Por isso manuais de hardware definem sequências precisas.
Conclusão DMA não significa durabilidade
DMA concluído significa que a transferência de memória terminou segundo o controlador.
Não significa necessariamente que dados chegaram ao meio não volátil.
Armazenamento pode possuir caches voláteis e exigir flush explícito.
O ATA do ChrisOS emite flush após as escritas. O capítulo de armazenamento trata a semântica de persistência.
IOMMU
IOMMU traduz endereços visíveis ao dispositivo e aplica permissões.
Benefícios:
- isolamento entre dispositivos e memória;
- IOVA contígua sobre páginas físicas fragmentadas;
- adaptação de limitações de largura;
- proteção contra DMA incorreto ou malicioso;
- virtualização.
Sem IOMMU, um dispositivo bus-master programado com endereços arbitrários pode acessar grandes partes da RAM.
O ChrisOS atual não possui subsistema IOMMU. Endereço DMA é tratado como físico. Isso é uma fronteira explícita de confiança.
Scatter/gather
Alocações fisicamente grandes e contíguas são caras e sofrem fragmentação.
Scatter/gather permite:
e o dispositivo percorre segmentos.
VirtIO chains, AHCI PRDT, NVMe PRP/SGL e descritores de rede são variações desse princípio.
hw_dma_alloc ainda prefere runs físicos contíguos. Uma camada futura deve separar "endereçável por DMA" de "fisicamente contíguo".
Granularidade de cache em DMA
Em sistemas não coerentes, clean/invalidate atua por linhas de cache.
Se um buffer DMA compartilha linha com dados não relacionados, a manutenção pode afetar bytes que não pertencem ao buffer.
APIs portáveis cuidam de alinhamento, direção e transferência de propriedade.
O ChrisOS atual usa páginas e tem alinhamento amplo, mas ainda não implementa manutenção para plataformas DMA não coerentes.
DMA como fronteira de segurança
DMA ignora o caminho comum de loads/stores da CPU.
Um dispositivo mal programado pode sobrescrever page tables, código do kernel, memória de processos ou filas de outro dispositivo.
IOMMU, reset de dispositivo, validação de descritores e lifetime rigoroso são mecanismos de segurança.
Uma evolução para hardware real deve tratar a capacidade DMA como recurso privilegiado.
hwgate como ponto de controle
hwgate centraliza operações sensíveis:
- mapear BAR;
- ler/escrever MMIO com largura controlada;
- alocar slots DMA;
- expor low/high do endereço;
- limitar acesso ao tamanho do slot.
Isso pode se tornar base para um modelo de capabilities.
Atualmente ainda é infraestrutura interna do kernel, não uma fronteira de isolamento comparável a um domínio IOMMU.
Limites atuais de BAR
hw_bar_map usa:
Assim:
- existem no máximo oito janelas registradas;
- cada janela é limitada a 256 KiB;
- não há reaproveitamento;
- sizing é simplificado.
São limites da implementação atual, não do PCI.
Limites atuais de DMA
hwgate usa:
No máximo 32 slots são acompanhados e um pedido individual pode chegar a 2048 páginas.
Como a alocação usa pmm_alloc_contig, fragmentação pode causar falha mesmo com memória livre suficiente.
Segmentação/scatter-gather deve fazer parte da futura camada DMA.
Modelo MMIO do ChrisVM
ChrisVM possui uma tabela de roteamento MMIO.
chris_mmio_map registra:
- base física;
- tamanho;
- callback de leitura;
- callback de escrita;
- contexto do dispositivo.
chris_phys_read/write verificam primeiro RAM e framebuffer. Fora dessas áreas, procuram uma janela MMIO e chamam o dispositivo.
acesso fisico do guest
        |
        +-- RAM -> backing de RAM
        |
        +-- framebuffer -> backing gráfico
        |
        +-- MMIO -> callback do dispositivo
Isso representa o decodificador de endereços físicos da máquina virtual.
Limite de largura MMIO no ChrisVM
Para MMIO, chris_phys_read/write atualmente iteram byte a byte e chamam o callback com largura 1.
Isso é simples, mas pode ser semanticamente diferente de uma única leitura de 32 bits.
Quatro reads de 8 bits podem acionar quatro efeitos colaterais onde o hardware real faria um.
Para fidelidade, o ChrisVM precisa preservar a largura arquitetural do acesso sempre que possível e rejeitar splits não suportados pelo dispositivo.
ChrisVM e DMA
O ChrisVM atual ainda não possui um subsistema genérico de DMA iniciado pelo dispositivo/IOMMU.
Uma arquitetura completa precisa de:
- API explícita dma_read/dma_write;
- tradução de endereço DMA;
- validação de largura/mask;
- agendamento determinístico da conclusão;
- ordenação em relação a doorbells MMIO;
- modelo de faults;
- IOMMU opcional;
- trace/replay de transações DMA.
Sem isso, o ChrisVM pode modelar registradores, mas ainda não substitui fielmente o QEMU para controladores fortemente dependentes de DMA.
Transação DMA futura no ChrisVM
Um modelo determinístico pode usar:
dispositivo
  -> dma_read/dma_write(iova, tamanho)
  -> IOMMU ou tradução identidade
  -> memória física do guest
  -> evento de conclusão
O scheduler define quando a alteração se torna visível em relação aos passos das CPUs e IRQs.
Isso torna corridas reproduzíveis em vez de dependentes do timing de threads do host.
Interação com o modelo de memória
Com DMA há um observador adicional:
CPU escreve descritor
        |
        v
barreira
        |
        v
doorbell MMIO
        |
        v
dispositivo lê por DMA
        |
        v
dispositivo escreve conclusão
        |
        v
IRQ/status
        |
        v
CPU lê
Cada aresta precisa de uma regra definida.
Coerência de cache entre CPUs não descreve sozinha esse grafo.
Por que volatile não basta em descritores
volatile não garante:
- clean de cache em plataforma não coerente;
- validade do endereço DMA;
- barreira antes da notificação;
- propriedade correta;
- largura da transação;
- mapping IOMMU;
- ordenação da conclusão.
Correção de DMA depende de API e protocolo.
MMIO em user mode
Um sistema operacional mais maduro pode mapear BARs em processos de usuário.
Isso exige:
- capabilities/permissões;
- atributos de página;
- validação de range;
- revogação;
- isolamento DMA por IOMMU;
- mecanismo de IRQ.
Permitir MMIO sem restringir DMA pode dar ao processo meios de programar o dispositivo para acessar RAM arbitrária.
MMIO e isolamento DMA são problemas de segurança acoplados.
Falhas e contenção de erro
Dispositivos podem falhar por ausência de hardware, transação não suportada, timeout, descritor inválido, DMA inválido, fault de IOMMU, reset ou hot unplug.
Drivers precisam de waits finitos e caminhos de recuperação.
O ChrisOS já usa polling limitado em ATA e VirtIO. Uma camada comum deve padronizar timeout, reset e diagnóstico.
Aritmética reproduzível
scripts/check_bus_dma_examples.py valida:
- codificação do endereço PCI config mechanism #1;
- cálculo de tamanho por máscara de BAR;
- limite DMA32 considerando o último byte;
- decomposição/recomposição low/high de 64 bits;
- encoding do PRDT ATA;
- offsets de uma split virtqueue.
Não são testes de conformidade de hardware. Eles tornam os exemplos numéricos auditáveis.
Exemplo de endereço PCI
pci_read/write formam:
bit 31      = enable
bits 23:16  = bus
bits 15:11  = device
bits 10:8   = function
bits 7:2    = dword
bits 1:0    = zero
Bus 2, device 5, function 3, offset 0x14:
O checker confirma o valor.
O capítulo pci-pcie diferencia esse mecanismo legado do ECAM do PCIe.
Exemplo de limite DMA32
Para um dispositivo de 32 bits:
cabe exatamente.
Mas:
não cabe.
Validar apenas o endereço inicial é insuficiente.
Separação de endereço 64-bit
Para:
a recomposição é:
hw_dma_lo/hw_dma_hi implementam esse padrão.
Limites de validação
Este capítulo foi reconciliado com ChrisOS main da3df29cb397932c43d32373871fb9380e688ade.
Ele não afirma que o ChrisOS possua hoje:
- IOMMU geral;
- manutenção de cache para DMA não coerente;
- sizing completo de BARs de 64 bits;
- hot-plug genérico;
- portabilidade arbitrária de hardware;
- fidelidade completa de DMA no ChrisVM.
Esses pontos são requisitos explícitos de evolução.
Gatilhos de revisão
Revisar quando mudarem:
- atributos de map_mmio_page/PAT/MTRR;
- hw_bar_map;
- reserva DMA32;
- API hw_dma_*;
- barreiras VirtIO;
- endereçamento ATA/AC97;
- IOMMU;
- largura MMIO no ChrisVM;
- DMA iniciado por dispositivos no ChrisVM.
Referências primárias
- Intel 64 and IA-32 Architectures Software Developer's Manual, tipos de memória e MMIO.
- Virtual I/O Device (VIRTIO) Version 1.3, virtqueues, notificações e ordenação.
- Linux kernel DMA API documentation, endereços DMA, mappings coerentes/streaming, masks e IOMMU.
- Os detalhes de configuração e BARs são aprofundados no capítulo pci-pcie.