
TLB shootdown, fencing de CPUs e reclamation segura de frames
Sobre este capítulo Concorrência e propriedade de recursos
Neste capítulo
- TLB shootdown, fencing de CPUs e reclamation segura de frames
- Escopo
- Por que um lock normal não resolve
- Consumidor atual mais concreto: teardown do JIT
- Modelo de dados do protocolo
- Inicialização e membership
- Publicação de geração
- API de intervalo
- Serialização dos shootdowns
- Por que não se espera por ack segurando mm_lock
- Seleção de targets
- Entrega LAPIC
- Handler remoto do IPI
- Poll fora do handler
- Heartbeats
- Estados de retorno de tlb_wait_step
- Fencing por silêncio
- Fencing forçado adicional
- O que mm_tlb_retire_mask realmente faz
- Stop cooperativo da CPU fenced
- Suporte a NMI existe, mas não é o mecanismo ativo de entrega
- Predicado de segurança de reuse
- Quarentena
- Overflow da quarentena
- Espera final
- Ack e halt são estados diferentes
- CPU fenced não volta online automaticamente
- Wrap da geração
- Modelo de memory ordering
- Falha no envio de IPI
- Complexidade
- Modelo de falha e recuperação
- Evidência de validação
- O que os testes host não provam
- Resumo de locks e liveness
- Restrições arquiteturais atuais
- Direção futura
- Fronteira de revisão
Escopo
TLB shootdown é o protocolo de coordenação usado quando uma mudança de tradução realizada por uma CPU precisa tornar-se efetiva em outras CPUs antes que a memória física possa ser reutilizada com segurança.
O problema principal não é apenas “fazer todas as CPUs enxergarem a nova PTE”. O caso difícil é teardown:
remover mapping
    |
    | traduções antigas ainda podem existir remotamente
    v
provar que todas as CPUs relevantes perderam o acesso antigo
    |
    v
reutilizar a memória física de backing
O ChrisOS implementa isso com protocolo explícito contendo:
- gerações;
- estados de membership por CPU;
- intervalo virtual publicado;
- polling local e remoto;
- entrega de IPI LAPIC no vetor 0xF0;
- acknowledgement por CPU;
- heartbeat para detectar progresso;
- fencing de CPUs que não reconhecem a geração;
- exigência de flush e halt para CPUs fenced antes de liberar reuse;
- quarentena de frames quando a segurança de reuse ainda não foi provada.
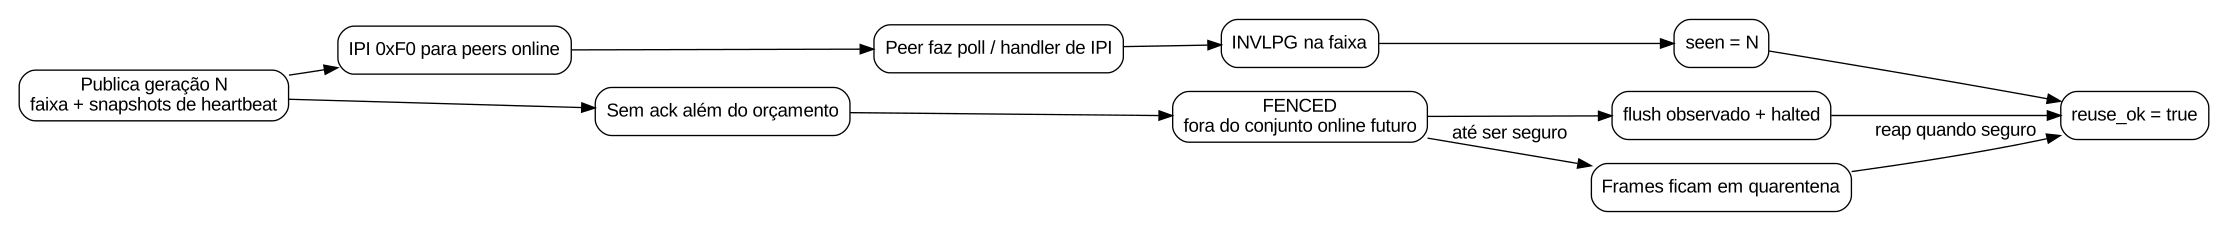
Este capítulo documenta o source presente na revisão e05a17fd76333114a3fb5c2452f38ca747d4ac56 e distingue comportamento executado de comentários antigos ou código de suporte atualmente não invocado.
Por que um lock normal não resolve
mm_lock serializa mutações da page table.
Considere CPU 0 removendo uma PTE sob lock, liberando o lock e devolvendo a frame ao PMM.
CPU 1 não precisa adquirir mm_lock para continuar usando uma tradução já cacheada pelo hardware.
Logo:
O lock protege a estrutura central.
Shootdown protege o lifetime das referências derivadas daquela estrutura.
É o mesmo princípio de reclamation concorrente: remover um objeto de um índice compartilhado não prova que todos os executores abandonaram referências antigas.
Consumidor atual mais concreto: teardown do JIT
jit_free é o exemplo mais direto.
O alias executável do JIT fica em uma região virtual alta compartilhada de kernel, e seu backing físico pode ter sido usado por trabalho executado em CPUs diferentes.
A sequência é:
- remover cada PTE executável com unmap_4k;
- executar INVLPG local em cada página por meio de unmap_4k;
- chamar mm_tlb_shootdown_range para o intervalo completo;
- se o shootdown provar reuse-safe, devolver as frames ao PMM;
- caso contrário, colocar as frames em quarentena.
A reclamation física é condicional ao resultado da sincronização.
Essa é a invariante central do design.
Modelo de dados do protocolo
tlb_proto.h define:
e três estados:
| Estado | Significado |
|---|---|
| TLB_CPU_ABSENT | slot não participa do protocolo |
| TLB_CPU_ONLINE | CPU participa das gerações atuais/futuras |
| TLB_CPU_FENCED | CPU saiu do conjunto online e precisa completar stop seguro antes de permitir reuse |
Cada TlbCpu armazena:
- state;
- seen;
- heartbeat;
- halted;
- flushed.
TlbWorld possui:
- array de CPUs;
- geração atual;
- base virtual publicada;
- quantidade de bytes;
- snapshots de heartbeat;
- quiet counters;
- quiet limit;
- flag published;
- reuse_ok.
O protocolo separa explicitamente membership, progresso, acknowledgement e segurança de reclamation.
Inicialização e membership
mm_init chama tlb_runtime_init.
Todos os slots começam ABSENT.
CPU 0 é marcada ONLINE e o runtime passa a ready.
APs entram posteriormente.
Em smp.c, quando um AP já trocou para sua stack própria e completou setup essencial, ap_c_entry chama:
antes de entrar no worker permanente.
O conjunto de membros de TLB não é derivado apenas de cpu_online_count.
Existe estado por slot dentro do próprio protocolo.
mm.c também possui:
garantindo que toda posição de CPU da camada SMP possa ser representada no protocolo.
Publicação de geração
tlb_publish é a operação pura da máquina de estados por trás de tlb_runtime_publish.
A publicação:
- grava virt;
- grava bytes;
- executa compiler barrier;
- incrementa gen;
- evita que zero seja usado depois de wrap;
- marca published;
- captura heartbeat de cada CPU;
- zera quiet counters;
- garante que self esteja ONLINE;
- marca self.seen = gen;
- recalcula reuse_ok.
A CPU iniciadora é considerada atual porque mm_tlb_shootdown_range executa a invalidação local antes de publicar a geração.
A ordem é:
Isso evita reconhecer trabalho local antes de executá-lo.
API de intervalo
mm_tlb_shootdown_range recebe:
Quando MM está pronta e bytes != 0:
- executa mm_invlpg_span localmente;
- inicia o protocolo compartilhado com o mesmo intervalo.
No teardown normal do JIT, a CPU iniciadora invalida localmente duas vezes:
- unmap_4k já executa INVLPG por página;
- mm_tlb_shootdown_range percorre novamente toda a faixa.
É redundância conservadora.
O custo é maior, mas torna explícito que o initiator está limpo antes da publicação.
Serialização dos shootdowns
Existe apenas um payload global de geração/range em TlbWorld.
Por isso duas publicações simultâneas não podem escrever esse estado livremente.
ChrisOS usa:
como flag de serialização.
tlb_shoot_lock tenta adquirir a flag com CAS.
Enquanto espera:
- executa mm_tlb_poll;
- executa PAUSE;
- tenta novamente.
Uma CPU esperando para iniciar seu próprio shootdown pode ser, ao mesmo tempo, participante obrigatório do shootdown de outra CPU.
Por isso o wait loop continua processando protocolo.
Essa flag é independente de mm_lock.
Por que não se espera por ack segurando mm_lock
O source contém aviso explícito de deadlock.
O initiator não deve segurar mm_lock enquanto espera acknowledgement remoto.
Uma CPU remota pode receber interrupção ou executar código que precisa entrar em MM.
Se CPU 0 mantiver mm_lock e esperar CPU 1, enquanto CPU 1 precisa de mm_lock antes de avançar até o ack, existe circular wait.
A implementação separa:
- mutação de page table sob mm_lock;
- release de mm_lock;
- serialização do shootdown com mm_tlb_busy;
- ack remoto sem aquisição de mm_lock.
Essa é uma invariante concreta de lock ordering.
Seleção de targets
tlb_runtime_ipi_targets percorre os slots do protocolo.
Uma CPU entra na lista apenas quando:
- não é self;
- state == ONLINE;
- seen != gen;
- há espaço no array de saída.
O código não assume conjunto online como prefixo denso.
Isso é necessário depois de fencing.
Exemplo:
Uma geração futura ainda precisa atingir CPU 2.
O teste test_hole_is_not_a_prefix valida esse caso.
Entrega LAPIC
Para cada target, mm_tlb_shootdown_with consulta smp_lapic_of.
Se o LAPIC ID é conhecido, chama:
apic_ipi programa o ICR e espera o delivery-status bit limpar, com limite de spins.
O retorno dessa função é atualmente ignorado pelo initiator.
Isso significa que o IPI é um mecanismo de aceleração de progresso, não a evidência final de sucesso.
A prova continua baseada em seen/gen e estados de CPU.
Handler remoto do IPI
irq_dispatch reconhece 0xF0 antes do retorno genérico de vetores altos.
O caminho é:
mm_tlb_poll chama mm_tlb_poll_cpu para a CPU corrente.
O poll:
- verifica se a CPU ainda não viu a geração;
- incrementa heartbeat;
- se houver trabalho, executa mm_invlpg_span;
- executa ack;
- se estiver na CPU 0, tenta reap da quarentena.
O acknowledgement ocorre depois da invalidação no caminho de poll.
Poll fora do handler
O protocolo não depende exclusivamente de IPIs.
TLB polling ocorre em:
- mm_enter enquanto espera mm_lock;
- tlb_shoot_lock enquanto espera outro shootdown;
- loops de espera do desktop;
- job workers;
- handler 0xF0.
AP workers executam poll repetidamente durante sua vida normal.
Isso cria várias oportunidades de progresso mesmo quando interrupção é atrasada ou quando o sistema ainda está em fase transitória de inicialização.
Heartbeats
Cada mm_tlb_poll_cpu incrementa o heartbeat da CPU.
No momento da publicação, tlb_publish copia os valores para hb_snap.
tlb_wait_step compara heartbeat atual com o snapshot.
Se mudou:
- atualiza hb_snap;
- zera quiet.
Se não mudou:
- incrementa quiet até saturação.
Heartbeat significa que a CPU continua executando o protocolo.
Não significa que ela já executou o ack da geração.
Uma CPU pode avançar heartbeat e ainda assim permanecer com seen antigo.
Estados de retorno de tlb_wait_step
| Retorno | Semântica |
|---|---|
| 0 | todas as CPUs ONLINE viram a geração |
| 1 | ainda existe CPU ONLINE sem ack |
| 2 | CPUs silenciosas foram fenced e não restou ONLINE atrasada |
Retorno 2 não significa necessariamente reuse seguro.
Uma CPU fenced ainda precisa ter:
Fencing remove a CPU do conjunto de espera online, mas não elimina automaticamente o risco de stale translation.
Fencing por silêncio
tlb_wait_step pode colocar em FENCED uma CPU cujo quiet counter ultrapasse quiet_limit.
O runtime usa:
Ao ser fenced:
- state muda ONLINE -> FENCED;
- halted = 0;
- flushed = 0;
- gerações futuras deixam de tratá-la como ONLINE.
O initiator recebe uma bitmask com os slots recém-fenced.
mm_tlb_retire_mask processa essa mask.
Fencing forçado adicional
Existe um segundo limite em mm_tlb_shootdown_with.
O initiator mantém um contador global de spins.
Se o protocolo continuar em estado 1 depois de mais de 2.000.000 iterações:
é chamado.
Isso coloca em FENCED todas as outras CPUs ONLINE que ainda não deram ack, ignorando quiet individual.
O caso que motiva esse mecanismo está no comentário do source: uma CPU pode continuar heartbeating, impedindo quiet de expirar, mas nunca reconhecer a geração.
Existem, portanto, dois mecanismos:
- silêncio por CPU;
- limite global de espera por falta de ack.
O que mm_tlb_retire_mask realmente faz
Esse é um ponto de reconciliação importante.
mm_tlb_retire_mask percorre a bitmask, registra o evento e chama:
smp_retire_cpu apenas decrementa cpu_online_count, mantendo mínimo de 1.
O parâmetro cpu não é usado para manter bitmap exato.
O comentário de smp.h esclarece que o membership autoritativo para shootdown é o conjunto do protocolo TLB, não o contador agregado.
Mais importante: o caminho ativo de mm_tlb_retire_mask não envia NMI.
Existe apic_ipi_nmi e existe handler NMI compatível com stop de TLB, porém não há chamada ativa a apic_ipi_nmi no caminho de shootdown da revisão analisada.
Um comentário de header ainda afirma que CPU não responsiva “receives an NMI”. Esse texto não corresponde ao caminho atualmente executado.
O mecanismo ativo é fencing cooperativo observado pelo worker.
Stop cooperativo da CPU fenced
job_worker_forever verifica:
no topo do loop.
Se verdadeiro:
- executa mm_tlb_poll_cpu(cpu_index);
- executa tlb_runtime_mark_halted(cpu_index);
- desabilita interrupções;
- entra em HLT infinito.
O passo 1 é obrigatório.
Como a CPU está fenced e ainda tem seen antigo, o poll executa INVLPG sobre a faixa publicada e o ack marca flushed = 1 para CPU fenced.
Depois mark_halted coloca halted = 1.
Somente com ambos verdadeiros reuse_ok pode liberar reclamation.
O helper puro tlb_cpu_stop modela essas duas ações de uma vez.
Suporte a NMI existe, mas não é o mecanismo ativo de entrega
idt_stubs.asm contém nmi_entry.
mm_tlb_nmi_stop:
- executa mm_tlb_poll_cpu;
- marca halted;
- devolve 0 se for BSP;
- devolve nonzero para AP, permitindo que o stub a interrompa permanentemente.
apic.c também contém apic_ipi_nmi.
Entretanto, não há chamada de shootdown para apic_ipi_nmi no source revisado.
A afirmação correta é:
- existe infraestrutura de stop via NMI;
- o fencing ativo depende do worker perceber state == FENCED;
- não se deve documentar que um CPU travado recebe NMI hoje.
Isso cria uma limitação de liveness: CPU verdadeiramente presa fora do worker pode ficar fenced sem completar halted/flushed.
Predicado de segurança de reuse
recompute_reuse implementa a regra formal.
Reuse permanece bloqueado quando:
- alguma CPU ONLINE tem seen != gen;
- alguma CPU FENCED não possui halted e flushed.
Forma lógica:
ABSENT não adiciona obrigação.
Esse predicado é mais forte que “todo mundo online deu ack”.
A CPU fenced continua pertencendo à prova de reclamation até completar stop seguro.
Quarentena
Quando mm_tlb_shootdown_range retorna -1, não foi possível provar reuse imediato.
jit_free chama mm_tlb_quarantine.
A quarentena guarda pares:
em arrays fixos com:
Se reuse já for seguro, a função libera imediatamente.
Caso contrário, registra a extensão.
Quando tlb_runtime_reuse_ok se torna verdadeiro, mm_tlb_reap devolve todas as extensões ao PMM.
CPU 0 tenta reap dentro de mm_tlb_poll_cpu.
Isso converte uma prova incompleta em reclamation atrasada, não em reuse inseguro.
Overflow da quarentena
A quarentena comporta 128 extents.
Ao lotar, mm_tlb_quarantine imprime:
e retorna sem liberar a nova extensão.
Isso pode provocar leak de memória física.
Entretanto, evita devolver ao allocator uma frame que talvez continue alcançável por stale translation.
O failure mode prefere perda de capacidade a corrupção.
Uma implementação de produção precisaria de estratégia escalável ou recovery explícito.
Espera final
Depois do fencing, mm_tlb_shootdown_with executa outra espera limitada:
Esse loop não faz polling remoto por conta própria.
Se reuse se tornar seguro, retorna 0.
Se o limite for atingido, retorna -1.
O chamador pode então colocar backing físico em quarentena.
Esse bound impede espera infinita pela parada cooperativa de uma CPU fenced.
Ack e halt são estados diferentes
O teste test_halt_without_invlpg_blocks_reuse deixa a regra explícita.
CPU fenced que apenas haltou, sem provar invalidação, continua bloqueando reuse.
Ack também não reativa CPU fenced.
A sequência validada é:
A segurança não depende simplesmente de reduzir cpu_online_count.
CPU fenced não volta online automaticamente
tlb_cpu_online só muda uma CPU para ONLINE quando state == ABSENT.
FENCED não é convertido de volta.
Os testes confirmam que ack posterior não desfaz fencing.
Não existe protocolo de hot-unfence ou recovery.
Retornar uma CPU retirada ao serviço exigirá lifecycle novo e explícito.
Wrap da geração
gen é uint64_t.
tlb_publish incrementa a geração e, caso ocorra wrap para zero, substitui por 1.
Zero permanece reservado ao estado inicial.
Na prática, o número de gerações necessário para wrap é enorme.
Ainda assim, o modelo é baseado em igualdade simples e não define epoch adicional para uma CPU que ficasse parada durante uma volta completa de 64 bits.
É um limite teórico, não problema operacional atual.
Modelo de memory ordering
O estado compartilhado usa campos volatile e um compiler barrier antes de publicar gen.
Não existem C11 atomics para todos os campos nem fences arquiteturais explícitos específicos do protocolo.
x86-64 possui modelo de memória forte em relação a várias arquiteturas, mas isso não substitui uma prova completa de ordering entre compilador, cache coherence e protocolo.
Os host tests validam a máquina de estados em execução sequencial/modelada.
Eles não provam comportamento sob todas as interleavings SMP reais.
Esse é um limite atual de validação.
Falha no envio de IPI
apic_ipi pode retornar -1 quando:
- LAPIC não está disponível;
- delivery status não limpa dentro do limite.
mm_tlb_shootdown_with ignora esse retorno.
A segurança não depende diretamente de “IPI enviado com sucesso”, porque o critério final continua sendo seen/fencing.
Mas ignorar o erro elimina informação diagnóstica que poderia distinguir:
- IPI enviado e CPU lenta;
- rota LAPIC indisponível;
- falha local de entrega.
Uma evolução pode registrar esses estados sem enfraquecer o predicado de reuse.
Complexidade
Considere:
- C = quantidade máxima de slots TLB;
- P = páginas do intervalo;
- Q = extents em quarentena.
| Operação | Complexidade |
|---|---|
| snapshot na publicação | O(C) |
| seleção de IPIs | O(C) |
| uma etapa de wait | O(C) |
| INVLPG por intervalo | O(P) em cada CPU participante |
| processamento de bitmask fenced | O(C) |
| recompute_reuse | O(C) |
| reap da quarentena | O(Q) |
Atualmente C = 16 e Q <= 128.
O protocolo é deliberadamente pequeno e limitado.
Modelo de falha e recuperação
Peer reconhece normalmente
Invalida a faixa, atualiza seen e a geração converge.
Peer fica silencioso
Quiet counter pode causar fencing.
Depois o worker precisa executar flush e halt.
Peer continua vivo, mas nunca dá ack
O limite global de spins força fencing.
CPU fenced não chega ao worker
A espera final expira.
O shootdown retorna falha e as frames podem ser colocadas em quarentena.
Quarentena lota
A extensão não é devolvida ao PMM.
Há leak, mas não reuse inseguro.
O design atual possui uma preferência explícita por preservar integridade de memória.
Evidência de validação
tools/test_tlb_proto.c contém testes host específicos.
Todos dão ack
test_all_ack verifica:
- reuse bloqueado antes dos acks;
- conclusão sem fencing;
- CPUs permanecem ONLINE;
- reuse liberado.
CPU silenciosa
test_silent_cpu_is_fenced verifica:
- CPU muda para FENCED;
- deixa o conjunto ONLINE;
- fencing não basta para reuse;
- ack não desfaz fencing;
- halt após flush permite reuse.
Buraco no membership
test_hole_is_not_a_prefix prova que uma CPU de índice alto continua sendo target mesmo quando um slot intermediário foi fenced.
Halt sem flush
test_halt_without_invlpg_blocks_reuse prova que halted isolado é insuficiente.
Heartbeat
test_heartbeat_resets_quiet prova que heartbeat em movimento zera quiet e evita fencing prematuro.
Esses testes isolam a lógica da máquina de estados de LAPIC e do hardware real de TLB.
O que os testes host não provam
Eles não validam:
- INVLPG real em todas as CPUs;
- entrega LAPIC real;
- edge cases com IF desabilitado;
- races de memory ordering;
- CPU permanentemente presa fora do worker;
- initiators reais concorrentes além da serialização modelada;
- pressão prolongada sobre quarentena;
- CPU hotplug;
- migração de address spaces de usuário.
Esses pontos precisam de testes SMP runtime ou raciocínio formal adicional.
Resumo de locks e liveness
mm_lock
  serializa mutações da page table
  não deve permanecer segurado durante espera por ack

mm_tlb_busy
  serializa a única geração/faixa global
  waiters continuam fazendo TLB poll

job queue lock
  não representa estado de shootdown
  workers fazem TLB poll antes de trabalho normal
Essa separação evita a forma mais direta de deadlock entre mutação de page table e acknowledgement.
Restrições arquiteturais atuais
O protocolo é moldado pelo ChrisOS atual:
- 16 slots máximos de CPU;
- uma geração/faixa global;
- invalidação de 4 KiB por INVLPG repetido;
- principal caso SMP é reclamation de mapping compartilhado do kernel;
- user processes continuam BSP-only;
- CPUs fenced não possuem recovery automático;
- uma quarentena global;
- um shootdown publicado por vez.
É um design compreensível e controlado, mas não uma solução geral para kernel SMP de grande escala.
Direção futura
Evoluções plausíveis incluem:
- memory ordering com atomics explícitos;
- bitmaps exatos de CPUs online/retired;
- telemetria de falha de IPI;
- stop forçado confiável para CPU que não retorna ao worker;
- residency mask por address space;
- batching de invalidação;
- PCID/INVPCID;
- fila escalável de reclamation;
- stress tests com fault injection;
- lifecycle definido para CPU fenced voltar ao serviço.
Esses itens são roadmap, não comportamento existente.
Fronteira de revisão
Este capítulo foi reconciliado com ChrisOS main na revisão e05a17fd76333114a3fb5c2452f38ca747d4ac56.
O contrato atual é:
- o initiator invalida localmente antes da publicação;
- peers ONLINE precisam reconhecer a mesma geração;
- IPI acelera o poll, mas seen/gen é a evidência autoritativa;
- peers silenciosos ou persistentemente sem ack podem ser fenced;
- o retirement ativo é cooperativo pelo worker, não envio de NMI;
- CPU fenced precisa de flush e halt antes de reuse;
- frames sem prova suficiente são colocadas em quarentena.
Mudanças futuras em worker lifecycle, NMI, membership SMP, PCID ou memory ordering exigem nova reconciliação deste capítulo.