
Stack de armazenamento em blocos
Sobre este capítulo Transporte de blocos e mídia
Neste capítulo
- Stack de armazenamento em blocos
- Escopo
- Contrato BlockDevice
- Modelo de erros
- Guards de read e write
- Semântica de flush
- Modelo fixo de setor de 512 bytes
- Representação de capacidade
- Registro de devices
- Flags do registro
- Sequência de descoberta
- Seleção de root fase 1: ChrisFS cru
- Seleção de root fase 2: partição GPT
- Ownership da PartView
- Seleção de root fase 3: formatar disco vazio
- Geometria default
- Caminho ATA
- Addressability do ATA DMA
- Caminho AHCI
- Caminho NVMe
- Caminho VirtIO Block
- Interface síncrona sobre hardware naturalmente assíncrono
- Timeout é evento de ownership
- Segurança de range
- Teste de read/write no boot
- Probe de persistência
- Diagnóstico em camadas
- Modelo de concorrência
- Integridade e segurança
- Trade-offs de desempenho
- Fronteira de validação
- Limitações atuais
- Mapa de fonte
Escopo
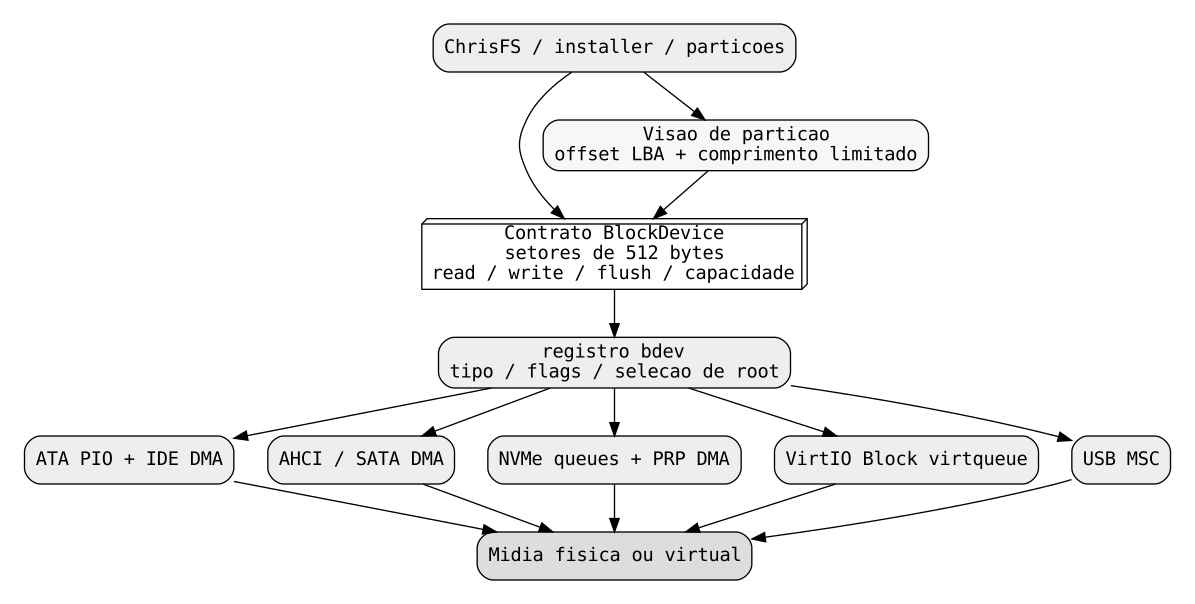
Armazenamento persistente aparece para o ChrisOS através de uma abstração orientada a setores, e não por código de filesystem acoplado a um controlador específico. Filesystem, installer e camada de partições trabalham com o contrato comum BlockDevice, enquanto ATA, AHCI, NVMe, VirtIO Block e USB implementam os mecanismos específicos abaixo dele.
O desenho atual possui três responsabilidades principais:
- normalizar I/O de devices em setores lógicos de 512 bytes;
- registrar devices descobertos e escolher a origem de armazenamento root;
- manter regras específicas de DMA, timeout e completion escondidas sob a interface comum.
Essa arquitetura é deliberadamente menor que um subsistema de blocos no estilo Linux. Não há request scheduler, elevator, merge genérico de requests, bio assíncrono nem page cache na camada de block device.
Contrato BlockDevice
BlockDevice contém:
- ponteiro de contexto específico do driver;
- sector_size;
- sector_count;
- callback de read;
- callback de write;
- callback opcional de flush;
- flag writable.
As operações usam setores lógicos:
O contrato genérico atual exige sector_size igual a 512.
bd_range_ok rejeita:
- device nulo;
- request com zero setores;
- device cuja unidade não seja 512 bytes;
- LBA maior ou igual a sector_count;
- count que ultrapasse o fim do device.
A checagem usa:
em vez de somar lba + count, evitando wrap de inteiro sem sinal no bounds check.
Modelo de erros
A camada comum normaliza falhas em:
Isso é um ponto de normalização importante.
Cada protocolo reporta falhas de forma diferente:
- bits de status ATA;
- task-file e completion em AHCI;
- status de completion em NVMe;
- used ring e status byte em VirtIO.
Os drivers transformam esses resultados específicos no domínio BD_* antes de o ChrisFS enxergá-los.
Assim o filesystem não depende de detalhes do transporte.
Guards de read e write
bd_read rejeita destino nulo, device nulo ou ausência de callback de leitura com BD_EINVAL.
Depois aplica bd_range_ok.
bd_write também testa writable.
Device read-only retorna BD_EROFS antes de qualquer callback de driver.
Os wrappers genéricos não fragmentam requests nem criam bounce buffers. Chunking pertence aos drivers porque limites de transferência, DMA e descriptors variam por controlador.
Semântica de flush
bd_flush chama o callback de flush quando existe.
Se o device não possui callback, a implementação retorna BD_OK.
Portanto “não há callback” é tratado como “nenhuma operação explícita necessária”, não como erro de comando não suportado.
Isso simplifica a abstração, mas BD_OK nesse caso não prova que todas as combinações de controller/cache/media possuem a mesma garantia de durabilidade de um hardware flush real.
Durabilidade final depende do driver e do device.
Modelo fixo de setor de 512 bytes
storage_limits.h define:
O stack atual inteiro depende dessa unidade.
Isso afeta:
- validação BlockDevice;
- geometria ChrisFS;
- GPT;
- ATA;
- AHCI;
- NVMe;
- VirtIO Block.
No NVMe, o probe rejeita namespace cujo formato LBA selecionado não represente 2^9 bytes.
Assim a abstração atual não normaliza device 4Kn para setor lógico de 512 bytes.
Namespace ou disco com setor lógico nativo de 4 KiB está fora do contrato atual.
Representação de capacidade
sector_count é uint32_t.
Com 512 bytes por setor, a capacidade máxima diretamente representável é aproximadamente:
Alguns drivers rejeitam explicitamente capacidades cujo dword alto é diferente de zero.
O NVMe, por exemplo, recusa NSZE acima do campo de 32 bits usado pelo BlockDevice.
VirtIO Block faz check equivalente.
Esse limite pertence ao ChrisOS atual, não ao protocolo NVMe ou VirtIO.
Registro de devices
bdev.c mantém registro estático com:
Cada slot armazena:
- cópia de BlockDevice;
- nome curto;
- kind;
- flags;
- ID interno.
Kinds conhecidos incluem ATA, AHCI, NVMe, VirtIO, USB, RAM e partition.
bd_add_kind copia a estrutura BlockDevice.
O contexto do driver continua sendo ponteiro para estado mantido pelo próprio driver.
Logo lifetime do ctx precisa ultrapassar o lifetime do registro.
Flags do registro
Existem flags para:
- BOOT;
- ROOT;
- TEST.
claim_root marca o device selecionado como BOOT e ROOT.
bd_installable exclui:
- read-only;
- BOOT, ROOT ou TEST;
- RAM;
- partition view.
Essa política evita usar como destino cru do installer o device que já está montado como root, um RAM disk ou uma visão de partição.
Sequência de descoberta
storage_init tenta várias famílias.
O fluxo começa configurando e identificando ATA legado e depois chama probes de:
- AHCI;
- NVMe;
- VirtIO Block;
- USB mass storage;
- xHCI HID no contexto da descoberta de hardware.
Cada driver que encontra device registra um BlockDevice através de bd_add_kind.
Probe order não determina sozinho o root.
A escolha de root é outra fase.
Seleção de root fase 1: ChrisFS cru
discover_root percorre devices não-RAM e testa se existe ChrisFS diretamente no início do device.
disk_has_cfs lê o setor de superblock e tenta cfs_super_decode.
O primeiro device válido vira root.
Isso suporta layout sem partição, com ChrisFS ocupando o block device inteiro.
Seleção de root fase 2: partição GPT
Se não houver ChrisFS cru, discover_root procura partição GPT com GUID de ChrisFS ou GUID Linux filesystem-data aceito por compatibilidade.
gpt_find_cfs:
- lê LBA 1;
- valida assinatura EFI PART;
- verifica CRC do header de 92 bytes suportado;
- obtém LBA e geometria da tabela de partitions;
- limita scan a 128 entries;
- encontra GUID aceito;
- valida LBA inicial/final;
- retorna start/count de 32 bits.
part_open cria uma visão limitada sobre esse intervalo.
O wrapper traduz:
e expõe sector_count igual ao comprimento da partição.
ChrisFS pode montar essa view como se fosse outro BlockDevice.
Ownership da PartView
PartView não cria um device físico.
Ela guarda ponteiro para o parent e expõe outro BlockDevice com callbacks que somam o offset.
writable é herdado.
A composição fica:
A mesma API read/write funciona em cada fronteira.
Seleção de root fase 3: formatar disco vazio
Se nenhum root existente é encontrado, discover_root procura device:
- writable;
- não-RAM;
- grande o suficiente para a geometria default;
- com primeiros oito bytes do setor zero iguais a zero.
Somente nesse caso storage_format_if_empty pode formatar.
É uma política de segurança.
Mídia com dados desconhecidos não é sobrescrita automaticamente.
Se o superblock ChrisFS é inválido e o prefixo não está zerado, a rotina retorna CFS_EFORMAT.
storage_init trata isso como conteúdo desconhecido e não formata silenciosamente.
Geometria default
storage_limits.h define:
Isso representa 512 MiB.
O valor funciona como mínimo para o caminho de autoformatação de disco vazio.
Não é o máximo universal de disco.
Drivers podem expor devices maiores dentro do limite de sector_count uint32_t.
Caminho ATA
O driver ATA implementa PIO e IDE bus-master DMA.
No DMA, o código atual mantém buffers persistentes do próprio driver em vez de alocar PRDT e bounce buffer a cada operação.
O buffer DMA atende chunks de até 16 setores.
Quando DMA falha, ata_bd_read e ata_bd_write:
- param/abortam DMA;
- fazem soft reset do path ATA;
- caem para PIO;
- continuam em chunks de até 255 setores.
DMA funciona como otimização com fallback, e não como única forma de I/O.
Polling ATA distingue:
- ausência de device;
- timeout;
- I/O error.
Addressability do ATA DMA
O bus-master IDE atual exige data buffer e PRDT abaixo de 4 GiB.
ata_dma_acquire rejeita físicos acima de 0xffffffff.
O driver aloca RAM via PMM e acessa o buffer por HHDM.
Isso mostra concretamente:
Caminho AHCI
AHCI usa MMIO e DMA command structures.
O driver atual:
- procura PCI class 0x0106;
- mapeia BAR 5;
- habilita AHCI;
- lê bitmap de ports implementados;
- exige link device-present;
- aloca páginas DMA para control structures e data;
- inicia port;
- envia IDENTIFY;
- obtém capacidade;
- registra BlockDevice writable de 512 bytes.
I/O é dividido em chunks de até oito setores.
O driver monta FIS host-to-device e estruturas DMA.
Completion é atualmente polled no command-issue/task-file state; o BlockDevice continua síncrono.
Caminho NVMe
NVMe usa MMIO PCIe e submission/completion queues em memória DMA.
A implementação atual aloca:
- admin SQ;
- admin CQ;
- I/O SQ;
- I/O CQ;
- data buffer.
As queues são pequenas: head/tail usam dois entries no desenho atual.
O driver cria I/O queues via admin commands, identifica namespace 1, valida LBA de 512 bytes, lê capacidade e registra BlockDevice.
Reads/writes usam até oito setores por comando.
A interface comum esconde CID, phase bit, doorbells e completion status.
Caminho VirtIO Block
VirtIO Block detecta devices PCI compatíveis, percorre capabilities VirtIO e mapeia regiões common, notify e device config.
Depois aloca áreas DMA para:
- virtqueue;
- command/status;
- dados.
Cada request cria descriptor chain para:
- header;
- data;
- status.
O driver notifica a queue e espera used-ring + status de sucesso.
Existem budgets finitos de polling.
Se completion não chega, retorna BD_ETIMEOUT.
Read/write também usa no máximo oito setores por chunk.
Interface síncrona sobre hardware naturalmente assíncrono
AHCI, NVMe e VirtIO suportam modelos com múltiplos comandos em flight.
O BlockDevice atual é síncrono.
Caller entra em read/write e só retorna depois da completion ou falha.
Os drivers escondem o modelo de queue atrás de loops de polling finitos.
Isso simplifica filesystem e lifecycle de buffers, mas reduz throughput e paralelismo.
Uma camada assíncrona futura exigiria requests explícitos, completion ownership, cancelamento e reset.
Timeout é evento de ownership
Timeout não é somente um código.
Com DMA, a pergunta crítica é:
o hardware ainda pode acessar o buffer?
No ATA, a implementação aborta engine e faz reset antes de cair para PIO.
Em qualquer controlador, reutilizar buffer enquanto uma operação antiga ainda pode fazer DMA é corrupção.
Uma implementação hardened precisa provar que o comando foi cancelado, completou ou que o controller foi resetado antes de reutilizar memória.
Timeout recovery faz parte do modelo de ownership.
Segurança de range
BlockDevice impede read/write além de sector_count.
PartView adiciona boundary reduzido.
Assim um ChrisFS montado em uma partição não consegue, pela API normal bd_read/bd_write, emitir LBA além do seu range visível.
Os callbacks internos de PartView chamam diretamente os callbacks do parent.
A segurança depende de part_open validar/capar start/count e de o wrapper genérico da child fazer o range check antes de entrar no callback da partição.
Teste de read/write no boot
storage_init executa bdev_rw_tests depois de montar root.
O teste ignora:
- root;
- read-only;
- RAM;
- device com menos de dois setores.
Nos demais:
- lê o último setor;
- grava pattern determinístico;
- lê de volta;
- compara todos os bytes;
- restaura o setor original.
É um teste destrutivo com restauração em devices não-root.
Ele valida o caminho completo de write/read, e não somente que o probe encontrou o controller.
Falha indica que o caminho de block I/O não conseguiu completar o round trip com integridade.
Probe de persistência
Depois de montar ChrisFS, hello_probe lê HELLO.TXT.
Se não existe, grava persistent.
Em boot posterior, espera o mesmo conteúdo.
Isso cria evidência end-to-end atravessando:
É uma checagem de persistência mais forte que um unit test apenas em RAM.
Diagnóstico em camadas
Falha de storage pode surgir em:
metadata do filesystem
    -> partição
        -> contrato BlockDevice
            -> driver
                -> DMA/MMIO/PIO
                    -> controller
                        -> mídia ou backend virtual
“Mount failed” pode significar:
- superblock inválido;
- LBA errado;
- sector size incompatível;
- timeout;
- addressability DMA;
- device ausente;
- target read-only;
- mídia corrompida.
Diagnóstico correto identifica a camada.
Modelo de concorrência
BlockDevice não possui lock nem request ID.
A política de concorrência está nos drivers/callers.
Vários drivers atuais usam estado global e um único DMA buffer reutilizável.
Isso corresponde a modelo síncrono de single-owner por instância.
Chamadas simultâneas no mesmo controller sem serialização adicional podem corromper descriptors, queue indices ou buffers.
Uma evolução deve tornar essa garantia explícita.
Integridade e segurança
Block layer fica abaixo do filesystem.
Se um driver grava LBA errado, checksum de metadata não impede corrupção de setor não relacionado.
Fronteiras importantes:
- bounds de LBA;
- offset de partition;
- CRC GPT;
- recusa em formatar mídia desconhecida;
- writable flag;
- waits limitados;
- lifetime correto de buffers DMA.
São propriedades de safety mesmo em kernel experimental single-user.
Trade-offs de desempenho
A implementação atual prioriza simplicidade e determinismo.
Exemplos:
- API síncrona;
- chunks pequenos;
- polling;
- queues NVMe/VirtIO pequenas;
- bounce buffers persistentes;
- sem merge genérico;
- sem cache de blocos nessa camada;
- sem reordenação de LBA.
O desenho já permite múltiplos protocolos sob o mesmo filesystem.
Para extrair throughput de NVMe moderno seria necessário request model muito mais paralelo.
Fronteira de validação
O source atual comprova:
- semântica comum de range/errors;
- exigência de 512-byte sectors;
- registry e root policy;
- GPT/partition views;
- ATA DMA com fallback PIO;
- AHCI síncrono por DMA;
- setup de admin/I/O queues NVMe;
- VirtIO descriptor-chain I/O;
- testes read/write em devices não-root;
- probe de persistência ChrisFS entre boots.
Isso não prova compatibilidade universal.
Topologias PCI, quirks, hotplug, 4Kn, disks >2 TiB e error recovery complexa precisam de evidência separada.
Limitações atuais
O block subsystem atual possui:
- no máximo 8 devices registrados;
- setores lógicos de 512 bytes apenas;
- sector_count uint32_t, cerca de 2 TiB;
- API síncrona;
- sem requests/completions genéricos assíncronos;
- sem scheduler de I/O;
- queue depth limitada nos drivers;
- vários paths usam buffer DMA compartilhado;
- sem lifecycle genérico de hotplug;
- sem contrato comum de cancelamento;
- flush opcional que pode ser no-op;
- autoformatação somente em mídia claramente vazia;
- suporte real a hardware mais restrito que os standards completos.
São limites da implementação, não de ATA, AHCI, NVMe ou VirtIO como tecnologias.
Mapa de fonte
kernel/fs/block_device.h define o contrato de setor e os erros BD_*.
kernel/fs/bdev.c e bdev.h implementam registry, kinds, flags e policy de installability.
kernel/fs/storage.c coordena probes, escolha de root, formatação segura, mount e testes.
kernel/fs/part.c implementa GPT e PartView.
kernel/fs/ata_pio.c implementa ATA PIO e IDE DMA com fallback.
kernel/fs/ahci.c implementa SATA/AHCI atual.
kernel/fs/nvme.c implementa o caminho NVMe de queues pequenas.
kernel/fs/virtio_blk.c implementa VirtIO Block PCI/virtqueue.
As afirmações deste capítulo foram reconciliadas com ChrisOS e05a17fd76333114a3fb5c2452f38ca747d4ac56.