
Modelo de kernel, domínios de proteção e fronteiras de confiança
Sobre este capítulo Fronteiras de confiança e entrada de exceções
Neste capítulo
- Modelo de kernel, domínios de proteção e fronteiras de confiança
- Escopo
- Classificação deve descrever proteção, não diretórios
- O que monolítico significa aqui
- O que modular significa aqui
- Monolítico versus microkernel
- Monolítico versus híbrido
- Protection domain
- Ring 0
- Ring 3
- CPL
- Permissionamento de user pages
- Kernel high-half compartilhado
- Mapping faz parte da security boundary
- User ELF range atual
- Native entry path
- System-call boundary
- Syscalls nativas atuais
- User pointers são untrusted
- Ring transition não valida semântica
- Ownership em syscall
- Contenção de user fault
- Kernel fault
- Hierarquia de failure domains
- CLVM é outro execution model
- Guest address não é native virtual address
- CLVM SYS boundary
- Consequência do software sandbox
- Capability checks no CLVM
- Hardware gate
- Capability não é isolation física
- DMA contorna page checks da CPU
- DMA ownership
- Trusted Computing Base
- TCB não é número de linhas
- Internal API boundary
- Device abstraction boundary
- Por que modularidade continua importante
- Makefile como evidência arquitetural
- Static linking
- Initialization graph monolítico
- Native kernel/user split
- CLVM split
- Dois application models coexistem
- Kernel jobs
- Kernel threads
- Stack separada não é address-space isolation
- SMP atual é assimétrico
- Por que userspace BSP-only importa
- SMP não significa multicore userspace
- Shared kernel mappings
- TLB é questão de segurança de lifetime
- Fenced CPUs
- Interrupt é entrada assíncrona em ring 0
- Lock order
- PMM e reentrância
- Filesystem lock é diferente
- Race residual em networking
- Audio IRQ
- Mechanism e policy
- Resource ownership é arquitetura
- Memória de processo
- JIT ownership
- Device-owned resources
- Boot resources
- Failure domains
- Panic policy
- Por que restart de driver estilo microkernel não existe hoje
- Hardware authority
- U/S em todos os níveis
- W^X em native ELF
- ELF validation
- Parser é TCB
- Filesystem é privilegiado
- Network parsing é privilegiado
- Graphics é privilegiado
- Window manager é privilegiado
- Toolchain é privilegiado no build atual
- Self-hosting e privilege são objetivos diferentes
- Kernel tools também estão linkados
- Research OS e shared privilege
- Taxonomia não mede qualidade
- Dependency direction atual
- Core versus policy-heavy
- Authority inventory
- API surface versus authority surface
- Process CR3 ownership
- Kernel thread address space
- Context versus domain
- Scheduler ownership
- Requisitos para multicore userspace
- O que seria necessário para mais microkernel
- Um caminho híbrido possível
- Nenhum redesign é obrigatório
- Observabilidade
- Build identity
- Host tests e integration
- Validation ladder
- Stub precisa continuar visível como stub
- Tabela de trust boundaries
- Privilege minimization futura
- Driver isolation é difícil
- CLVM como laboratório intermediário
- Native ring 3 é isolamento de hardware mais forte
- Maturidade de user-copy
- Handles versus raw authority
- Global state é principal pressão do modular monolith
- Process table atual
- Job queue atual
- Filesystem state atual
- Network state atual
- Graphics state atual
- Window manager atual
- Compiler/JIT atual
- Source Atlas
- AI e architecture contracts
- Checker reproduzível
- Resumo arquitetural atual
- O que o ChrisOS não é hoje
- Foundations que já ajudam evolução futura
- A arquitetura deve seguir os fatos
- Limite de validação
- Gatilhos de revisão
- Referências primárias
Escopo
A palavra kernel identifica software privilegiado, mas não define por si só uma arquitetura interna.
Dois sistemas podem usar ring 0, virtual memory, processes e drivers e ainda assim ter fronteiras de confiança completamente diferentes.
As perguntas úteis são:
- quais componentes executam com privilégio supervisor;
- quais componentes compartilham address space;
- quais chamadas atravessam uma fronteira imposta pelo hardware;
- quais chamadas são apenas APIs internas;
- quais recursos um componente pode corromper diretamente;
- quais falhas podem ser contidas;
- quais estados são globais;
- quais CPUs podem alterá-los;
- quais atores conseguem acessar physical memory sem passar pelas page permissions normais da CPU.
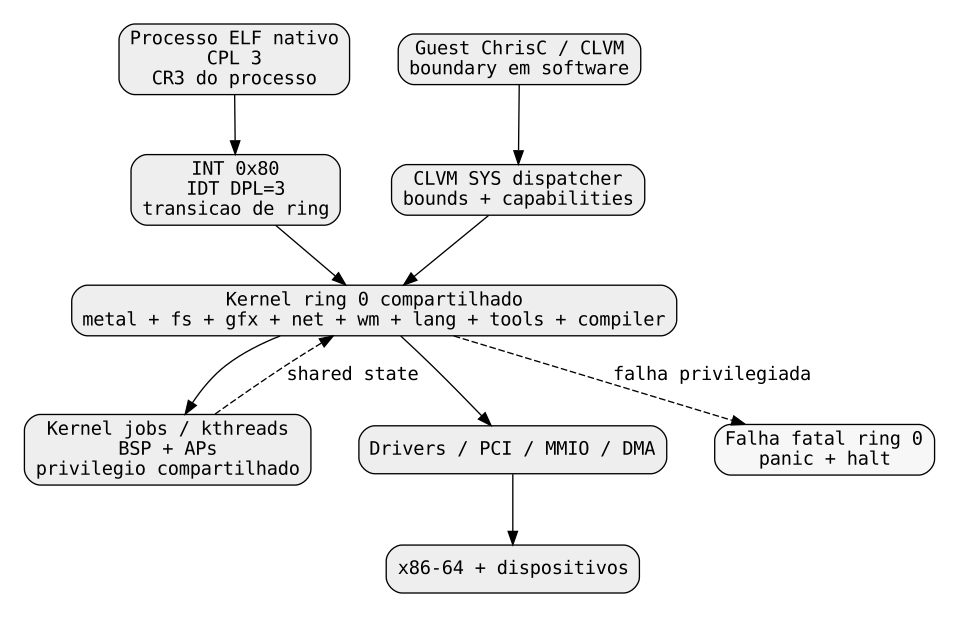
Na revisão analisada, o ChrisOS é melhor descrito como um kernel x86-64 monolítico modular com dois modelos de execução de aplicações:
- processos ELF nativos em ring 3, protegidos por privilege levels e page tables;
- programas ChrisC/CLVM executados através de uma virtual machine em software e de um dispatcher de serviços do kernel.
A maior parte dos serviços do sistema operacional, drivers, graphics, storage, networking, desktop, runtime de linguagem e uma parte substancial do toolchain são ligados ao mesmo kernel ELF privilegiado.
A modularidade de source é ampla.
O isolamento de falhas entre esses módulos em ring 0 não é imposto pelo hardware.
Classificação deve descrever proteção, não diretórios
Uma árvore de source pode ser altamente modular e ainda gerar um único executable privilegiado.
O ChrisOS separa diretórios como:
kernel/metal
kernel/fs
kernel/gfx
kernel/net
kernel/wm
kernel/lang
kernel/tools
kernel/crypto

compiler/chrisc
compiler/clvm
compiler/jit
compiler/kcc
compiler/chrisasm
compiler/chrisld
...
Essa organização expressa coesão e responsabilidade.
Ela não cria automaticamente domains isolados.
A evidência decisiva é o makefile.
A lista de objects do kernel inclui diretamente código de:
kernel/metal/*
kernel/fs/*
kernel/gfx/*
kernel/net/*
kernel/wm/*
kernel/lang/*
kernel/tools/*
kernel/crypto/*

compiler/chrisc/*
compiler/clvm/*
compiler/jit/*
compiler/kcc/*
compiler/chrisasm/*
compiler/chrisld/*
...
Esses objects são ligados ao mesmo kernel ELF.
Uma chamada do filesystem para storage continua ring 0.
Uma chamada de graphics para PMM continua ring 0.
O processador não executa uma privilege transition porque os arquivos estão em diretórios diferentes.
O que monolítico significa aqui
Neste capítulo, monolítico significa que os principais serviços do sistema operacional executam dentro de um domínio privilegiado compartilhado.
No source atual isso inclui:
- physical-memory management;
- page-table management;
- process management;
- exception e interrupt handling;
- estado relacionado a scheduling;
- filesystem;
- storage drivers;
- PCI access;
- network stack;
- VirtIO network;
- graphics;
- framebuffer;
- VirtIO-GPU;
- VirGL;
- audio;
- input;
- window manager;
- desktop loop;
- runtime de linguagem;
- grande parte do toolchain self-hosted.
O termo não significa que tudo esteja em um único arquivo ou que não existam interfaces internas.
O que modular significa aqui
O ChrisOS é modular no sentido de engenharia de software.
Subsystems expõem functions, headers e ownership contracts.
Exemplos:
PMM
    ownership de physical pages

MM
    mapping e translation

proc
    process lifecycle

syscall
    entrada de serviços ring 3

bdev
    abstração de block device

fs
    frontend de filesystem

gfx
    rendering e device abstraction

sock
    socket ownership

job
    trabalho SMP no kernel

CLVM
    execução de guest em software
Essas fronteiras ajudam:
- coesão;
- navegação;
- testes;
- substituição de backend;
- auditoria;
- reasoning de dependências.
Mas uma boundary de C interna não é automaticamente security boundary.
Monolítico versus microkernel
Um microkernel normalmente tenta manter no domínio mais privilegiado um conjunto menor de mecanismos.
Exemplos típicos:
- low-level address-space management;
- scheduling;
- interrupt delivery;
- IPC primitives.
Drivers, filesystems e serviços podem executar como processos de usuário separados.
Quando isso é feito corretamente, um crash de server pode ser contido por page protection.
O ChrisOS não implementa atualmente esse placement.
Filesystem, storage, graphics, network e desktop estão ligados ao privileged image.
Logo modularidade de source não deve ser descrita como microkernel isolation.
Monolítico versus híbrido
O termo hybrid kernel é usado de formas diferentes na literatura e em produtos.
Alguns sistemas partem de princípios de microkernel mas executam muitos serviços em um domínio privilegiado compartilhado por performance ou compatibilidade.
Outros usam o termo de forma principalmente histórica.
Para o ChrisOS, a descrição concreta é mais útil:
major OS services e drivers
    shared ring-0 kernel space

native applications
    ring 3

CLVM applications
    software VM boundary
Esse placement corresponde hoje a um monolítico modular.
Ter user processes, VM, JIT ou módulos separados não torna automaticamente o kernel híbrido.
Protection domain
Protection domain é um conjunto de code e data que compartilha autoridade suficiente para acessar recursos sem atravessar um mecanismo de isolamento.
No x86 nativo, mecanismos importantes incluem:
- CPL/rings;
- U/S page bits;
- R/W page bits;
- NX;
- I/O privilege;
- gates controlados.
Dentro do kernel ELF, a maior parte dos modules compartilha ring 0.
Ring 0
Código ring 0 pode executar privileged instructions e acessar supervisor mappings.
No ChrisOS atual, isso inclui:
MOV CR3
LGDT
LIDT
LTR
CLI
STI
IN / OUT
MMIO
page-table mutation
physical-page allocation
interrupt-controller programming
PCI configuration
DMA descriptor construction
Por isso um memory bug em um subsystem privilegiado pode ter impacto sistêmico.
Ring 3
O ChrisOS também possui uma rota de native user execution.
enter_user constrói um IRETQ frame com:
e entra em user mode via IRETQ.
Essa é uma privilege transition real imposta pelo hardware.
CPL
Current Privilege Level deriva dos bits baixos de CS.
Para user execution:
Para kernel:
A CPU aplica restrictions de privileged instructions e paging com base nisso.
Permissionamento de user pages
Mappings nativos de user recebem MM_USER.
O ELF loader inicia page flags com:
e adiciona write somente em segmentos PF_W e NX quando PF_X não está presente.
Logo o isolamento nativo não é apenas uma convenção.
Ele existe nas page tables.
Kernel high-half compartilhado
Novos process roots recebem as entries superiores do kernel.
Conceitualmente:
Kernel permanece acessível a ring 0 mesmo com process CR3 ativo.
U/S correto impede ring 3 de acessar essas pages.
Mapping faz parte da security boundary
A diferença entre rings só funciona se page permissions forem corretas.
Uma kernel page marcada USER pode ser exposta.
Uma user page sem MM_USER pode falhar mesmo estando em low address.
Segurança depende de translation permissions reais, não apenas de endereços altos e baixos.
User ELF range atual
O loader nativo aceita segmentos em uma janela pequena:
É policy atual.
Não é limite da arquitetura x86-64.
Native entry path
ELF bytes
    ↓
elf_load
    ↓
proc_create
    ↓
novo CR3
    ↓
PT_LOAD pages com MM_USER
    ↓
proc_switch
    ↓
enter_user
    ↓
IRETQ
    ↓
CPL 3
Os capítulos de processes/syscalls aprofundam cada etapa.
System-call boundary
O syscall nativo atual usa:
syscall_init altera IDT vector 0x80 para user-accessible gate.
O DPL permite invocation em ring 3.
O interrupt machinery transfere controle para ring 0.
Isso é um trust-boundary crossing de hardware.
Syscalls nativas atuais
O ABI inclui operações para:
- exit;
- output;
- pixel output;
- file open;
- file read;
- file write;
- file close;
- key state.
É pequeno em comparação com um ABI de sistema geral.
Mesmo pequeno, é uma fronteira de segurança real.
User pointers são untrusted
Quando syscall executa, o kernel está em ring 0, mas argumentos vieram de ring 3.
Todo pointer, length, handle e identifier deve ser tratado como não confiável.
O source atual já faz page translation e checks de MM_USER em caminhos de memória.
A auditoria também registra que ainda não existe uma única abstração universal para copy_from_user/copy_to_user em todos os syscalls.
Isso permanece uma área de hardening.
Ring transition não valida semântica
A CPU valida a entrada de privilégio.
Ela não valida:
- buffer length;
- path de filesystem;
- ownership de FD;
- integer overflow;
- pointer range;
- permissões semânticas.
Isso pertence ao kernel.
Ownership em syscall
Native file descriptors possuem owner de processo.
Teardown de processo fecha descriptors e sockets associados.
Isso demonstra:
São conceitos diferentes.
Contenção de user fault
O page-fault path distingue user fault de kernel fault.
Para user:
- demand paging pode resolver;
- se inválido, process fault é registrado;
- processo pode ser destruído;
- kernel recupera seu fluxo.
Logo existe fault containment real em escopo de processo para vários erros de userspace.
Kernel fault
panic e panic_exception desabilitam interrupts, imprimem identidade e entram em HLT loop.
Ring-0 fatal fault não é tratado como crash isolado de service.
Isso corresponde ao trust model monolítico atual.
Hierarquia de failure domains
Uma visão aproximada:
native user fault
    potencialmente um processo

CLVM guest fault
    potencialmente uma VM/slot

driver/kernel bug
    potencialmente kernel inteiro

hardware/device fault
    depende da rota
O blast radius varia conforme a boundary.
CLVM é outro execution model
Programas ChrisC frequentemente rodam em CLVM.
CLVM memory é um buffer/estrutura controlado pela VM e o guest usa offsets.
Interpreter valida endereços contra vm->mem_size.
Exemplos:
É boundary em software.
Não é equivalente a CPL 3.
Guest address não é native virtual address
No CLVM:
No native process:
Misturar os dois modelos ocultaria diferenças de segurança importantes.
CLVM SYS boundary
A instrução SYS da VM chama dispatcher via callback controlado.
O interpreter pode rejeitar bad guest addresses antes de formar host pointers arbitrários.
É um software sandbox.
A CPU continua executando código do interpreter no domínio privilegiado.
Consequência do software sandbox
Uma VM correta consegue conter muitos bugs de guest.
Mas um bug de memory safety no interpreter ou bridge CLVM continua ocorrendo em kernel code privilegiado.
Logo a proteção depende da correção da VM.
Não é hardware fault isolation.
Capability checks no CLVM
A camada de serviços CLVM possui capability checks para operações selecionadas.
Isso cria policy de autoridade para aplicações.
Ainda assim os checks são implementados dentro do kernel privilegiado.
Hardware gate
kernel/gfx/hwgate.c media operações de alto poder:
- PCI configuration write;
- BAR mapping;
- MMIO;
- DMA allocation;
- disk access;
- GPU queue setup.
É uma das boundaries de maior autoridade do sistema.
Ele pode transformar um pedido em efeitos sobre physical memory e hardware.
Por isso faz parte da TCB efetiva.
Capability não é isolation física
Uma capability em software pode rejeitar uma operação não autorizada.
Ela não impede um bug dentro do driver de usar physical address errado.
IOMMU adicionaria outra camada.
A documentação atual não presume IOMMU sem implementação.
DMA contorna page checks da CPU
Um bus-master device não executa load/store em ring 3.
Quando recebe um physical address, acessa memória de acordo com regras do dispositivo/plataforma/IOMMU.
Logo:
Drivers DMA fazem parte da memory protection story.
DMA ownership
DMA seguro precisa de:
- buffer físico válido;
- address width correto;
- buffer vivo até completion;
- frame não reutilizado cedo;
- descriptor lifetime;
- completion;
- ordering;
- cache policy;
- isolamento/trust de device.
Os capítulos de DMA aprofundam isso.
Trusted Computing Base
TCB é o conjunto de componentes cuja correção é necessária para determinada propriedade.
Para native ring-3 isolation, inclui ao menos:
- GDT/TSS;
- IDT/entry stubs;
- page-table code;
- PMM lifetime;
- process create/destroy;
- ELF loader;
- user-copy/syscall;
- CR3 switch;
- kernel exception handling.
Para filesystem integrity, TCB cresce.
Para DMA safety, drivers entram.
A TCB depende da propriedade analisada.
TCB não é número de linhas
Uma função pequena que altera PTE pode ser mais crítica que um grande subsystem visual.
Auditoria deve seguir authority e invariants.
Internal API boundary
Quando kernel/fs chama storage, a API pode organizar:
- types;
- errors;
- ownership;
- contracts.
Mas ambos são ring 0.
Hardware não impede um wild pointer de um módulo de atingir globals do outro.
Isso é API boundary, não protection domain.
Device abstraction boundary
Block-device API separa filesystem de AHCI, NVMe, ATA, VirtIO Block e USB.
É uma boundary arquitetural importante.
Facilita troca de driver.
Não isola memory faults por hardware.
Por que modularidade continua importante
Mesmo sem isolation entre modules, boundaries bem definidas permitem:
- reasoning local;
- ownership explícito;
- host tests;
- backends intercambiáveis;
- APIs menores;
- lock-order;
- differential testing;
- futura migração para isolation maior.
Monolithic não significa desorganizado.
Makefile como evidência arquitetural
C_OBJECTS_REL mostra o conteúdo efetivo do privileged image.
Ele contém objects de:
metal
network
crypto
graphics
window manager
tools
storage/filesystem
language runtime
compiler
JIT
process/SMP
Isso é evidência mais forte de placement do que os nomes dos diretórios.
Static linking
O kernel usa:
com linker script próprio.
Os objects listados compõem um único executable freestanding.
Não existe hoje um service manager de user processes separando filesystem, graphics e network no boot de produção.
Initialization graph monolítico
kstart chama diretamente:
Não existe IPC de boot entre independent servers.
Isso confirma o placement atual.
Native kernel/user split
ring 3
    native ELF
        |
        | INT 0x80
        v
ring 0
    syscall
    process/MM
    filesystem
    graphics
    network
    drivers
    hardware
A passagem de ring é estreita e explícita.
CLVM split
O CPL não precisa mudar durante cada guest instruction.
Isolation é software.
Dois application models coexistem
| Modelo | Boundary | Address model | Entrada em serviços | Isolation |
|---|---|---|---|---|
| Native ELF | ring 3 → ring 0 | x86 VA | INT 0x80 | CPL + paging |
| CLVM | guest → VM host | offset de VM | CL_OP_SYS | interpreter + capabilities |
Não é correto fazer uma única afirmação de segurança para ambos.
Kernel jobs
O job system distribui work entre CPUs.
APs executam job_worker_forever.
Job é function pointer + argument.
Isso não cria process, CR3 próprio ou ring 3.
É kernel work privilegiado.
Kernel threads
kthread_create cria stack separada e agenda execução no job system.
kthread troca RSP para a stack alocada, chama function e restaura RSP anterior.
Não troca para user CR3.
Não entra em ring 3.
Portanto kernel thread atual é:
Stack separada não é address-space isolation
Kernel threads diferentes ainda compartilham:
- globals;
- heap;
- kernel mappings;
- devices;
- filesystem state.
A stack melhora context management, não isolation.
SMP atual é assimétrico
APs podem executar kernel jobs.
Native user process switching permanece BSP-only.
Source e LOCKING.md impõem:
e syscall_dispatch recusa off-BSP execution.
Por que userspace BSP-only importa
Process table e current process são globais.
Restringir user scheduling a uma CPU reduz concorrência sobre:
- g_current;
- user CR3;
- syscall return state;
- process lifecycle.
É uma simplificação arquitetural explícita.
SMP não significa multicore userspace
É possível usar várias CPUs para kernel work sem rodar user processes em todas.
ChrisOS faz isso atualmente.
Toda afirmação de SMP deve especificar o domínio que realmente participa.
Shared kernel mappings
Process roots compartilham upper kernel half.
Logo alterações de shared kernel virtual memory podem impactar múltiplos CPUs e CR3s.
Isso transforma TLB shootdown em problema de correctness e ownership.
TLB é questão de segurança de lifetime
Imagine unmap de uma kernel page seguido de pmm_free.
Se outro CPU ainda possuir stale TLB entry, ele pode continuar usando o antigo frame depois de ownership ter mudado.
Portanto:
Não é apenas performance.
Fenced CPUs
O protocolo atual pode fence CPU que não confirma shootdown.
Frames podem ir para quarantine até reuse seguro.
É uma forma de containment dentro de um monolítico SMP.
Interrupt é entrada assíncrona em ring 0
Mesmo em um único CPU, interrupt pode executar handler entre instructions normais.
Se um lock for mantido e IRQ tentar adquirir o mesmo lock, existe possibilidade de deadlock.
Por isso interrupt state faz parte do locking model.
Lock order
O projeto documenta ordem explícita:
Isso reduz cycles de aquisição.
É arquitetura, não apenas comentário.
PMM e reentrância
PMM permite reentrada controlada do mesmo CPU em callbacks específicos.
A outer acquisition salva/desabilita interrupts.
Isso evita IRQ reentrar em estado inconsistente.
Filesystem lock é diferente
CFS usa yielding lock.
Waiters deixam interrupts ativos porque storage/IRQ pode precisar progredir.
Não existe uma única locking primitive correta para todo kernel.
Race residual em networking
LOCKING.md registra que socket table ainda não tem lock dedicado.
Hoje mutações aparecem em BSP syscall path e receive path.
Se receive passar a acontecer em AP concorrente, ownership sozinho não basta.
Esse é um limitation atual explícito.
Audio IRQ
AC97 combina:
- spinlock;
- irq_save;
- atomics.
Isso existe porque interrupt handler observa shared state.
Driver boundary também é concurrency boundary.
Mechanism e policy
Exemplos:
mm_map_cr3
    mechanism

decidir MM_USER
    policy

apic_ipi
    mechanism

quem deve ack TLB
    policy

pmm_alloc
    mechanism

quem libera frame
    ownership policy

bdev read
    mechanism

filesystem layout
    policy
Mesmo quando source mistura ambos, os conceitos devem permanecer separados.
Resource ownership é arquitetura
Todo recurso precisa de:
- owner;
- lifetime;
- borrowers;
- synchronization;
- release condition;
- failure cleanup.
RESOURCE_OWNERSHIP.md formaliza vários casos.
Memória de processo
Process possui PML4/user-half page tables e leaf frames rastreados.
proc_destroy libera:
- user pages;
- user page-table structures;
- native FDs;
- sockets.
Isso é mais forte que simplesmente apagar process table entry.
JIT ownership
JIT memory tem lifecycle mais complexo.
Write alias e execute alias podem compartilhar backing.
Release exige:
W^X e TLB lifetime fazem parte do mesmo trust model.
Device-owned resources
DMA pages podem permanecer sob autoridade do device por longo período.
Mesmo sem CPU tocar no buffer naquele instante, hardware ainda pode fazê-lo.
Ownership precisa modelar hardware actors.
Boot resources
O módulo anterior mostrou:
Essas categorias continuam úteis em runtime.
Failure domains
Native user fault
Pode ser atribuído a process e encerrá-lo.
CLVM fault
VM pode produzir bad address, bad jump, stack fault, bad syscall ou arithmetic fault.
Kernel exception
Vai para fatal panic.
IRQ storm
Legacy IRQ pode ser masked.
TLB non-response
CPU pode ser fenced e frame reuse quarantined.
Cada subsystem possui um containment model diferente.
Panic policy
panic faz:
Não existe driver restart após arbitrary ring-0 corruption.
Isso é coerente com shared privileged domain.
Por que restart de driver estilo microkernel não existe hoje
Restart seguro exige que driver esteja fora do core protection domain e que seus recursos possam ser revogados.
Um driver ring 0 com wild pointer pode ter corrompido qualquer global.
Chamar init novamente não restaura integridade.
Essa é a diferença prática entre source modularity e fault isolation.
Hardware authority
CPU rings são apenas uma parte.
Outras authorities incluem:
- paging;
- NX;
- DMA/IOMMU;
- PCI bus master;
- interrupt routing;
- MSRs;
- control registers;
- MMIO.
Trust model completo precisa cobrir todas.
U/S em todos os níveis
MM_USER precisa permitir user access ao longo do page-table walk.
MM propaga user bit em parent entries quando necessário.
Uma leaf correta não basta se parent bloquear.
Por isso page-table helper é TCB.
W^X em native ELF
Loader rejeita PT_LOAD simultaneamente W+X.
Non-executable segments recebem NX.
Isso reduz authority de user pages.
Kernel/JIT possuem outra policy documentada em capítulo próprio.
ELF validation
Loader verifica:
- magic;
- ELF64;
- little endian;
- ET_EXEC;
- x86-64;
- program-header bounds;
- PT_LOAD;
- filesz <= memsz;
- ausência W+X;
- alignment;
- user range;
- non-overlap;
- executable entry.
É parser de trust boundary.
Parser é TCB
ELF malformado deve ser rejeitado sem:
- overflow;
- kernel mapping como user;
- out-of-bounds read;
- W+X;
- entry inválido.
Parser correctness é parte de isolation.
Filesystem é privilegiado
Filesystem frontend, CFS e drivers executam no kernel domain.
Metadata corruption pode virar kernel integrity problem.
Em microkernel, parser poderia estar em server isolado.
Não é o caso atual.
Network parsing é privilegiado
Ethernet, IPv4, UDP, TCP e sockets executam em ring 0.
Packet malformado é input da TCB.
Bounds checks em networking são security properties.
Graphics é privilegiado
Software renderer, resources, VirtIO-GPU, VirGL e code relacionado estão no kernel ELF.
Isso amplia o privileged code surface.
Uma futura arquitetura poderia mover policy/rendering para user mode e manter driver interface estreita.
Não é o placement atual.
Window manager é privilegiado
desktop_run e WM executam em kernel code.
Desktop compositor não é um isolated ring-3 process.
Bug de memory safety no WM tem authority de kernel.
Toolchain é privilegiado no build atual
O makefile liga compiler/linker components ao kernel.
Inclui partes relevantes de:
- ChrisC;
- CLVM;
- JIT;
- KCC;
- ChrisAsm;
- ChrisLd;
- debug/tooling.
Self-hosting amplia a privileged code surface.
Também dá ao sistema capacidade incomum de compilar dentro do próprio ambiente.
Self-hosting e privilege são objetivos diferentes
Um compiler self-hosted pode futuramente rodar em:
- ring 3;
- CLVM;
- isolated service;
- kernel.
A posição atual no kernel não é requisito fundamental do self-hosting.
Kernel tools também estão linkados
Editor, explorer, shell, build tools e support code aparecem na lista de objects.
Isso mostra uma arquitetura atual orientada à experimentação integrada, não minimização da TCB.
É importante documentar esse fato como estado presente.
Research OS e shared privilege
Em um research OS, broad privileged image reduz bootstrap complexity.
Facilita experimentos diretos com:
- paging;
- graphics;
- drivers;
- compilers;
- VM;
- storage;
- networking.
O custo é compartilhar authority e blast radius.
A documentação precisa tornar o trade-off explícito.
Taxonomia não mede qualidade
Monolithic, microkernel e hybrid não determinam qualidade.
Propriedades mais concretas:
- dependency direction;
- interface size;
- ownership;
- synchronization;
- testability;
- fault containment;
- privilege minimization;
- performance;
- observability;
- recoverability.
O ChrisOS deve ser descrito por essas propriedades.
Dependency direction atual
Uma simplificação:
desktop / language / tools
        ↓
graphics / filesystem / network
        ↓
device abstractions
        ↓
MM / PMM / process / IRQ / SMP
        ↓
x86-64 + hardware
Existem cross-links experimentais.
A meta é tornar authority flow progressivamente explícito.
Core versus policy-heavy
kernel/metal contém muitos mechanisms fundamentais.
Mas directory name não define criticidade.
Um DMA driver pode possuir mais authority sobre physical memory do que um grande helper de scheduling.
Security review deve mapear capabilities.
Authority inventory
Modificar page tables
MM e process code relacionado.
Alloc/free physical memory
PMM e callers.
Reprogramar devices
Drivers, PCI, MMIO, port I/O, hwgate.
Executar arbitrary kernel function pointers
job/kthread.
Parse de executables
ELF loader.
Parse de VM bytecode
CLVM.
Parse de network packets
network stack.
Parse de persistent metadata
filesystem.
Esse inventory é mais informativo que diretórios.
API surface versus authority surface
Poucas functions podem carregar enorme authority.
DMA allocator é exemplo.
Muitas helper functions podem ter autoridade pequena.
Review deve ponderar o que o código pode fazer.
Process CR3 ownership
Cada processo possui address-space root.
Kernel upper half é copiado.
User leaves são rastreados.
proc_switch muda CR3 sob invariant BSP-only.
Isso é isolation real dentro de um kernel monolítico.
Kernel thread address space
Kernel thread não recebe process CR3 isolado.
Tem stack própria, mas shared kernel domain.
Logo não é fault domain separado.
Context versus domain
execution context
    registers/stack

address space
    page-table translation

privilege domain
    authority da CPU

software sandbox
    authority imposta pelo interpreter
Kernel thread: context próprio sem privilege domain novo.
CLVM: software sandbox sem necessariamente CPL novo.
Native process: address space + CPL 3.
Scheduler ownership
Existem dois planos:
Future multicore userspace exige tornar vários invariants per-CPU.
Requisitos para multicore userspace
Será necessário revisar:
- current process;
- per-CPU process state;
- syscall return;
- process locks;
- CR3;
- TSS.RSP0 per CPU;
- wakeups;
- user copy;
- process teardown;
- TLB;
- FD/socket concurrency.
BSP-only é boundary explícita.
O que seria necessário para mais microkernel
Mover driver para user process exige:
- address-space isolation;
- IPC;
- interrupt delivery;
- delegated MMIO;
- DMA/IOMMU policy;
- resource revocation;
- restart;
- service discovery;
- recovery.
Mover arquivos de diretório não basta.
Um caminho híbrido possível
Uma arquitetura futura poderia ter:
Mas isso é roadmap conceitual.
Não é o ChrisOS atual.
Nenhum redesign é obrigatório
Monolithic modular é arquitetura válida.
Para research OS focado em mecanismos low-level, pode ser eficiente.
O requisito é documentar corretamente fault/trust boundaries.
Observabilidade
Panic registra:
- CPU;
- CR3;
- RSP;
- build;
- git;
- kernel hash.
Isso é parte da arquitetura.
Quando ring-0 failure tem blast radius global, diagnostics fortes são especialmente importantes.
Build identity
Associar panic ao source exato facilita análise de regressão em uma imagem privilegiada ampla.
Reproducibility melhora investigação.
Host tests e integration
Host tests validam bem:
- algorithms;
- parsers;
- ownership tables;
- filesystem logic;
- VM semantics.
Não provam:
- CPL;
- real page permissions;
- interrupt delivery;
- DMA;
- APIC;
- real devices.
Cada claim deve registrar o nível de evidência.
Validation ladder
source inspection
    ↓
host/unit
    ↓
freestanding compile
    ↓
QEMU
    ↓
SMP/device stress
    ↓
ChrisVM differential
    ↓
real hardware
Não é necessário usar todos os degraus para toda feature.
Mas não se deve confundir um com outro.
Stub precisa continuar visível como stub
ioapic_init ainda registra que PIC roteia IRQ.
Function name não prova feature completa.
Essa regra se aplica a toda documentação do projeto.
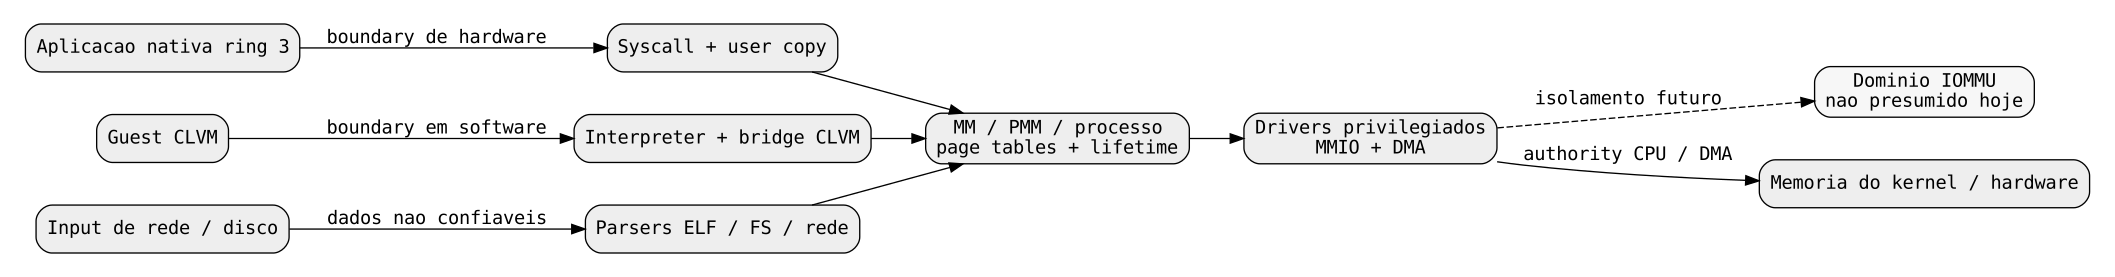
Tabela de trust boundaries
| Boundary | Enforcement | Ring crossing? | Principal risco |
|---|---|---|---|
| native user → syscall | CPL + IDT + paging | sim | bad user input |
| user page → kernel page | U/S page bit | não exige call | mapping bug |
| CLVM guest → CLVM SYS | interpreter checks | não | VM escape |
| kernel module → kernel module | API/disciplina | não | shared-memory corruption |
| kernel → MMIO | mapping + driver | não | device misprogramming |
| driver → DMA | device/IOMMU rules | não | physical-memory corruption |
| CPU → CPU shared state | locks/atomics/TLB | não | race/stale translation |
| disk → filesystem | parser/metadata checks | não | privileged corruption |
| network → parser | bounds checking | não | privileged parser bug |
Ring 0/3 é apenas uma das boundaries.
Privilege minimization futura
Se reduzir TCB virar objetivo, candidatos podem ser classificados por necessidade real de ring 0.
Possíveis candidatos:
- desktop/window manager;
- compiler frontends;
- filesystem policy;
- network services;
- high-level device policy.
Mesmo quando mechanism precisa de ring 0, policy pode às vezes sair.
Isso é uma opção arquitetural futura.
Driver isolation é difícil
Driver pode precisar de:
- MMIO;
- interrupts;
- DMA;
- PCI config;
- pinned physical pages.
User-mode driver seguro exige delegation explícita para cada poder.
Não é apenas questão de performance de IPC.
CLVM como laboratório intermediário
CLVM já possui:
- guest memory;
- checked offsets;
- syscall dispatch;
- per-slot resources;
- capabilities;
- fault states.
Isso pode ser útil para experimentar contracts mais estreitos.
Mas CLVM não equivale a hardware-isolated microkernel server.
Interpreter e bridges continuam TCB.
Native ring 3 é isolamento de hardware mais forte
Para componentes que cabem no native process model, ring 3 fornece boundary arquitetural independente de interpreter correctness.
Isso torna o native path importante para eventual privilege reduction.
Porém user-copy precisa amadurecer junto.
Maturidade de user-copy
A auditoria já marca hostile pointer handling como incompleto em alguns caminhos.
Antes de userspace complexo, serão necessários primitives fortes para:
- copy_from_user;
- copy_to_user;
- bounded strings;
- range checks;
- overflow-safe span;
- partial copy;
- fault recovery.
Userspace maior aumenta essa importância.
Handles versus raw authority
Uma architecture isolada evita expor arbitrary physical addresses e MMIO pointers.
Handles/capabilities representam authority delegada.
Alguns paths CLVM já caminham nessa direção.
Native userspace pode evoluir de forma semelhante.
Global state é principal pressão do modular monolith
Modules escalam pior quando se comunicam por globals sem contracts.
Para cada global relevante, documentação deve identificar:
- initializer;
- owner;
- readers;
- writers;
- lock;
- IRQ context;
- CPU policy;
- teardown;
- failure behavior.
Isso converte estado implícito em arquitetura explícita.
Process table atual
Process state é global e user scheduler é BSP-only.
A futura transição SMP não é apenas adicionar spinlock.
O modelo de ownership precisa mudar para per-CPU.
Job queue atual
Job queue usa spinlock e atomic counters.
É work distribution do kernel, não user scheduler.
AP workers consomem a queue.
Essa separação é útil.
Filesystem state atual
Frontend escolhe backend global.
CFS possui locking próprio.
Funciona em um shared kernel domain, mas filesystem bug continua kernel bug.
Network state atual
Network mantém protocol state e socket tables globais.
LOCKING.md já registra a lacuna de socket locking caso receive e syscall fiquem realmente concorrentes.
Graphics state atual
Graphics combina global device/render state com contexts por slot.
Ownership é misto, mas tudo continua dentro de ring 0.
Window manager atual
desktop_run chama network poll, CLVM frame, language tick, desktop frame e gfx_present.
É policy-heavy code com privilégio máximo.
Esse é o estado atual.
Compiler/JIT atual
Compiler/JIT são ligados no kernel.
JIT também manipula executable mappings e cruza diretamente MM/TLB.
Nesse projeto, compiler correctness e kernel memory safety ficam mais próximos que em sistemas onde compiler é user application.
Source Atlas
Como o privileged image é amplo, source mapping detalhado é importante.
Atlas gerado ajuda a responder:
- onde authority está;
- qual source implementa claim;
- qual revision foi revisada;
- quando docs ficaram stale.
Isso é especialmente relevante para evolução por agentes de IA.
AI e architecture contracts
Agentes podem manter compilação enquanto quebram invariants.
Contracts verificáveis ajudam.
Exemplos:
- user scheduler continua BSP-only;
- user ELF usa MM_USER;
- W+X é rejeitado;
- kernel modules continuam no mesmo privileged image até mudança intencional;
- kthread não implica process isolation;
- CLVM offsets continuam bounds-checked;
- frame reuse espera TLB safety.
O checker deste capítulo fixa alguns desses pontos.
Checker reproduzível
scripts/check_kernel_model_examples.py valida:
- kernel de produção liga objects de metal, fs, gfx, net, wm, lang e compiler;
- native user entry usa selectors ring 3 e IRETQ;
- vector 0x80 é user-accessible;
- user ELF usa MM_USER;
- W+X user PT_LOAD é rejeitado;
- proc_switch mantém BSP-only;
- syscall_dispatch rejeita AP;
- kthread muda stack mas não CR3/ring;
- CLVM possui bounds checks explícitos;
- CLVM SYS é software-dispatched;
- panic desabilita interrupts e para;
- RESOURCE_OWNERSHIP liga processo a teardown de resources;
- LOCKING registra lock order e limitation de socket;
- hwgate executa privileged PCI/MMIO/DMA dentro do kernel.
É source-contract checker.
Não prova ausência de memory bugs.
Resumo arquitetural atual
kernel type:
    monolítico modular

kernel privilege:
    ring 0

major services:
    linkados em kernel.elf

native application boundary:
    ring 3 + paging + INT 0x80

CLVM boundary:
    software VM + bounds + SYS

kernel jobs:
    ring-0 work em BSP/AP

kernel threads:
    stacks separadas, shared privilege

native user scheduling:
    BSP-only

fatal kernel fault:
    panic + halt

driver isolation:
    sem protection domain separado

IOMMU:
    não presumido

desktop/window manager:
    kernel code

compiler/JIT:
    grande parte no kernel image
O que o ChrisOS não é hoje
Não é atualmente:
- microkernel com filesystem/driver servers isolados;
- capability microkernel com service domains em hardware;
- native scheduler multicore completo;
- restartable driver architecture;
- minimal-TCB kernel;
- IOMMU-enforced DMA sandbox;
- sistema com compositor desktop isolado em ring 3.
Essas distinções evitam claims maiores que a implementação.
Foundations que já ajudam evolução futura
O source atual já possui:
- ring-3 entry real;
- per-process CR3;
- MM_USER;
- ELF validation;
- user fault containment;
- resource ownership;
- module interfaces;
- block-device abstraction;
- VM sandbox;
- selected capability checks;
- SMP job separation;
- lock documentation;
- TLB shootdown;
- build/source traceability.
Isso permite privilege reduction incremental no futuro.
A arquitetura deve seguir os fatos
Este capítulo precisa mudar quando mudar:
- privilege placement;
- kernel object graph;
- syscall mechanism;
- user scheduling;
- CLVM execution domain;
- driver isolation;
- DMA isolation;
- kernel-thread model;
- panic/recovery;
- TCB assumptions.
A taxonomia deve seguir a implementação.
Limite de validação
Capítulo reconciliado com:
A classificação é baseada em placement real, makefile e protection boundaries, não preferência nominal.
Execute:
Gatilhos de revisão
Revisar quando:
- major service sair de kernel.elf;
- native ring-3 services crescerem;
- syscall sair de INT 0x80;
- user scheduling virar multicore;
- kernel threads ganharem address spaces separados;
- CLVM migrar de execution domain;
- drivers virarem isolated services;
- IOMMU for configurado;
- desktop/WM sair para userspace;
- compiler/JIT mudar privilege;
- panic ganhar subsystem recovery;
- object graph do makefile mudar o privileged image.
Referências primárias
- Intel 64 and IA-32 Software Developer's Manual, protection e paging.
- AMD64 Architecture Programmer's Manual.
- Liedtke, On Micro-Kernel Construction.
- seL4 reference material sobre capability-oriented isolation.
- Linux kernel documentation como comparação de modular monolithic design.
- Sources ChrisOS e documentos internos listados no front matter.