
Memória virtual e construção de espaços de endereçamento
Sobre este capítulo Frames e tradução de endereços
Neste capítulo
- Memória virtual e construção de espaços de endereçamento
- Escopo
- Modelo arquitetural de tradução
- Metades canônicas e a divisão usada pelo ChrisOS
- Page tables são objetos físicos
- Inicialização: adoção da hierarquia ativa
- Criação de mapping no kernel
- Mapping em um CR3 arbitrário
- Flags e proteção
- Mappings de MMIO
- Tradução sem dereference
- Ownership do processo é separado da tradução
- Demand paging no modelo atual
- Unmap e lifetime das frames
- Destruição do espaço de processo
- Troca de CR3 e estado de TLB
- Concorrência e lock ordering
- Complexidade e custo de memória
- Evidência de validação
- Limitações atuais
- Fronteira de revisão
Escopo
Memória virtual é o mecanismo que desacopla o endereço produzido por uma instrução da frame física ou do registrador de dispositivo efetivamente acessado. Em x86-64, o estado de tradução selecionado por CR3 faz parte do contexto arquitetural de execução: o mesmo endereço virtual pode resolver para memórias físicas diferentes em espaços de endereçamento distintos, pode ser inválido em um contexto e válido em outro, ou pode apontar intencionalmente para o mesmo mapping compartilhado do kernel.
O ChrisOS usa atualmente o modelo de paginação x86-64 em quatro níveis já estabelecido pelo ambiente de boot. O kernel não descarta a hierarquia criada no boot para reconstruir todos os mappings do kernel do zero durante mm_init. Em vez disso, lê o CR3 ativo, registra a raiz física em mm_cr3_phys, adota essa hierarquia como autoridade do espaço do kernel e a estende incrementalmente para MMIO, testes e mappings ligados a processos.
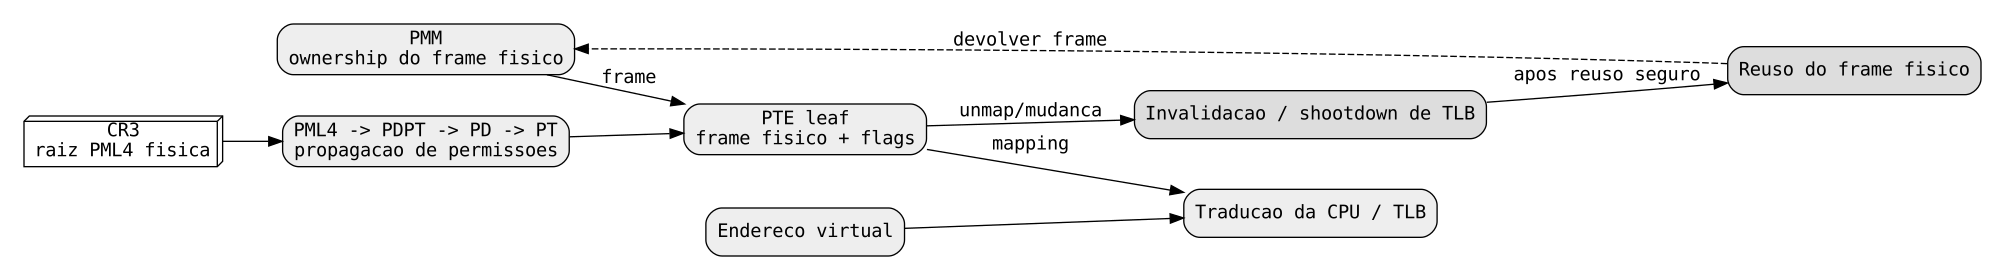
A implementação atual deve ser entendida como três mecanismos cooperantes:
- PMM possui as frames físicas.
- MM possui as estruturas de tradução e as mutações das page tables.
- A camada de processos registra quais frames folha pertencem a cada processo de usuário.
Esses mecanismos não são fundidos em um único alocador.
Modelo arquitetural de tradução
Para uma página convencional de 4 KiB em paginação x86-64 de quatro níveis, um endereço virtual canônico é decomposto em quatro índices de 9 bits e um deslocamento de 12 bits:
63                         48 47    39 38    30 29    21 20    12 11      0
+----------------------------+--------+--------+--------+--------+----------+
| extensão canônica de sinal | PML4   | PDPT   | PD     | PT     | offset   |
+----------------------------+--------+--------+--------+--------+----------+
                              9 bits   9 bits   9 bits   9 bits   12 bits
Cada tabela contém 512 entradas. Como cada entrada tem oito bytes, uma page table completa ocupa exatamente 4096 bytes. Portanto, cada página de page table também é uma frame comum administrada pelo PMM.
Para um endereço virtual V, os helpers atuais calculam:
pml4 = (V >> 39) & 0x1ff
pdpt = (V >> 30) & 0x1ff
pd   = (V >> 21) & 0x1ff
pt   = (V >> 12) & 0x1ff
off  = V & 0xfff
O processador começa na raiz física armazenada em CR3. Um walk normal de 4 KiB segue PML4E -> PDPTE -> PDE -> PTE e combina o endereço de frame alinhado da PTE com o offset de 12 bits.
O ChrisOS também entende folhas de huge pages ao traduzir mappings existentes. translate_leaf reconhece uma folha com PS no nível PDPT como mapping de 1 GiB e uma folha com PS no nível PD como mapping de 2 MiB. As rotinas públicas de mapping, porém, criam apenas mappings de 4 KiB. Se map_4k encontra uma huge page em um nível pelo qual precisaria descer, a topologia é tratada como não suportada e o kernel entra em panic; não há divisão automática da huge page.
Metades canônicas e a divisão usada pelo ChrisOS
No modelo de quatro níveis e 48 bits, índices PML4 de 0 a 255 representam a metade canônica inferior, enquanto 256 a 511 representam a metade canônica superior.
O ChrisOS usa essa propriedade diretamente na construção de um espaço de processo. mm_clone_kernel_space aloca uma PML4 nova e zerada e copia apenas as entradas 256..511 da PML4 do kernel.
| Região | Entradas PML4 | Modelo atual de ownership |
|---|---|---|
| Metade de usuário | 0..255 | Hierarquia privada criada para o processo |
| Metade do kernel | 256..511 | Referências de topo compartilhadas copiadas do kernel |
| Frame da PML4 | uma por processo | Alocada pelo PMM |
| Frames folha de usuário | específicas do processo | Registradas em Proc.pages |
| Frames folha do kernel | compartilhadas/kernel | Não são liberadas no teardown do processo |
Essa divisão é uma fronteira estrutural de isolamento. Um processo novo não herda mappings inferiores de outro processo, mas recebe as referências superiores necessárias para executar o kernel.
As entradas copiadas apontam para as mesmas tabelas inferiores do kernel; não são deep copies. Por isso, o teardown do processo jamais pode liberar recursivamente a metade superior. mm_free_user_space aplica essa regra caminhando somente pelos índices PML4 menores que 256.
Page tables são objetos físicos
Uma entrada de page table contém endereço físico. O kernel, porém, precisa de um endereço virtual para ler ou modificar a página que contém a tabela.
table_from_phys mascara os bits de flags, obtém a frame física e chama bootinfo_phys_to_virt. Essa conversão usa a relação de direct map entregue pelo boot e documentada no capítulo de HHDM.
entrada da page table
        |
        | endereço físico da tabela filha
        v
table_from_phys
        |
        | conversão HHDM
        v
ponteiro virtual do kernel para a tabela
Assim, MM depende simultaneamente de PMM e HHDM. PMM fornece frames para novas tabelas; HHDM permite que o kernel acesse diretamente essas frames para zerá-las e preencher entradas.
Inicialização: adoção da hierarquia ativa
mm_init executa uma sequência deliberadamente pequena:
- inicializa mm_lock;
- inicializa o protocolo de runtime de TLB;
- lê CR3;
- mascara CR3 para obter a raiz física;
- inicializa o cursor da janela virtual de MMIO;
- marca MM como pronto;
- traduz o endereço virtual do framebuffer informado pelo boot;
- entra em panic se a tradução do framebuffer falhar.
O ponto essencial é o que a função não faz: mm_init não sintetiza toda a árvore de page tables do kernel. Ela adota a hierarquia ativa proveniente do boot e valida uma tradução da qual a interface gráfica depende.
Portanto, o contrato de paginação criado pelo bootloader faz parte do contrato atual de memória do kernel. Um loader nativo futuro poderia mudar a origem dessa hierarquia, mas isso não descreve o estado atual.
Criação de mapping no kernel
map_4k e map_4k_nosync operam sobre mm_cr3_phys, a raiz do kernel.
O fluxo interno de map_4k_ex é:
validar MM inicializado
validar alinhamento de 4 KiB
adquirir mm_lock
percorrer PML4 -> PDPT -> PD -> PT
alocar e zerar tabelas intermediárias ausentes
instalar PTE = frame física | flags | PRESENT
liberar mm_lock
opcionalmente executar INVLPG no endereço local
ensure_table aloca uma página intermediária com pmm_alloc, zera as 512 entradas e a liga ao nível pai com PRESENT | WRITE. Nessa API de kernel, falha de alocação é fatal: alloc_zero_table chama panic.
Esse comportamento combina com caminhos de configuração do kernel nos quais a ausência de uma tradução obrigatória ainda não possui recuperação.
map_4k_nosync omite apenas o INVLPG final. A mutação da estrutura continua protegida por mm_lock.
Mapping em um CR3 arbitrário
mm_map_cr3 é a interface recuperável usada para construir mappings de processos.
Ela difere de map_4k porque:
- recebe o CR3 de destino;
- retorna -1 em estado inválido ou desalinhamento;
- usa alloc_zero_table_try para que falta de memória possa ser reportada;
- propaga MM_USER pelos níveis intermediários quando o mapping é de usuário.
A propagação de USER é necessária na arquitetura. Não basta colocar U/S na PTE folha; todos os níveis percorridos precisam permitir o acesso de usuário. ensure_table_flags, portanto, adiciona MM_USER a uma entrada pai existente quando necessário.
As tabelas intermediárias são ligadas com WRITE. As permissões finais da folha continuam sob responsabilidade do chamador.
Construção parcial quando a alocação falha
A operação atual não implementa rollback transacional.
Se uma nova PDPT for alocada e ligada à PML4, mas a alocação posterior de uma PD ou PT falhar, mm_map_cr3 retorna -1. A tabela intermediária já criada permanece alcançável pela raiz.
Isso não é uma frame perdida fora da estrutura: ela pode ser reutilizada por um mapping posterior e será recuperada por mm_free_user_space durante a destruição do processo. Entretanto, uma chamada que retorna falha ainda pode ter alterado a forma da árvore.
Assim, o significado correto do retorno é “o mapping folha solicitado não foi instalado”, e não “nenhum bit da hierarquia foi modificado”.
Flags e proteção
mm.h expõe os nomes usados atualmente para bits arquiteturais relevantes:
| Flag | Uso atual |
|---|---|
| MM_PRESENT | entrada participa da tradução |
| MM_WRITE | escrita é permitida naquele nível |
| MM_USER | acesso em user mode é permitido naquele nível |
| MM_PWT | controle de cache write-through |
| MM_PCD | controle de cache disable |
| MM_NX | proíbe fetch de instrução quando NX está ativo |
A API de mapping adiciona PRESENT à entrada folha mesmo se o chamador já o forneceu.
Ainda não existe uma camada genérica de política de memória que expresse W^X, copy-on-write, guard pages, memory protection keys, PCIDs ou permissões de VMAs. A política atual é representada por flags explícitas em cada ponto de chamada.
Mappings de MMIO
Dispositivos mapeados em memória possuem requisitos de cache e execução diferentes da RAM comum.
map_mmio_page reserva endereços virtuais em uma janela fixa de 256 páginas iniciada em 0xffffffff90000000. Cada página é instalada com:
Assim, o mapping atual é gravável, com controles de cache adequados a MMIO e não executável. mmio_next apenas avança; ainda não existe free list para reutilizar espaço virtual dessa janela. Esgotar as 256 páginas causa panic.
O endereço físico recebido deve estar alinhado a 4 KiB.
Tradução sem dereference
Há dois walkers de software relevantes.
mm_virt_to_phys percorre a hierarquia do kernel em mm_cr3_phys. Retorna zero quando uma entrada necessária está ausente e entende folhas de 1 GiB, 2 MiB e 4 KiB.
mm_translate recebe um CR3 arbitrário e retorna:
- endereço físico final, incluindo o offset dentro da página;
- flags da entrada folha.
O walk ocorre sob mm_lock, impedindo que o leitor observe uma mutação de page table pela metade.
Isso é diferente de simplesmente dereferenciar um ponteiro não confiável. Um walk explícito permite verificar existência e permissões do mapping antes do acesso efetivo.
Ownership do processo é separado da tradução
Uma PTE válida não informa quem possui a frame física.
Proc mantém uma lista explícita e de capacidade fixa. Cada ProcPage armazena uma página virtual e a frame física correspondente. proc_commit executa:
- alinha o endereço virtual para baixo em 4 KiB;
- retorna sucesso se a página já estiver registrada;
- rejeita se Proc.pages estiver cheio;
- aloca uma frame física com PMM;
- zera os 4096 bytes usando HHDM;
- cria o mapping via proc_map_user -> mm_map_cr3;
- em falha de mapping, devolve a frame ao PMM;
- em sucesso, registra o par virtual/físico em Proc.pages;
- se o processo for o atual, executa mm_flush_tlb.
A ordem preserva ownership explícito: alocação física ocorre antes do mapping e o processo só passa a registrar a frame após a instalação bem-sucedida da tradução.
Demand paging no modelo atual
O ChrisOS implementa uma forma limitada de alocação sob demanda.
proc_set_vm grava o tamanho lógico solicitado e materializa apenas a primeira página. As demais podem aparecer posteriormente em resposta a page fault.
Para a exceção de vetor 14, irq_dispatch lê CR2 e chama primeiro proc_fault_demand para o processo atual. Essa função alinha CR2 e verifica se a página pertence a uma região cuja expansão é permitida:
- região VM declarada;
- pequena janela de crescimento da stack;
- heap abaixo de heap_brk;
- faixa de framebuffer do processo.
Quando elegível, proc_commit aloca e mapeia a página e a execução pode retornar à instrução que falhou. Se o fault não puder ser atendido e o CS salvo indicar user mode, o caminho de falha de usuário é acionado. Page faults restantes entram no tratamento de exceção fatal do kernel.
Esse mecanismo é demand allocation, não um gerenciador completo de memória virtual. Não há atualmente swap, mmap de arquivo, copy-on-write de fork, política de overcommit, árvore de VMAs ou algoritmo de page replacement.
Unmap e lifetime das frames
mm_unmap_cr3 apenas limpa uma folha de 4 KiB do espaço informado. A função não libera a frame física.
Se o CR3 informado for também o CR3 ativo no CPU atual, a função executa INVLPG local. Para um espaço que não está ativo nesse CPU, esse INVLPG local não é necessário.
proc_release_user combina as duas responsabilidades na ordem correta:
para cada ProcPage:
    limpar PTE com mm_unmap_cr3
    liberar a frame com pmm_free
limpar a lista de páginas
Processos de usuário atualmente executam somente no BSP. proc_switch entra em panic se a troca de processo for tentada a partir de um AP. Essa restrição reduz o problema de coerência de TLB para mappings privados de usuário.
Mappings de kernel são diferentes porque a metade superior é compartilhada e pode estar ativa em vários CPUs. Remover um mapping compartilhado exige o protocolo separado de shootdown/quarentena antes que uma frame física seja considerada segura para reutilização.
Destruição do espaço de processo
Depois que as frames folha foram liberadas pela camada de ownership do processo, mm_free_user_space destrói a estrutura restante da metade de usuário.
A função percorre as entradas PML4 0..255 e libera recursivamente tabelas intermediárias não-huge. A recursão para antes de interpretar endereços de frames folha como se fossem páginas de tabela. Por fim, a própria PML4 do processo é liberada.
Duas invariantes são essenciais:
- tabelas compartilhadas do half superior não são liberadas;
- frames folha de usuário precisam ter sido tratadas previamente pela lista Proc.pages.
Quebrar a segunda regra pode provocar leak de frames ou confusão entre frames de dados e frames de page table.
Troca de CR3 e estado de TLB
mm_switch escreve diretamente a raiz física recebida em CR3. proc_switch atualiza o índice global do processo atual e chama mm_switch com o CR3 desse processo.
mm_flush_tlb lê CR3 e escreve o mesmo valor novamente. No modelo atual, sem PCID, isso funciona como uma invalidação local ampla utilizada após determinadas alterações de mapping.
Para alterações pontuais, map_4k e unmap_4k usam INVLPG local. A invalidação entre CPUs exige protocolo próprio porque modificar uma PTE em RAM não apaga uma tradução já armazenada no TLB de outro processador.
Concorrência e lock ordering
Walks e mutações centrais de page tables são protegidos por mm_lock.
mm_enter não é apenas um spinlock passivo. Enquanto espera, chama mm_tlb_poll e depois tenta adquirir o lock novamente. Dessa forma um CPU bloqueado esperando MM continua capaz de participar de um protocolo de TLB pendente.
O shootdown remoto, por sua vez, evita manter mm_lock enquanto espera acknowledgements. O próprio código registra o motivo: uma interrupção no mesmo CPU poderia tentar mapear memória, bloquear no mm_lock e impedir para sempre a continuação do waiter.
A sincronização atual separa:
- mm_lock para consistência estrutural das page tables;
- mm_tlb_busy para serializar publicações de shootdown;
- o protocolo de runtime de TLB para invalidação entre CPUs e decisão de reutilização segura.
Complexidade e custo de memória
O walk de quatro níveis tem profundidade arquitetural fixa: no máximo quatro consultas de tabela.
| Operação | Custo assintótico atual |
|---|---|
| mapear uma página de 4 KiB | O(1), walk de profundidade fixa |
| traduzir um endereço | O(1) |
| remover uma folha de 4 KiB | O(1) |
| clonar topo do kernel | O(256) cópias de entrada |
| destruir hierarquia de usuário | O(número de entradas intermediárias presentes) |
| INVLPG local de uma página | O(1) arquiteturalmente |
| invalidação de faixa | O(número de páginas) + coordenação remota |
A estrutura é esparsa. Um mapping isolado pode exigir até três novas páginas intermediárias além da PML4 já existente. Mappings vizinhos reutilizam essas tabelas; portanto regiões densas amortizam o overhead, enquanto espaços muito esparsos pagam mais memória de metadados por página efetiva.
Evidência de validação
mm_selftest exercita propriedades relevantes:
- uma frame nova do PMM é mapeada em MM_TEST_VIRT e observada de forma coerente tanto pelo alias criado quanto pelo alias HHDM;
- a página física do LAPIC é mapeada por map_mmio_page e lida por seu endereço virtual resultante.
mm_init também trata a tradução válida do framebuffer de boot como uma invariante obrigatória.
Esses testes cobrem caminhos concretos de mapping e tradução. Eles não constituem prova exaustiva de combinações de permissão, interações com huge pages, estados de OOM parcial ou corridas de invalidação multiprocessada.
Limitações atuais
A implementação atual é menor que um subsistema de VM de produção. Ela ainda não oferece:
- paginação de cinco níveis;
- rollback transacional de alocação de page tables;
- criação ou split transparente de huge pages;
- troca de espaços usando PCID;
- copy-on-write;
- mappings de arquivo;
- swap ou page replacement;
- colocação NUMA-aware;
- VMAs genéricas;
- reutilização da janela virtual de MMIO;
- metadados completos de lifetime por mapping dentro de MM.
A camada de processos também usa arrays fixos de ownership em vez de uma estrutura escalável de regiões virtuais.
Essas são limitações do ChrisOS nessa revisão, não limitações da arquitetura x86-64.
Fronteira de revisão
Este capítulo foi reconciliado com ChrisOS main na revisão e05a17fd76333114a3fb5c2452f38ca747d4ac56.
O comportamento corrente é definido pelos arquivos e símbolos declarados no frontmatter. Planos futuros não devem ser interpretados como implementação presente. Qualquer mudança em MM, ownership de processos, protocolo de TLB ou contrato de paging do boot exige nova revisão deste capítulo.