
Execução out-of-order, register renaming e retirement
Sobre este capítulo Datapath, microarquitetura e ISA
Neste capítulo
- Execução out-of-order, register renaming e retirement
- Escopo
- Por que execução in-order desperdiça paralelismo
- Dependências verdadeiras e falsas
- Registradores arquiteturais e físicos
- Por que o mapping antigo não pode ser liberado imediatamente
- Free list
- Reorder Buffer
- Instruction window e scheduler
- Complexidade de wakeup/select
- Readiness de physical registers
- Unidades de execução
- Completion e retirement não são sinônimos
- Exceções precisas
- Modelo atual de exceção do ChrisCPU versus OoO
- Rename checkpoints para recovery
- Committed map e speculative map
- Operações de memória e Load/Store Queue
- Store-to-load forwarding
- Memory disambiguation
- Stores fazem commit de forma diferente de resultados em registradores
- Branches dentro do ROB
- Backpressure de recursos
- Retirement
- Retirement em ordem e operações serializantes
- Renaming de flags
- Registradores parciais
- Micro-ops
- Common Data Bus como abstração didática
- Tomasulo e renaming moderno
- Visão de dataflow
- Head-of-line blocking no retirement
- Tamanho da janela e latency hiding
- Interrupções e retirement boundary
- TLB e side effects de tradução
- Operações atomic/locked
- Modelo atual de execução do ChrisCPU
- Fronteira de refatoração para um backend OoO
- Estruturas mínimas propostas
- Ordenação de fases por ciclo
- Accounting de recursos em recovery
- Invariantes
- Validação diferencial
- Casos direcionados
- Métricas de desempenho
- Complexidade no simulador
- Limitações atuais
- Fronteira de roadmap
- Registro de revisão
Escopo
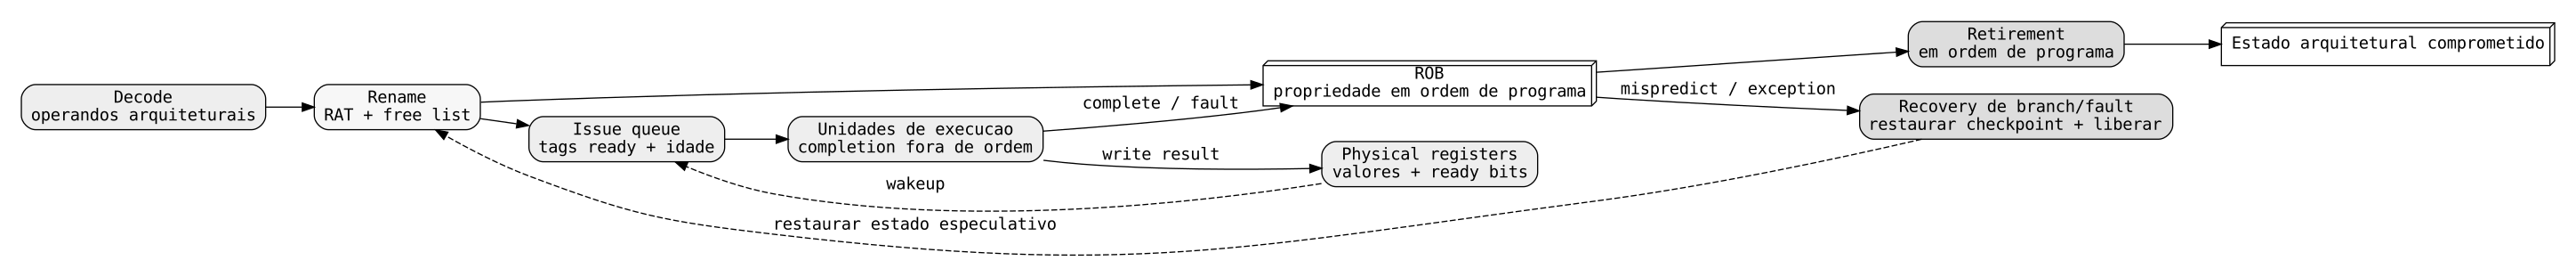
Um pipeline consegue sobrepor instruções e fazer forwarding, mas uma máquina in-order ainda perde trabalho útil quando uma instrução antiga espera uma dependência de alta latência. Execução out-of-order (OoO) separa ordem de programa de ordem de execução: operações mais novas e independentes podem executar enquanto operações anteriores aguardam, desde que o estado arquitetural seja comprometido como se as regras da ISA tivessem sido respeitadas.
Isso exige mais que um scheduler. Um projeto OoO completo precisa de mecanismos para:
- identificar dependências verdadeiras;
- eliminar dependências falsas causadas por nomes de registradores;
- alocar armazenamento para resultados especulativos;
- rastrear operands prontos;
- selecionar operações prontas para unidades de execução;
- preservar a ordem original do programa;
- manter exceções precisas;
- controlar stores e outros efeitos irreversíveis;
- recuperar branch misprediction;
- liberar recursos físicos de forma segura.
O princípio central é:
A execução pode ocorrer fora de ordem; o retirement arquitetural precisa preservar a abstração de ordem definida pelo programa.
A implementação atual do ChrisCPU não contém reorder buffer, physical register file, rename map, issue queue, load/store queue ou retirement engine. Ela executa uma instrução completamente antes da próxima. Este capítulo documenta teoria microarquitetural e uma possível evolução temporal futura, deixando explícitas as fronteiras com o source atual.
Por que execução in-order desperdiça paralelismo
Considere:
I1: load rax, [slow_address]
I2: add  rbx, rax
I3: add  rcx, rdx
I4: xor  r8, r9
I2 depende verdadeiramente de I1. I3 e I4 não dependem.
Uma máquina de issue in-order pode bloquear I3 e I4 atrás de I2 enquanto aguarda o load. Um scheduler OoO consegue observar:
- I2 ainda não está ready porque RAX depende de I1;
- I3 está ready;
- I4 está ready.
Assim, I3 e I4 podem executar enquanto I1 aguarda.
OoO explora instruction-level parallelism (ILP) já existente no programa. O hardware não remove dependências verdadeiras; ele encontra nós independentes do grafo de dados que estão prontos antes da posição textual sugerir.
Dependências verdadeiras e falsas
Três classes de dependência de registradores importam.
RAW — read after write
I1: rax <- ...
I2: ... <- rax
É dependência verdadeira. I2 precisa do valor de I1. Renaming não remove RAW.
WAR — write after read
I1: ... <- rax
I2: rax <- ...
É uma anti-dependência causada pela reutilização do nome arquitetural. I1 precisa observar o RAX antigo antes de I2 sobrescrevê-lo.
WAW — write after write
I1: rax <- ...
I2: rax <- ...
As duas instruções usam o mesmo nome de destino. O resultado arquitetural final precisa vir de I2.
Register renaming associa cada definição a um physical register diferente. WAR e WAW deixam de ser restrições de scheduling porque as definições não dividem o mesmo armazenamento físico.
Registradores arquiteturais e físicos
A ISA expõe RAX. Internamente, uma máquina OoO pode mapear RAX para P37.
Uma Rename Map Table (RAT) contém:
registrador arquitetural -> physical register especulativo mais novo
Exemplo inicial:
RAX -> P5
RBX -> P9
Para:
I1: ADD RAX, RBX
Rename faz:
- fonte RAX -> P5;
- fonte RBX -> P9;
- aloca novo physical register P37;
- destino RAX -> P37 no mapa especulativo;
- registra P5 como mapping antigo para liberação posterior.
A operação renomeada passa a ser:
P37 <- P5 + P9
Um consumidor posterior de RAX passa a referenciar P37 antes mesmo do retirement de I1.
Por que o mapping antigo não pode ser liberado imediatamente
Quando RAX muda de P5 para P37, P5 ainda pode ser necessário:
- uma instrução anterior em voo pode ler P5;
- recovery de branch pode precisar restaurar o mapping anterior;
- o estado comprometido ainda pode referenciar P5 até I1 fazer retirement.
Invariante:
Um physical register só pode voltar à free list quando nenhum consumidor anterior, committed map ou checkpoint ainda puder referenciá-lo.
Liberação precoce produz corrupção silenciosa.
Free list
A free list rastreia physical registers disponíveis.
Operações:
allocate():
    remover um registrador livre

release(p):
    devolver p após provar fim da vida útil
Implementações possíveis:
- bitmap;
- stack;
- queue;
- circular free list.
Para P registros físicos, um bitmap pode exigir O(P/word_size) scan no pior caso se não houver hint/hierarquia. Stack ou queue permite O(1), mas recovery especulativo precisa devolver registros alocados no caminho errado sem duplicá-los.
Um simulador deve rastrear ownership explicitamente. Um simples contador sequencial não é suficiente quando há wrap, flush e checkpoints.
Reorder Buffer
O Reorder Buffer (ROB) mantém instruções em ordem de programa mesmo quando elas executam fora de ordem.
Uma entrada conceitual pode conter:
| Campo | Significado |
|---|---|
| valid | slot possui instrução em voo |
| sequence | idade monotônica |
| RIP | endereço arquitetural |
| op | instrução/micro-op |
| destination architectural reg | nome arquitetural afetado |
| new physical reg | local do novo resultado |
| old physical reg | mapping a liberar no retirement |
| completed | execução terminou |
| exception | fault adiado |
| branch metadata | prediction/checkpoint |
| store metadata | efeito pendente |
| result/status | dados necessários ao retirement |
Alocação no ROB é feita em ordem de programa. Completion pode ocorrer em outra ordem. Retirement sempre examina primeiro a entrada mais antiga.
Se o head ainda não completou, instruções posteriores completas normalmente não podem fazer retirement além dele.
Instruction window e scheduler
Após rename, as operações aguardam operands e execution units.
Uma issue queue pode rastrear:
- IDs dos source physical registers;
- ready bits;
- destination physical register;
- operation class;
- immediate;
- age/ROB index;
- recurso de execução necessário;
- metadata de memória.
Wakeup ocorre quando um produtor completa e anuncia que seu destination physical register ficou ready.
Conceitualmente:
para cada destination P completado:
    para cada source aguardando:
        se source.phys == P:
            source.ready = true

selecionar operações ready
respeitando disponibilidade de unidades e políticas
Hardware real faz muitas comparações em paralelo. Um simulador pode usar readiness arrays ou consumer lists para reduzir scans.
Complexidade de wakeup/select
Uma implementação ingênua com Q entradas e S fontes por instrução pode fazer O(Q*S) verificações por resultado completado.
Com W resultados por ciclo:
O(W * Q * S)
Estruturas melhores para simulador:
- readiness array por physical register;
- lista de consumidores por tag;
- filas por execution class;
- scheduler event-driven.
No hardware, o problema aparece como fanout, comparadores, wires e arbitragem. No software, como custo algorítmico. São manifestações diferentes do mesmo crescimento da instruction window.
Readiness de physical registers
Cada physical register pode ter:
- allocated/free;
- ready/not-ready;
- value;
- opcionalmente producer identity.
Em rename, destino novo é marcado not-ready.
Quando seu produtor conclui:
phys[new_dst].value = result
phys[new_dst].ready = true
Consumidores podem acordar imediatamente mesmo antes do retirement do produtor.
Isso separa result availability de architectural commitment.
Unidades de execução
OoO não significa que qualquer operação roda em qualquer lugar.
Pode haver:
- integer ALUs;
- branch units;
- shift units;
- multiply/divide units;
- AGUs;
- load units;
- store-data units;
- vector units.
O scheduler seleciona operações ready compatíveis com a capacidade disponível.
Uma operação pode estar data-ready e ainda bloqueada por recurso. Isso é structural hazard localizado no scheduler, não necessariamente um freeze global.
Operações de latência variável precisam de eventos explícitos de completion.
Completion e retirement não são sinônimos
Completion: a execução produziu resultado ou fault.
Retirement: a instrução é a operação arquitetural mais antiga elegível e seus efeitos externos são aceitos.
Um ADD pode completar cedo e aguardar retirement porque um cache miss antigo está no ROB head.
Uma instrução mais nova também pode completar com exception descriptor. A exceção só é entregue quando alcançar a fronteira de retirement e continuar válida no caminho correto.
Exceções precisas
Uma exceção precisa deve fazer a máquina parecer como se:
- todas as instruções mais antigas tivessem sido comprometidas;
- a instrução com fault não tivesse produzido efeitos posteriores ao ponto arquitetural definido;
- nenhuma instrução mais nova tivesse feito commit.
Quando o ROB head possui exception:
- instruções anteriores já foram retiradas;
- não comprometer destino normal da instrução com fault;
- flush de todas as mais novas;
- restaurar rename/predictor state para committed state;
- entregar exceção com RIP e error code corretos.
Essa é uma razão fundamental para não chamar um handler arquitetural diretamente durante speculative execution.
Modelo atual de exceção do ChrisCPU versus OoO
No ChrisCPU atual, helpers podem chamar chris_raise durante a execução. Isso é correto porque o interpretador sequencial não possui instruções mais novas em voo.
Em OoO, isso seria inseguro. Uma instrução pode gerar page fault e depois ser removida por branch anterior.
Um backend especulativo deveria produzir:
ExecResult {
    value;
    flags;
    fault_valid;
    fault_vector;
    fault_error;
    memory_effect;
    control_effect;
}
A ROB entry armazena esse resultado até retirement decidir se ele se torna arquitetural.
Isso marca uma fronteira de refatoração importante: semântica de instrução precisa ganhar forma non-committing, ou o backend deve trabalhar sobre shadow state.
Rename checkpoints para recovery
Quando branch é previsto, instruções mais novas continuam fazendo rename.
Se houver misprediction, o RAT precisa retornar ao estado logo após o branch, antes das definições do caminho errado.
Estratégias:
- checkpoint completo do RAT por branch;
- history buffer com mudanças de mappings para undo;
- rebuild a partir do committed map + ROB sobrevivente.
Para simulador didático, checkpoint completo é simples de verificar.
Se A registradores arquiteturais são mapeados e IDs físicos exigem ceil(log2(P)) bits:
custo_checkpoint ~= A * ceil(log2(P))
sem incluir metadata.
x86 adiciona complexidade com flags, registradores parciais, vetoriais e estado especial.
Committed map e speculative map
É útil separar:
- speculative RAT — mapping mais novo usado por instruções entrando;
- committed map — mappings que representam retirement arquitetural.
Quando uma instrução de destino faz retirement, o committed map passa a apontar para o novo physical register.
Após exception/interrupt flush, speculative RAT pode ser restaurado a partir do committed map.
Invariante:
O committed map sempre referencia valores físicos correspondentes ao estado arquitetural retirado.
Operações de memória e Load/Store Queue
Registradores são fáceis de renomear porque cada definição recebe novo armazenamento. Memória pode alias dinamicamente.
Uma máquina OoO usa uma Load/Store Queue (LSQ) para rastrear operações em ordem.
Store entry pode conter:
- idade;
- address known;
- data known;
- size;
- fault state;
- commit permission.
Load entry:
- idade;
- address;
- size;
- result;
- dependency/replay state.
Um load mais novo só pode avançar antes de stores mais antigos se a política de ordenação permitir e o risco de alias estiver controlado.
Store-to-load forwarding
Se um store mais antigo em voo escreve os mesmos bytes que um load mais novo deseja, o load pode obter os dados da store queue.
Conceitualmente:
percorrer stores mais antigos do mais novo para o mais velho:
    se houver overlap de endereco:
        se bytes requeridos estiverem prontos:
            encaminhar dados
        senao:
            load aguarda
O store anterior mais novo vence porque é a última definição em ordem de programa daquele endereço.
Overlap parcial exige masks e composição de bytes.
Memory disambiguation
Um load mais novo pode ter address ready enquanto alguns stores anteriores ainda têm address unknown.
Políticas:
- conservadora: aguardar todos os addresses anteriores;
- especulativa: executar e depois verificar conflitos quando stores resolvem.
A segunda aumenta memory-level parallelism, mas exige replay/recovery em violations.
Um primeiro backend OoO do ChrisCPU deve preferir política conservadora até register scheduling e retirement estarem provados.
Stores fazem commit de forma diferente de resultados em registradores
Um resultado especulativo em physical register é interno. Um store em RAM, MMIO ou port I/O pode ser irreversível externamente.
Por isso stores normalmente aguardam retirement antes da visibilidade global, mesmo que address e data tenham sido calculados antes.
No ChrisVM isso é especialmente importante porque MMIO callbacks alteram device state. Um write de caminho errado não deve precisar ser "desfeito".
O backend deve bufferizar efeitos de store/I/O e liberá-los apenas no commit definido.
Branches dentro do ROB
Um branch pode executar e resolver prediction cedo.
Se correto: - marcar branch completed; - manter trabalho mais novo.
Se incorreto: - redirecionar fetch; - invalidar ROB/IQ/LSQ mais novos; - liberar physical registers dessas instruções; - restaurar rename checkpoint; - restaurar speculative predictor history; - preservar branch e operações anteriores.
O branch ainda faz retirement em ordem posteriormente.
Recovery não pode liberar physical registers de instruções sobreviventes.
Backpressure de recursos
Estruturas OoO finitas podem bloquear rename/dispatch:
- ROB full;
- issue queue full;
- sem physical register;
- load queue full;
- store queue full;
- checkpoints esgotados.
Isso é backpressure.
Um front end largo só mantém throughput se execução e retirement liberarem recursos suficientemente rápido.
Um simulador deve contar stalls por motivo em vez de agregar tudo em um único contador.
Retirement
Retirement verifica a entrada mais antiga do ROB, ou um número limitado de entradas consecutivas.
Uma entrada pode fazer retirement quando:
- valid;
- completed;
- não existe exception anterior não resolvida;
- seus side effects podem ser comprometidos com segurança.
Para instrução que escreve registrador:
- atualizar committed mapping;
- liberar physical register anterior se seguro;
- contabilizar retired instruction;
- remover ROB entry.
Para store:
- liberar o efeito comprometido de memória/device;
- tratar fault arquitetural conforme modelo;
- retirar entry.
Para branch:
- comprometer history arquitetural, se houver;
- treinar predictor conforme política;
- retirar entry.
Se retirement width = R, no máximo R instruções podem se tornar arquiteturalmente comprometidas por ciclo.
Retirement em ordem e operações serializantes
Algumas operações requerem ordering mais forte.
Exemplos possíveis:
- mudança de privileged state;
- transição de interrupt enable;
- troca de page-table root;
- I/O;
- instruções definidas como serializing pela arquitetura modelada.
Um backend inicial pode tratar conservadoramente essas instruções exigindo que o ROB drene antes de execução/retirement. Isso sacrifica desempenho, mas simplifica correção.
A semântica x86 real deve ser obtida de especificações arquiteturais, não inferida do nome da instrução.
Renaming de flags
Condition flags criam dependências semelhantes a GPRs.
Possibilidades:
- tratar RFLAGS inteiro como um recurso renomeável;
- renomear grupos de flags;
- rastrear producer por flag;
- serializar conservadoramente operações de flags.
Tratar RFLAGS como único recurso é simples, porém cria dependências falsas.
Modelo mais preciso:
flags_read_mask
flags_write_mask
flags_preserve_mask
Assim, scheduling pode distinguir subconjuntos independentes.
Registradores parciais
AL, AH, AX, EAX e RAX se sobrepõem. EAX também zero-extends para RAX.
Criar mapping separado por nome textual é incorreto.
Primeira implementação segura:
- normalizar tudo para register family;
- tratar qualquer acesso à família como dependência conservadora.
Implementação mais avançada:
- masks de bytes/bits;
- merge semantics;
- upper-bit definition.
O semantic layer precisa informar ao rename o que é lido, escrito, preservado e zerado.
Micro-ops
Instruções x86 complexas nem sempre cabem em uma única scheduler entry.
Um timing model pode traduzir uma instrução arquitetural em várias micro-ops.
O ROB ainda precisa manter a fronteira arquitetural para:
- exception reporting;
- RIP;
- retirement count;
- atomicity;
- rollback.
A instrução só pode retirar quando suas micro-ops necessárias tiverem completado.
Para um ChrisCPU inicial, manter uma operação interna por ChrisInsn suportada é mais simples. Decomposição deve ser adicionada quando um modelo de recurso realmente exigir.
Common Data Bus como abstração didática
Descrições clássicas do algoritmo de Tomasulo usam um Common Data Bus (CDB).
Conceitualmente:
producer completa P37 = value
broadcast tag P37
consumidores aguardando P37 tornam source ready
Um simulador não precisa copiar valor para toda issue entry. Pode marcar P37 como ready no physical register file e deixar consumidores lerem quando selecionados.
Isso separa dataflow conceitual da topologia física.
Tomasulo e renaming moderno
Tomasulo combina scheduling dinâmico e renaming por reservation stations/tags. CPUs modernas frequentemente usam explicit physical registers, ROB e issue queues.
Objetivos compartilhados:
- aguardar apenas dependências verdadeiras;
- remover falsas dependências;
- executar quando operands ficam ready;
- preservar estado arquitetural preciso.
A documentação deve distinguir o algoritmo histórico da implementação escolhida futuramente no ChrisCPU.
Visão de dataflow
Após rename, a instruction window se aproxima de um grafo dinâmico de dependências.
Cada operação = nó. RAW = aresta do producer physical register para consumidores.
Uma operação está pronta quando:
todas as fontes estao ready
AND unidade requerida esta disponivel
AND restricoes de memoria/ordering permitem issue
OoO scheduling é, portanto, uma travessia dinâmica restrita de um grafo limitado pela janela.
O hardware não precisa construir um objeto graph explícito; essa é uma representação útil para raciocínio.
Head-of-line blocking no retirement
OoO pode completar muitas instruções posteriores enquanto a mais antiga aguarda.
Exemplo:
I1: long cache-miss load
I2..I40: ALU independentes
I2..I40 podem completar, ocupar physical registers e ROB, mas não passar I1 no retirement.
Eventualmente a janela enche e rename para.
Uma grande instruction window esconde latência apenas até sua capacidade finita.
Tamanho da janela e latency hiding
Com N operações em voo, a máquina só encontra trabalho independente dentro desse horizonte.
Aumentar N pode melhorar ILP e memory-level parallelism, mas aumenta:
- armazenamento;
- custo wakeup/select;
- checkpoints;
- energia;
- custo do simulador.
Não existe ROB size universalmente ótimo.
Para experimentação, parametrizar é melhor que fixar um número que pareça representar hardware real.
Interrupções e retirement boundary
Interrupts externos precisam de estado arquitetural preciso.
Um modelo simples pode registrar o pedido assíncrono e entregá-lo quando:
- uma fronteira arquitetural permitida for alcançada;
- instruções anteriores tiverem feito retirement;
- instruções especulativas mais novas forem limpas;
- committed state estiver disponível.
Assim como exceções, interrupções operam sobre estado comprometido.
TLB e side effects de tradução
Loads/stores podem disparar address translation e faults. Um modelo mais detalhado poderia simular TLB fills e page walks especulativos.
Na primeira versão OoO, tradução pode continuar funcional/síncrona dentro da operação de memória, mas faults devem ficar registrados no ROB.
Se timing de TLB for adicionado, será necessário definir quais efeitos microarquiteturais sobrevivem a flush. Page fault do caminho errado continua não podendo ser entregue.
Operações atomic/locked
Operações atomic/locked restringem scheduling de memória.
Política inicial conservadora:
- esperar chegar ao ROB head;
- drenar efeitos anteriores conflitantes;
- executar non-speculatively;
- bloquear memória posterior até conclusão.
Isso é mais lento que hardware real, mas é apropriado para um primeiro modelo correto.
Depois que memory ordering e coherence forem explicitamente modelados, o comportamento pode ser refinado.
Modelo atual de execução do ChrisCPU
cpu_run atual é sequencial:
fetch bytes
decode em ChrisInsn
execute contra ChrisArchitectureState
update/redirect RIP
reconhecer IRQ
incrementar step/TSC
repetir
chris_execute chama helpers que leem e escrevem registradores e memória arquiteturais diretamente. ChrisCpu possui um único ChrisArchitectureState e nenhum estado físico especulativo.
Isso torna o interpretador funcional um bom oráculo, porém impede uma implementação OoO ingênua: mutation arquitetural imediata precisa ser isolada antes de scheduling especulativo.
Fronteira de refatoração para um backend OoO
O timing backend deve separar três camadas.
1. Decode/semantic description
Produzir descrição side-effect-free:
- sources;
- destinations;
- flag masks;
- memory intent;
- control-flow class;
- operation parameters;
- privilege/serialization properties.
2. Execute/evaluate
A partir de valores explícitos e interface de memória, produzir:
- results;
- flags;
- effective addresses;
- branch outcome;
- fault descriptors;
- proposed side effects.
Sem commit arquitetural.
3. Retirement/commit
No ROB head:
- publicar mappings/state;
- liberar stores/I/O bufferizados;
- entregar exceptions;
- atualizar committed control state;
- liberar recursos físicos antigos.
Essa decomposição permite que o interpretador funcional continue com commit imediato enquanto o timing backend reutiliza o semantic core com resultados adiados.
Estruturas mínimas propostas
Uma implementação didática pode começar com:
RobEntry rob[64]
IssueEntry iq[32]
PhysReg phys[96]
int rat[ARCH_REG_COUNT]
int committed_rat[ARCH_REG_COUNT]
FreeList free_regs
LoadQueue lq[24]
StoreQueue sq[24]
Os números são exemplos, não descrição do source atual nem de CPU real.
Sempre que possível, devem ser parâmetros.
Ordenação de fases por ciclo
Um simulador determinístico deve definir a ordem de fases para evitar ambiguidade de eventos no mesmo ciclo.
Possível sequência:
- retire;
- branch recovery/exception redirect;
- complete execution events;
- write results e wakeup;
- issue;
- dispatch/rename;
- decode/fetch;
- cycle accounting.
Se um result completado no passo 3 pode acordar e emitir consumidor no passo 5 do mesmo ciclo, isso é uma decisão temporal específica. Um modelo mais estrito pode adiar para o ciclo seguinte.
A documentação precisa definir isso para tornar traces reproduzíveis.
Accounting de recursos em recovery
Em branch squash, liberar recursos de instruções mais novas:
- ROB slots;
- issue entries;
- LSQ entries;
- physical registers;
- checkpoints;
- speculative predictor history.
Sequence numbers monotônicos ajudam a identificar "mais novo que branch".
Ao liberar cada physical register:
- garantir que pertence a destination squashed;
- garantir que não está no committed RAT;
- garantir que nenhuma instrução sobrevivente o referencia.
Assertions sobre esses pontos detectam bugs cedo.
Invariantes
Um backend futuro deve verificar continuamente:
- Todo speculative mapping aponta para physical register alocado.
- Todo committed mapping aponta para physical register alocado e ready.
- Physical register não pode estar free e referenced simultaneamente.
- Ordem de idade do ROB é inequívoca.
- Nenhuma instrução faz retirement antes de todas as mais antigas.
- Instrução com exception não compromete side effect normal.
- Flush remove exatamente as instruções mais novas corretas.
- Todo source tag da issue queue referencia producer válido ou committed value.
- Store só fica externo sob regra de commit.
- Mapping físico antigo é liberado exatamente uma vez.
- Branch recovery restaura rename state equivalente ao prefixo sobrevivente.
- Estado arquitetural retirado coincide com interpretador funcional.
Simuladores podem executar assertions mais agressivas que hardware, o que é vantajoso no ChrisCPU.
Validação diferencial
O ChrisCPU funcional deve permanecer backend de referência.
Após cada grupo de retirement OoO:
- avançar interpretador funcional pela mesma quantidade de instruções arquiteturais;
- comparar GPRs, RIP, RFLAGS e privileged state relevante;
- comparar memory effects arquiteturais;
- comparar fronteira de exception/interrupt.
Não se compara:
- cycle count;
- speculative trace;
- physical mappings;
- predictor state.
Esses são microarquiteturais.
Casos direcionados
Scheduling independente
long_load rax
add rcx, rdx
xor r8, r9
As ALUs independentes devem completar enquanto load aguarda.
RAW
add rax, rbx
sub rcx, rax
Consumer aguarda physical register do producer ficar ready.
WAW removido
mov rax, 1
mov rax, 2
Destinos físicos diferentes; RAX final = 2.
WAR removido
add rbx, rax
mov rax, 9
Primeira instrução usa mapping antigo; segunda recebe novo destino.
Fault preciso
older valid ops
faulting load
younger completed ops
Somente antigas fazem retirement; jovens são descartadas; fault usa RIP correto.
Branch recovery
Várias destinations renomeadas após branch errado. RAT e free list precisam ser restaurados exatamente.
Store suppression
Store/MMIO do caminho errado não pode alterar memória/device.
Pressão do ROB
Uma operação antiga não resolvida enche ROB. Rename deve parar sem corrupção.
Métricas de desempenho
Contadores úteis:
- cycles;
- decoded;
- renamed;
- issued;
- completed;
- retired;
- average/max ROB occupancy;
- issue queue occupancy;
- rename stalls por motivo;
- ROB-full stalls;
- free-register stalls;
- LQ/SQ stalls;
- branch flushes;
- replay count;
- execution-unit utilization.
IPC:
IPC = retired_instructions / cycles
Essas métricas descrevem a configuração do simulador, não uma CPU física específica.
Complexidade no simulador
Custos representativos:
- RAT lookup: O(1);
- readiness lookup: O(1);
- ROB allocate/retire circular: O(1);
- free-list stack: O(1);
- naive ready selection: O(Q);
- naive wakeup: O(Q*S);
- scan de older stores: O(SQ);
- branch squash por janela: O(N).
Índices mais sofisticados reduzem custo ao preço de complexidade.
Para backend educacional, invariantes claros são prioridade.
Limitações atuais
A revisão atual não contém:
- physical register file;
- rename map;
- rename free list;
- reorder buffer;
- issue queue/reservation stations;
- wakeup/select network;
- load/store queue;
- speculative retirement engine;
- rename checkpoints;
- OoO replay.
A execução atual modifica estado arquitetural diretamente.
Fronteira de roadmap
Ordem segura de implementação:
- refatorar decoded instructions para read/write semantic metadata;
- criar execution result side-effect-free;
- adicionar committed/speculative maps;
- adicionar physical register allocation;
- adicionar ROB inicialmente com execução ainda in-order;
- provar precise exceptions;
- adicionar issue queue e readiness;
- permitir ALU independente executar fora de ordem;
- integrar branch checkpoints;
- adicionar LSQ conservadora;
- adicionar store-to-load forwarding;
- somente então memory speculation/replay e issue mais largo.
A migração deve ser evolutiva e diferencialmente validada.
Registro de revisão
Este capítulo foi reconciliado com ChrisOS main na revisão e05a17fd76333114a3fb5c2452f38ca747d4ac56. Afirmações sobre comportamento atual se limitam aos arquivos declarados. ROB, physical registers, rename, scheduler e LSQ descritos são teoria e proposta de design futuro, não mecanismos já existentes no ChrisCPU.