
Caches e hierarquia de memória
Escopo e motivação física
Uma instrução identifica uma operação arquitetural; ela não determina quantos ciclos de relógio serão necessários para obter seus operandos. Registradores, matrizes SRAM, interconexões e DRAM possuem capacidades, custos de acesso e restrições de localização diferentes. Uma matriz grande exige decodificação de endereços, fios e circuitos de leitura distribuídos por uma área física maior. A DRAM também opera por bancos e linhas e precisa de renovação periódica. Aumentar a frequência do processador não transforma uma memória arbitrariamente grande em um banco de registradores acessível em um ciclo.
Uma cache retém um subconjunto de informações que podem ser obtidas em outro lugar. Sua utilidade depende da localidade: a localidade temporal reutiliza informações acessadas recentemente, enquanto a localidade espacial acessa endereços próximos. A cache explora esses padrões retendo blocos recentemente úteis e transferindo bytes adjacentes em conjunto. Uma linha de cache é essa unidade de transferência e controle; ela não é uma página, um objeto C ou uma palavra de máquina isolada.
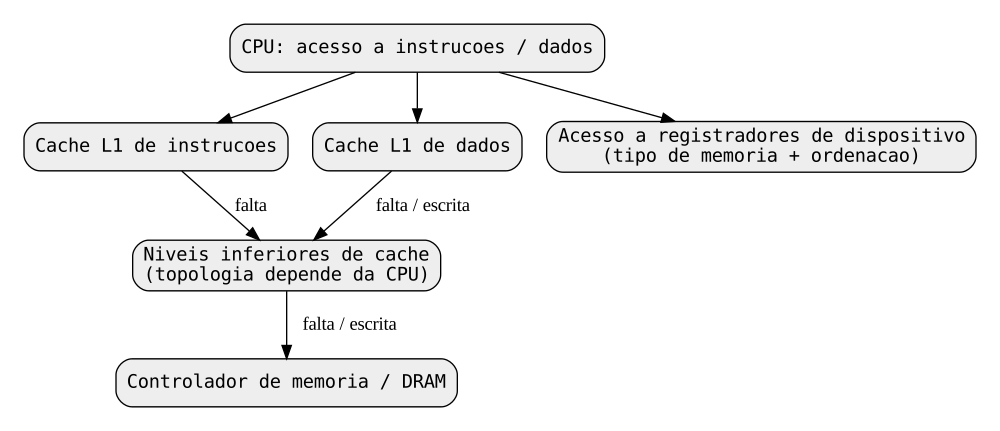
A organização abaixo representa uma hierarquia conceitual de hardware, não uma topologia identificada em determinado computador. Capacidades, domínios de compartilhamento, inclusão e latências precisam ser obtidos para o processador efetivamente utilizado. O interpretador ChrisCPU examinado neste capítulo não instancia essa hierarquia como modelo temporal.
| Estrutura | Informação retida | Causa típica de ausência | O que a ausência não implica |
|---|---|---|---|
| Cache de instruções/dados | Bytes agrupados em linhas | O bloco solicitado não está presente | Falha de memória virtual |
| TLB | Traduções de endereços e permissões | A tradução não está presente | Ausência dos dados em todas as caches |
| Cache de caminhada de páginas | Informações intermediárias de tradução | Falta um componente da caminhada | Acesso a disco |
| Cache de arquivos do SO | Conteúdo de arquivos ou blocos | O software não possui uma cópia utilizável | Que o único custo seja uma falta na cache da CPU |
Tradução e acesso aos dados interagem, mas continuam sendo mecanismos distintos. Uma falta na TLB pode iniciar uma caminhada por tabelas de páginas cujos bytes já estão em cache. Uma falta de página indica uma condição que exige tratamento arquitetural de exceção. Confundir esses eventos produz explicações incorretas tanto de desempenho quanto de correção.
Representação das linhas e decomposição do endereço
Considere uma cache ilustrativa com capacidade C bytes de dados, linhas de B bytes e A vias por conjunto. A quantidade de conjuntos é S = C/(B×A). Quando B e S são potências de dois, um modelo simples indexado fisicamente decompõe o endereço p em deslocamento, índice do conjunto e etiqueta:
O conjunto selecionado contém A linhas candidatas. Cada candidata precisa de um indicador de validade e de uma etiqueta; uma organização com escrita postergada também precisa de estado de modificação, e uma organização coerente precisa de estado de protocolo. A capacidade de dados não inclui esses metadados. Uma linha inválida nunca deve produzir um acerto apenas porque uma etiqueta antiga coincide com a procurada.
Em um exemplo de 32 KiB, oito vias e linhas de 64 bytes, S = 64. Seis bits do endereço selecionam o byte e seis selecionam o conjunto. O endereço 0x12340 possui bloco 1165, conjunto 13, etiqueta 18 e deslocamento zero. O endereço 0x13340 possui o mesmo conjunto e outra etiqueta. A separação é de 4096 bytes: S×B. Essa aritmética descreve o exemplo; não promete que toda cache real empregue esses bits de índice. Projetos reais podem utilizar funções de dispersão ou indexações diferentes entre níveis.
Um modelo em software pode procurar entre as A vias em O(A) operações. O hardware pode comparar etiquetas simultaneamente; a complexidade do software, portanto, não prevê a latência de acerto do hardware. Quando todos os conjuntos possuem a mesma quantidade de linhas, o armazenamento bruto é S×A×B mais os metadados. Para uma capacidade total fixa, mais vias reduzem certos conflitos, mas exigem mais comparações de etiquetas e uma seleção mais complexa.
Acerto, preenchimento, substituição e propriedade
Um modelo didático bloqueante pode processar uma leitura da seguinte forma:
separar o endereço em etiqueta, conjunto e deslocamento
procurar nas vias válidas do conjunto
se existir uma etiqueta correspondente:
    atualizar os metadados de substituição
    devolver os bytes solicitados
escolher uma via inválida ou, na ausência dela, uma vítima
se a vítima estiver modificada:
    escrever seu bloco antigo no nível inferior
buscar o bloco solicitado no nível inferior
instalar dados e etiqueta; marcar como válido e não modificado
atualizar os metadados de substituição
devolver os bytes solicitados
A invariante central é que cada entrada válida identifica o bloco representado por seus dados. A instalação não pode expor uma etiqueta nova com bytes antigos. Uma vítima modificada não pode ser sobrescrita antes que sua informação atualizada seja preservada. Um acesso que cruza a fronteira entre linhas pode exigir duas consultas e dois preenchimentos. Ele não é automaticamente atômico porque o programa utiliza uma única expressão.
Caches reais não bloqueantes acompanham faltas pendentes, agrupam solicitações ao mesmo bloco e permitem que trabalho independente prossiga enquanto um preenchimento está em andamento. Esses mecanismos exigem recursos finitos de acompanhamento. Sua saturação pode impedir novos acessos mesmo quando existem unidades de execução disponíveis. Um simulador que atualiza os dados imediatamente a cada falta não reproduz esse enfileiramento sem modelos explícitos de tempo e de recursos.
A política de substituição determina qual bloco residente perde seu lugar. A substituição pelo menos recentemente utilizado mantém uma ordenação de recência; uma ordenação exata de A vias possui A! permutações e exige pelo menos ceil(log2(A!)) bits para codificação. Implementações frequentemente adotam políticas aproximadas. FIFO, seleção aleatória e pseudo-LRU baseada em árvore têm comportamentos diferentes; atribuir qualquer uma delas ao hardware exige evidência específica para o processador.
Classificação das faltas e associatividade
Uma falta compulsória ocorre no primeiro acesso a um bloco durante a execução modelada. Uma falta de capacidade ocorre porque o conjunto de trabalho ultrapassa a capacidade disponível, inclusive em uma cache de comparação totalmente associativa. Uma falta de conflito decorre das restrições de posicionamento: blocos demais disputam um mesmo conjunto, embora exista capacidade em outros. Essa classificação depende da sequência de referências e do modelo de comparação, não apenas da observação de que um acesso demorou.
No exemplo anterior, nove blocos separados por 4096 bytes disputam oito vias de um conjunto. Sob LRU exato, ler repetidamente os nove blocos em ordem faz com que todos os acessos posteriores ao aquecimento falhem. Os dados ativos somam apenas 576 bytes, muito menos que 32 KiB. Aumentar a memória livre total não corrige esse padrão. Alterar posicionamento, passo entre endereços, associatividade ou ordem de percurso pode modificá-lo.
O percurso sequencial de elementos de 32 bits aproveita dezesseis elementos por linha de 64 bytes quando alinhado. Sem reutilização nem busca antecipada, isso produz aproximadamente um preenchimento a cada dezesseis elementos. Ler apenas um desses elementos de cada linha diferente utiliza quatro dos sessenta e quatro bytes transferidos: a eficiência de bytes úteis é de 6,25%. Essa eficiência descreve o aproveitamento da transferência, não o ganho total de desempenho possível na aplicação.
Latência, largura de banda e modelo numérico delimitado
O tempo médio de acesso à memória é útil quando suas hipóteses são explícitas. Considere t1 como custo da consulta à L1, m1 como sua probabilidade de falta, t2 como custo adicional da consulta à L2 depois de uma falta na L1, m2 como probabilidade condicional de falta na L2 e tm como custo adicional da memória depois de uma falta na L2. Um modelo serial e bloqueante fornece:
Com custos ilustrativos de 4, 12 e 180 ciclos e probabilidades de 0,05 e 0,20, o resultado é 6,4 ciclos. Reduzir m1 para 0,02 produz 4,96 ciclos. São exemplos calculados, não medições do ChrisOS. Inserir uma taxa incondicional de faltas da L2 nessa fórmula condicional contabiliza a filtragem duas vezes e produz um resultado incorreto.
| Probabilidade de falta na L1 | Probabilidade condicional de falta na L2 | Ciclos calculados por acesso |
|---|---|---|
| 0,00 | 0,20 | 4,00 |
| 0,02 | 0,20 | 4,96 |
| 0,05 | 0,20 | 6,40 |
| 0,10 | 0,20 | 8,80 |
| 0,20 | 0,20 | 13,60 |
Esse modelo não representa sobreposição de faltas, busca antecipada, escritas de linhas modificadas, tráfego de coerência ou escalonamento do controlador de memória. Uma cadeia de ponteiros possui endereços dependentes e expõe a latência: a próxima leitura só pode começar depois que o ponteiro anterior chega. Fluxos independentes podem sobrepor solicitações e terminar limitados pela largura de banda. Para um fluxo simplificado com largura de banda efetiva W bytes/s e latência L segundos, aproximadamente W×L bytes precisam permanecer em trânsito para sustentar essa taxa. Dividir pelo tamanho da linha estima a quantidade necessária de transferências simultâneas, desde que outros recursos não sejam limitantes.
Escritas, tipos de memória e semântica dos dispositivos
A política write-through propaga a escrita ao próximo nível como parte da operação; buffers ainda podem adiar a conclusão física. Write-back retém os bytes modificados e marca a linha até uma transferência posterior. A alocação em escrita determina se uma falta de escrita primeiro obtém uma linha; é uma decisão independente. Uma escrita bem-sucedida da CPU não equivale à persistência em armazenamento nem à conclusão de um comando de dispositivo.
Nos mapeamentos x86, a interpretação do controle de cache envolve tipos arquiteturais de memória e suas regras de seleção. PWT e PCD não devem ser tratados como interruptores universais independentes de PAT, MTRRs e do nível da paginação. A especificação do processador deve ser consultada antes de modificá-los. Uma região de framebuffer e um registrador cuja leitura reconhece uma interrupção, em particular, possuem semânticas diferentes. Repetir, combinar ou executar especulativamente operações sobre registradores pode alterar o comportamento do dispositivo.
map_mmio_page no kernel examinado exige entrada física alinhada à página. Reserva uma página virtual da janela MMIO sob mm_enter/mm_leave, verifica o esgotamento dessa janela e chama map_4k com MM_PRESENT | MM_WRITE | MM_PWT | MM_PCD | MM_NX. Desalinhamento e esgotamento acionam panic. Isso demonstra os atributos solicitados por esse auxiliar; não comprova o tipo efetivo de memória em todas as plataformas nem que todos os mapeamentos de dispositivos utilizem essa função.
O auxiliar instala um mapeamento de supervisor porque não solicita MM_USER; NX solicita acesso não executável. A reserva na janela virtual e a instalação do mapeamento são etapas separadas. A correção de um driver também exige larguras de acesso adequadas, ordenação, propriedade do dispositivo e protocolo de conclusão. volatile isoladamente não fornece uma política de cache da CPU nem um protocolo completo de sincronização.
O que o ChrisCPU atual realmente modela
chris_translate percorre estruturas de paginação do convidado e verifica condições arquiteturais de acesso. A rotina inspecionada não implementa etiquetas de cache, substituição, penalidade temporal de falta na cache de dados ou temporização de PAT/MTRRs. chris_va_read traduz trechos do acesso e os encaminha a chris_phys_read. O tamanho do trecho é limitado por uma fronteira de 4 KiB. Essa divisão é uma fronteira de tradução/acesso, não um tamanho de linha de cache modelado.
Em chris_phys_read e chris_phys_write, um acesso inteiramente contido na RAM utiliza memcpy do hospedeiro. Um acesso inteiramente contido no framebuffer utiliza seu vetor de suporte; escritas também marcam o framebuffer como alterado. Os demais acessos físicos são resolvidos pela tabela MMIO e suas funções de retorno, byte a byte. chris_mmio_find percorre a tabela limitada, de modo que esse caminho custa O(n×M) no pior caso para n bytes e M posições de mapeamento. A cópia de RAM exige O(n) bytes de trabalho no hospedeiro. Nenhuma dessas expressões representa ciclos do convidado.
A falha de uma função MMIO ou um byte sem mapeamento devolve erro. Uma operação de vários bytes pode já ter executado chamadas anteriores antes de falhar em um byte posterior. Portanto, esse caminho não é uma transação com reversão. As verificações de limites da RAM e do framebuffer empregam subtração depois da verificação da base. Esses detalhes explicam despacho funcional e falhas; não demonstram fidelidade aos requisitos de largura de acesso de todo dispositivo físico.
O processador hospedeiro naturalmente armazena em suas caches os vetores, as instruções e os metadados do emulador. Essas caches afetam o tempo decorrido, mas não são caches do convidado expostas pelo modelo. Uma execução mais rápida pode refletir escolhas do compilador ou localidade no hospedeiro sem alterar qualquer instrução simulada. Inversamente, adicionar um simulador de cache pode tornar a execução do hospedeiro mais lenta enquanto representa uma máquina convidada hipotética mais rápida.
Limites de correção, segurança e otimização
Coerência de cache de dados, ordenação de memória e invalidação da TLB resolvem problemas distintos. Coerência restringe as cópias de uma posição de memória. Ordenação restringe observações entre operações. Um disparo de invalidação da TLB remove traduções obsoletas. Nenhum substitui os demais. Reciclar um quadro físico enquanto outra CPU ainda possui sua tradução antiga é um erro de propriedade que uma cache de dados coerente não consegue corrigir.
O estado da cache também pode transportar informações temporais entre domínios de proteção. Permissões de páginas impedem leituras arquiteturais, mas não estabelecem, isoladamente, isolamento temporal completo. Este capítulo não certifica uma estratégia de mitigação do ChrisOS. Essa afirmação exigiria um modelo de ameaça, identificação dos domínios de compartilhamento e testes para o processador e ambiente relevantes.
Mudanças úteis de organização incluem vetores contíguos, separação entre campos frequentemente acessados e campos pouco utilizados, divisão de percursos matriciais em blocos para reter sub-regiões úteis e eliminação de cópias desnecessárias de quadros completos. Preencher cada objeto até uma linha de cache pode aumentar o consumo de memória e a pressão sobre a TLB. Otimizar uma organização exige medir o padrão dominante e contabilizar esses custos, em vez de considerar alinhamento universalmente benéfico.
Validação e limites da revisão
A conciliação com o código deste capítulo está vinculada a da3df29cb397932c43d32373871fb9380e688ade. A decomposição de endereços, a sequência de conflitos e os exemplos de AMAT são reproduzíveis com python scripts/check_cache_examples.py. O script verifica um modelo deliberadamente simplificado; não executa o kernel nem estabelece tempos de cache em hardware nativo.
Uma investigação de desempenho em hardware deve registrar identificação da CPU, topologia das caches, opções do compilador, carga de trabalho, tamanhos dos conjuntos de trabalho, política de aquecimento e medições repetidas. Execuções frias e aquecidas, assim como acessos dependentes e independentes, devem ser separados. Contadores exigem definições específicas do modelo; uma expressão genérica como “falta de cache” não identifica suficientemente o evento contado. O tempo de execução do emulador deve ser apresentado separadamente de quaisquer ciclos explicitamente modelados para o convidado.
Uma evolução da implementação precisaria declarar modelo temporal, estados de linhas e filas, tratamento de tipos de memória e regras de coerência antes de atribuir simulação de caches ao ChrisCPU. São requisitos futuros, não funcionalidades inferidas do acesso físico existente. Os capítulos seguintes desenvolvem coerência e ordenação atômica separadamente deste modelo de capacidade e localidade.
Referência primária
- Intel 64 and IA-32 Software Developer's Manuals, seções de programação de sistema sobre controle de cache, atributos de paginação e memória multiprocessada. O manual arquitetural governa os tipos de memória; os exemplos numéricos e a cache didática acima são modelos ilustrativos explicitamente independentes.