
Operações atômicas e modelo de memória
Escopo: correção depois da coerência
A coerência de cache explica como vários agentes mantêm compatíveis as cópias de um mesmo bloco coerente de memória. Ela não define, isoladamente, todas as ordens em que as operações de memória de um programa podem se tornar observáveis.
Este capítulo trata da camada seguinte: atomicidade e ordenação de memória. O alvo arquitetural principal é x86-64 utilizando memória comum cacheável do tipo write-back, porque esse é o ambiente em que o código de sincronização nativo atual do ChrisOS é executado. Memória de dispositivo, regiões write-combining, instruções de memória persistente e acessos non-temporal possuem regras adicionais e não devem ser inferidos a partir dos exemplos de write-back.
Um modelo de memória restringe quais execuções um processador pode expor. Ele é deliberadamente mais fraco que a regra ingênua de que "cada núcleo realiza toda leitura e toda escrita globalmente na ordem do código-fonte". Processadores modernos sobrepõem trabalho, mantêm stores pendentes, especulam, encaminham dados e executam internamente fora de ordem. A arquitetura correta permite essas otimizações, mas limita os resultados externamente observáveis.
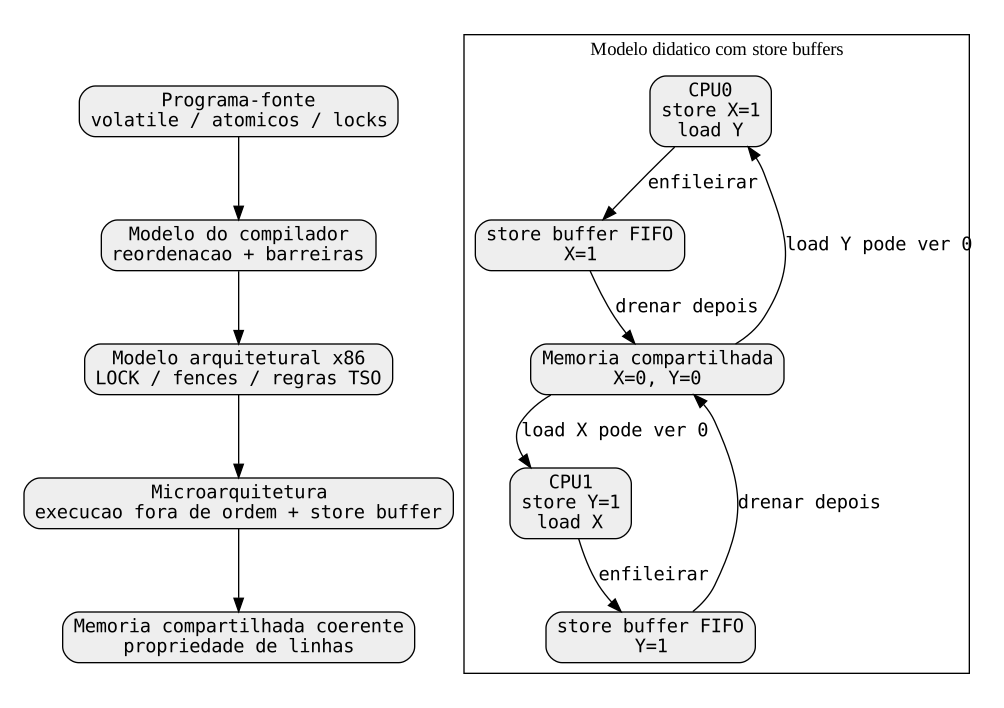
Há pelo menos quatro contratos em um programa de sistemas:
| Camada | O que ela restringe | Exemplo no ChrisOS |
|---|---|---|
| Modelo da linguagem/compilador | transformações permitidas ao compilador | volatile, builtins GCC __sync, builtins GCC __atomic |
| Modelo de memória da ISA | observações permitidas no nível de máquina | ordenação x86, LOCK, MFENCE |
| Coerência | propriedade e valores de linhas individuais | palavra de um lock compartilhado |
| Protocolo de software | estados legais da aplicação/kernel | spinlock, publicação de evento, propriedade de fila |
Um lock correto depende das quatro camadas. Corrigir apenas uma delas não é suficiente.
Ordem do programa não é necessariamente ordem de visibilidade
Considere um processador:
Na ordem do programa, a store aparece primeiro. Uma implementação x86 típica pode colocar a store em um store buffer enquanto a leitura de outro endereço prossegue. Outra CPU pode, portanto, observar uma execução que parece ter feito a leitura posterior antes de a store anterior se tornar globalmente visível.
Isso não significa que x86 reordena tudo livremente. Para memória write-back comum, o modelo é relativamente forte. A documentação arquitetural restringe, entre outras relações, load com load, store com store, causalidade e operações locked. A principal flexibilização exposta pelo modelo didático de Total Store Order é que um load pode ultrapassar uma store anterior ainda pendente quando os endereços são diferentes.
Um store buffer permite:
- que uma store se aposente sem aguardar toda a aquisição de propriedade e conclusão nos níveis inferiores;
- que trabalho independente posterior continue;
- que um load do mesmo endereço obtenha o valor mais novo da própria CPU por store-to-load forwarding;
- que as stores sejam drenadas depois para a memória coerente, preservando a ordem exigida.
TSO é uma abstração arquitetural. Ela não obriga um processador físico a possuir literalmente uma única FIFO idêntica ao modelo didático deste capítulo.
Litmus test Store Buffering
O teste clássico com duas CPUs inicia com X = 0 e Y = 0.
Em uma máquina estritamente sequentially consistent, o resultado r0 = 0 e r1 = 0 é impossível. Alguma das stores teria de entrar na ordem global antes do load oposto.
Sob um modelo TSO no estilo x86, as duas CPUs podem manter temporariamente as próprias stores em buffers privados:
Assim, o resultado 0/0 é permitido em memória comum. Isso não é uma falha de coerência: cada posição continua possuindo uma única história coerente de valores. É um efeito de ordenação entre operações sobre endereços diferentes.
O verificador reproduzível incluído neste capítulo explora todos os intercalamentos de uma pequena máquina TSO e confirma a existência do resultado 0/0 no teste Store Buffering.
Message Passing e a ordem FIFO das stores
Considere agora um produtor publicando dados e depois uma flag:
Para memória write-back comum no modelo x86-TSO simplificado, stores de uma mesma CPU tornam-se visíveis na ordem do programa. Se o consumidor observa READY = 1 e, em seguida, lê DATA, não deve obter o DATA antigo igual a 0 por uma suposta ultrapassagem da store posterior de READY sobre a store anterior de DATA.
Essa propriedade é uma razão pela qual uma publicação acquire/release simples frequentemente não exige uma instrução de fence adicional no hardware x86 para loads/stores comuns. O compilador ainda precisa preservar a semântica de sincronização da linguagem, e arquiteturas mais fracas podem exigir instruções explícitas.
O escopo importa: memória de dispositivo, tipos fracos de memória, stores non-temporal e instruções especiais podem obedecer regras diferentes.
Sequential consistency e TSO
Sequential consistency (SC) pode ser definida como uma execução em que todas as operações de memória parecem fazer parte de uma única ordem total que:
- contém todas as operações de todos os processadores; e
- preserva a ordem do programa de cada processador.
SC é simples de raciocinar, mas restringe fortemente a implementação.
Total Store Order (TSO) preserva grande parte dessa estrutura, porém permite que stores permaneçam temporariamente em buffers por CPU. Loads podem ultrapassar stores mais antigas de endereços diferentes, mas um load precisa observar a própria store pendente mais nova para o mesmo endereço. As stores são drenadas na ordem.
A tabela resume o modelo didático para memória comum WB:
| Par na mesma CPU | Intuição para x86/WB |
|---|---|
| Load → Load | preservado |
| Load → Store | preservado |
| Store → Store | preservado |
| Store → Load, endereço diferente | pode parecer reordenado enquanto a store permanece no buffer |
| Store → Load, mesmo endereço | forwarding preserva o próprio valor mais novo |
Os manuais arquiteturais são a autoridade quando uma instrução ou tipo de memória possui semântica especial.
Atomicidade não é a mesma coisa que ordenação
Uma operação é atômica quando observadores não podem enxergar um estado intermediário proibido daquela operação. Ordenação especifica relações entre aquela operação e outras operações.
Um load ordinário naturalmente alinhado pode ser atômico em sua largura sem funcionar como uma barreira completa de memória. Inversamente, uma fence pode ordenar operações sem alterar nenhum valor.
A diferença aparece em read-modify-write:
Essas três operações não formam um incremento atômico. Duas CPUs podem ler o mesmo valor antigo e uma atualização pode sobrescrever a outra.
Um RMW atômico cria uma única modificação indivisível em relação a operações concorrentes:
A implementação obtém a permissão exclusiva de coerência necessária e consolida uma única alteração.
Largura, alinhamento, cacheabilidade e instrução utilizada importam. O software deve depender das garantias arquiteturais da operação específica, não da suposição de que todo acesso que cabe em uma palavra de máquina seja automaticamente atômico. Acessos divididos e memória de dispositivo exigem cuidado especial.
Operações com prefixo LOCK
Em x86, instruções elegíveis com prefixo LOCK realizam um read-modify-write atômico sobre um destino em memória e possuem semântica forte de ordenação. A Intel documenta uma ordem total entre instruções locked e impede que loads/stores ordinários sejam reordenados através de operações locked.
Em memória cacheável moderna, a implementação normalmente adquire propriedade exclusiva da linha relevante em vez de travar eletricamente um barramento externo global para toda operação. O contrato arquitetural é de atomicidade e ordenação; o mecanismo interno depende da microarquitetura.
O toolchain self-hosted do ChrisOS atualmente emite formas como:
ChrisAsm reconhece as formas equivalentes de 32 e 64 bits. O KCC utiliza essas instruções para seus builtins __sync de compare-and-swap e fetch-and-add suportados.
Uma operação locked pode ser muito mais cara sob contenção porque a propriedade da linha precisa circular entre processadores. Atômico não significa barato.
XCHG com operando de memória
x86 fornece atomicidade a XCHG com operando de memória mesmo sem prefixo LOCK explícito. Essa exceção arquitetural é importante para um emulador.
A implementação atual do ChrisCPU em do_xchg é funcionalmente uma sequência:
Com apenas um vCPU convidado, nenhuma outra CPU guest consegue intercalar operações no meio dessa sequência. Quando o ChrisCPU ganhar SMP, porém, XCHG sobre memória precisará se tornar uma transação atômica do ponto de vista do guest.
O mesmo raciocínio vale para operações aritméticas com LOCK. O interpretador atual aceita LOCK em formas de memória depois que lock_ok rejeita uso sobre registrador, mas em seguida percorre o mesmo caminho comum de ler, calcular e escrever. Isso só é suficiente porque a execução direta do ChrisCPU ainda possui um único vCPU. Não é uma implementação SMP de LOCK.
Compare-and-swap
Compare-and-swap (CAS) escreve condicionalmente um novo valor se o conteúdo antigo coincidir com o esperado.
CAS atômico(p, expected, desired):
    old = *p
    se old == expected:
        *p = desired
        sucesso
    caso contrário:
        falha
Seu poder vem de tornar comparação e escrita indivisíveis. Spinlocks, pilhas lock-free e transições de estado podem ser construídos sobre essa primitiva.
CAS não resolve sozinho todos os problemas de concorrência. Um algoritmo ainda precisa definir:
- qual estado é protegido;
- a ordenação de memória em sucesso e falha;
- propriedades de progresso sob contenção;
- tempo de vida dos objetos referenciados;
- o problema ABA quando o valor passa A → B → A e a identidade intermediária importa.
Um loop de CAS pode ser atomicamente correto e ainda escalar mal quando muitas CPUs disputam continuamente a propriedade exclusiva da mesma linha.
Fetch-and-add
Fetch-and-add incrementa atomicamente uma posição e retorna seu valor anterior.
Essa primitiva é útil para tickets, contadores e referências.
No ChrisOS, atomic_add_u32 encapsula __sync_fetch_and_add. O subsistema de jobs utiliza essa função para g_inflight, g_completed e o acumulador do self-test SMP. A inicialização dos APs também utiliza __sync_fetch_and_add para incrementar cpu_online_count.
Essas operações impedem perda de atualizações no contador. Elas não transformam automaticamente os campos vizinhos em uma transação atômica. A publicação de dados adicionais ainda depende do lock ou protocolo de ordenação correspondente.
Barreiras de compilador e fences da CPU
O compilador e o processador são dois possíveis agentes de reordenação.
Uma barreira de compilador restringe transformações do compilador e pode não emitir nenhuma instrução de máquina. Uma forma comum no GCC é:
O clobber memory informa ao compilador que memória arbitrária pode ser afetada e restringe a movimentação de acessos através daquele ponto. A CPU não recebe uma fence.
Uma fence da CPU restringe a execução/visibilidade arquitetural. Em x86 existem LFENCE, SFENCE e MFENCE.
Uma fence de hardware sem semântica adequada no compilador ainda pode ser insuficiente se o compilador mover operações ao redor dela. Uma barreira apenas de compilador, por outro lado, não impõe uma ordem de hardware que a ISA não garanta. APIs corretas de sincronização precisam tratar os dois níveis quando necessário.
LFENCE, SFENCE e MFENCE
No nível de ordenação arquitetural:
- LFENCE ordena loads anteriores relevantes antes de loads posteriores relevantes; processadores modernos também documentam propriedades adicionais de serialização de despacho em contextos específicos.
- SFENCE ordena stores nos casos em que suas regras são necessárias, especialmente em acessos fracamente ordenados e non-temporal.
- MFENCE ordena loads e stores anteriores antes de loads e stores posteriores.
Essas instruções não devem ser adicionadas por intuição. Memória write-back x86 ordinária já fornece ordenação forte, e operações locked já possuem propriedades fortes. Fences redundantes podem aumentar custo sem melhorar correção.
MFENCE aparece atualmente como não implementada pelo ChrisCPU. PAUSE também não possui semântica dedicada no guest: F3 é tratado como REP e, fora do STOS suportado, F3 90 termina efetivamente com comportamento de NOP no interpretador atual. Isso é uma lacuna de fidelidade para spin loops nativos.
PAUSE é uma dica de espera, não uma fence
PAUSE informa ao hardware x86 que o processador está em um spin-wait. Ela pode reduzir penalidades ao sair de loops apertados e melhorar o compartilhamento de recursos em implementações com SMT.
Ela não adquire lock, não torna um load comum atômico, não publica dados e não substitui uma fence.
O spin_lock do ChrisOS executa PAUSE após uma tentativa de CAS falhar:
Isso reduz a agressividade da espera, mas cada nova tentativa continua realizando um compare-and-swap locked. Sob forte contenção, algoritmos como test-and-test-and-set ou locks em fila podem reduzir tráfego de coerência fazendo a espera sobre estado somente de leitura antes de tentar nova aquisição. A utilidade de uma mudança desse tipo no ChrisOS depende de medições e requisitos de justiça; não é consequência automática do modelo de correção.
Acquire e release
Ordenação acquire/release cria um contrato de publicação.
Uma operação release impede, segundo o modelo da linguagem, que operações anteriores atravessem indevidamente o ponto de publicação para depois dele.
Uma operação acquire impede que operações posteriores sejam movimentadas indevidamente para antes do ponto de observação.
Um handoff típico:
produtor:
    escrever payload
    release-store READY = 1

consumidor:
    r = acquire-load READY
    se r == 1:
        ler payload
Quando o acquire observa o release apropriado, as escritas anteriores do payload ficam ordenadas antes das leituras posteriores do consumidor.
Acquire e release são direcionais. Um release não ordena, em geral, operações posteriores para antes de si; um acquire não ordena automaticamente operações anteriores para depois.
relaxed, acquire, release, acq_rel e seq_cst
Os builtins GCC __atomic expõem ordens explícitas derivadas do modelo de memória de C/C++.
| Ordem | Finalidade |
|---|---|
| relaxed | atomicidade sem sincronização adicional além da ordem de modificação do objeto atômico |
| acquire | ponto de observação que ordena operações posteriores |
| release | ponto de publicação que ordena operações anteriores |
| acq_rel | as duas direções em um read-modify-write |
| seq_cst | acquire/release mais participação na ordem global sequentially-consistent da linguagem |
Atômicos sequentially consistent no código-fonte são mais fortes que simplesmente "esta instrução de máquina é atômica". O compilador precisa preservar as restrições globais do modelo da linguagem.
Em x86, acquire loads e release stores sobre memória cacheável comum frequentemente podem ser reduzidos a MOV ordinário, porque o hardware já oferece as direções necessárias de ordenação. Ainda assim, o compilador deve preservar a semântica de fonte.
Builtins GCC __sync
A família __sync é anterior às APIs modernas de ordem de memória. O GCC documenta a maioria das operações __sync como barreiras completas. As operações de lock possuem semântica direcional: __sync_lock_test_and_set é do tipo acquire e __sync_lock_release é do tipo release.
O spin.c atual utiliza:
O compilador usado no build nativo fornece a semântica dos builtins.
O KCC atual implementa apenas um subconjunto:
| Builtin no KCC | Lowering atual |
|---|---|
| __sync_bool_compare_and_swap em ponteiros 32/64 bits suportados | LOCK CMPXCHG |
| __sync_fetch_and_add em ponteiros 32/64 bits suportados | LOCK XADD |
| __sync_lock_release em ponteiros 32/64 bits suportados | store ordinária de zero |
| outros __sync_ / __atomic_ | fora do subconjunto suportado |
Isso é suficiente para gerar o spinlock básico existente, mas não constitui uma implementação geral do modelo atômico de C.
A fronteira de release no KCC
emit_sync_release do KCC gera uma store ordinária de zero no ponto da chamada. Em memória x86 write-back, uma store alinhada comum é suficiente no nível do hardware para um unlock de release quando as stores anteriores da região crítica já estão ordenadas antes dela.
Um compilador que implementa release também precisa impedir que seu próprio otimizador ou escalonador mova operações protegidas para depois do unlock.
O KCC atual é um emissor direto pequeno, não um compilador agressivamente otimizador, então a sequência gerada é estreita e previsível. Isso não deve ser transformado em uma garantia futura implícita. Caso o KCC ganhe otimizações mais fortes, sincronização precisa se tornar um efeito/barreira explícita na IR do compilador, em vez de depender da estratégia de emissão atual.
volatile não é um modelo atômico
volatile solicita ao compilador que preserve acessos observáveis de acordo com suas regras para volatile. É essencial para muitos registradores MMIO e útil para polling dependente da implementação, mas não fornece:
- read-modify-write atômico;
- exclusão mútua;
- sincronização acquire/release;
- ordem total entre threads;
- fence de hardware.
Os testes do KCC verificam corretamente uma propriedade mais estreita: loads e stores volatile permanecem na saída com a largura correta. Isso prova preservação de acessos volatile, não sincronização SMP.
A distinção é relevante porque o kernel atual contém variáveis volatile de polling, como cpu_online_count e g_ap_irq_enable. O comportamento atual em x86 depende de escolhas da implementação, acessos alinhados, coerência de hardware e operações atômicas ao redor. Essas variáveis não demonstram que volatile seja uma primitiva SMP.
Análise do código: cpu_online_count
cpu_online_count é declarado volatile uint32_t. A inicialização de cada AP o incrementa com __sync_fetch_and_add, enquanto a BSP realiza leituras volatile repetidas no loop de espera.
No nível de hardware do alvo x86 atual, isso cria um padrão prático de polling com escritores RMW atômicos e leituras naturalmente dimensionadas. No modelo formal da linguagem, porém, isso não é o mesmo desenho de declarar um objeto atômico e executar loads atômicos explícitos em todos os acessos.
A diferença importa para evolução do compilador e portabilidade. Um desenho mais explícito declararia qual ordenação é exigida para publicar a inicialização de um AP e empregaria uma única API atômica consistentemente.
Este capítulo registra a implementação atual; não atribui ao código uma garantia formal mais forte do que ele declara.
Análise do código: publicação de eventos do AC97
O driver AC97 utiliza builtins __atomic mais novos em vários pontos.
No handler de IRQ:
__atomic_fetch_add(&g_event_seq, 1, __ATOMIC_RELEASE)
...
waiter = __atomic_load_n(&g_ac97_waiter, __ATOMIC_ACQUIRE)
O waiter é publicado com:
e a sequência de eventos é consumida por acquire em ac97_take_event.
Esse vocabulário explicita acquire/release e documenta a intenção melhor do que volatile isolado.
Existe uma fronteira sutil: o incremento release de g_event_seq ocorre antes do trabalho posterior em ac97_fill. Release ordena o que vem antes da operação; não promete que escritas posteriores já estejam publicadas quando outra CPU observa a sequência. Portanto, o incremento da sequência não pode ser usado como prova de publicação de modificações realizadas depois dele. Se um consumidor futuro depender desses efeitos posteriores, o ponto de publicação deve ser movido ou o protocolo precisa de outra aresta de sincronização.
O KCC atual não implementa essas formas __atomic_*, o que também mostra que o self-hosting integral do kernel exige ampliar o subconjunto atômico do compilador.
Locks estabelecem um protocolo de happens-before
Considere um lock convencional:
Semântica correta de release no unlock e acquire na aquisição faz as escritas da primeira região crítica tornarem-se visíveis para a segunda região crítica depois que CPU1 adquire o mesmo lock.
A palavra do lock não é o estado protegido. É a aresta de ordenação criada pelo protocolo que permite comunicar dados ordinários não atômicos dentro da região crítica.
Utilizar um contador atômico não protege automaticamente uma estrutura comum vizinha. A sincronização deve fazer parte do protocolo de propriedade dessa estrutura.
Desabilitar interrupções não é sincronização SMP
irq_save desabilita interrupções mascaráveis apenas na CPU atual. Isso impede que um handler de interrupção naquela CPU reentre em uma região, o que é necessário para estruturas também usadas em contexto de IRQ.
Isso não interrompe outra CPU.
Código compartilhado por várias CPUs e por handlers pode precisar simultaneamente de:
- controle local de interrupções para evitar reentrada na mesma CPU; e
- lock ou protocolo atômico para exclusão entre CPUs.
Os caminhos de PMM e AC97 combinam essas preocupações. Tratar CLI como lock global seria incorreto.
Ordenação de memória e MMIO
Registradores de dispositivo não são RAM write-back comum. O tipo de memória e a semântica do barramento determinam quais acessos podem combinar, reordenar ou concluir de forma assíncrona.
Nem um atômico em C nem MFENCE devem ser tratados como uma instrução universal de "o dispositivo terminou". MMIO correto também pode exigir:
- tipo arquitetural de memória correto;
- largura e alinhamento exigidos pelo dispositivo;
- readback ou polling específico;
- regras de ordenação/conclusão do PCIe;
- propriedade de DMA e coerência de cache.
Os capítulos de dispositivos tratam essas questões separadamente. Os litmus tests TSO deste capítulo não devem ser aplicados diretamente a MMIO.
Vocabulário formal: po, rf e ordem de modificação
Um vocabulário intermediário útil:
- po (program order): ordem das operações de uma thread/CPU;
- rf (reads-from): qual escrita forneceu o valor retornado por uma leitura;
- modification order: ordem total por objeto atômico das escritas/RMWs no modelo da linguagem;
- synchronizes-with: aresta criada por operações como release observado pelo acquire correspondente;
- happens-before: ordem transitiva derivada de sequenciamento e sincronização.
Esses conceitos evitam frases ambíguas como "a escrita aconteceu primeiro". Primeiro na ordem do programa, na visibilidade global, na modification order e no relógio físico são afirmações diferentes.
Em protocolos do kernel, deve-se identificar a operação exata que publica, a operação que observa e quais dados dependem dessa aresta.
Modelo de memória atual do ChrisCPU
O ChrisCPU direto possui atualmente um único vCPU convidado. Seu loop executa uma instrução decodificada por vez. A memória do guest termina em acessos funcionais ao armazenamento hospedeiro.
Consequentemente:
- não existe store buffer do guest;
- não existe uma segunda CPU guest que possa observar reordenação;
- não existe diretório ou protocolo de coerência do guest;
- operações ALU de memória com LOCK não são transações atômicas entre vCPUs;
- XCHG em memória não é uma transação atômica SMP;
- CMPXCHG e XADD não estão implementados pelo ChrisCPU, apesar de ChrisAsm/KCC serem capazes de emiti-los;
- MFENCE não está implementada;
- PAUSE não possui semântica dedicada de spin-wait.
A documentação atual do ChrisCPU afirma que uma operação LOCK em memória é "atômica em relação ao guest". Isso é verdadeiro apenas no sentido trivial de um único vCPU: não existe um processador convidado concorrente. Não constitui validação do comportamento SMP x86.
Requisitos para um modelo SMP do ChrisCPU
Antes que o ChrisCPU possa iniciar e validar o caminho SMP nativo, o emulador precisa de um modelo explícito em vez de herdar acidentalmente propriedades do host.
1. Definir o escopo arquitetural
A primeira implementação pode escolher entre:
- sequential consistency;
- TSO no estilo x86 para memória WB comum;
- modelo mais completo com tipos de memória x86.
TSO funcional é muito mais simples que iniciar diretamente por temporização detalhada de cache.
2. Dar estado de stores pendentes a cada vCPU
Um TSO determinístico pode usar uma FIFO por vCPU.
store do vCPU:
    anexar endereço/valor/largura ao próprio buffer

load do vCPU:
    se houver store própria mais nova do mesmo endereço:
        fazer forwarding
    caso contrário:
        ler memória compartilhada

evento de drain:
    consolidar a store mais antiga na memória compartilhada
O escalonador deve permitir drenos suficientes para produzir os resultados arquiteturalmente permitidos sem inventar resultados proibidos.
3. Implementar transações locked
LOCK CMPXCHG, LOCK XADD e XCHG em memória precisam executar como transações indivisíveis do guest. Uma primeira versão simples pode utilizar um lock global da memória do guest e preservar a semântica arquitetural. Uma evolução posterior pode reduzir a granularidade.
4. Implementar fences
MFENCE precisa restringir o store buffer e loads conforme o modelo escolhido. LFENCE e SFENCE precisam de seu escopo documentado. PAUSE pode inicialmente ser neutra em tempo, mas deve ser decodificada como instrução distinta se houver pretensão de fidelidade.
5. Separar sincronização do guest e do host
Se vCPUs rodarem em threads hospedeiras, mutexes e atômicos do host protegem estruturas internas do emulador. Eles são ferramentas de implementação, não o modelo de memória convidado. O emulador não deve oferecer acidentalmente uma ordem mais forte ao guest apenas porque o host também é x86.
6. Criar litmus tests
No mínimo:
- Store Buffering: 0/0 permitido sob TSO;
- Store Buffering com MFENCE: 0/0 proibido;
- Message Passing: READY=1 com DATA anterior ainda 0 proibido no modelo WB simplificado;
- incremento atômico com valor final exato;
- exclusão mútua por CAS;
- ordem global de operações LOCK;
- XCHG de memória atômico;
- forwarding de store para load no mesmo endereço;
- interação com shootdown de TLB entre vCPUs.
O verificador desta documentação implementa os três primeiros no nível abstrato.
Modelo TSO reproduzível
scripts/check_memory_model_examples.py implementa um pequeno explorador de espaço de estados.
Cada processador possui:
- contador de programa;
- registradores locais usados pelos litmus tests;
- store buffer FIFO.
Em cada estado, o explorador pode executar a próxima instrução de uma CPU ou drenar a store mais antiga do buffer de uma CPU. Loads consultam primeiro a própria store pendente mais nova do mesmo endereço antes da memória compartilhada.
O verificador confirma três afirmações:
- Store Buffering produz 0/0 sem fences.
- Uma fence entre store e load em cada CPU elimina 0/0.
- Em Message Passing, observar READY=1 e depois DATA=0 é proibido pela ordem FIFO das stores mais preservação da ordem dos loads no modelo didático.
Isso não substitui validação contra Intel ou AMD. Torna o raciocínio do capítulo executável e auditável.
Checklist de revisão de concorrência
Ao revisar código concorrente do ChrisOS, identificar:
- qual objeto transporta a sincronização;
- se todos os escritores usam o mesmo protocolo;
- se os leitores utilizam operações correspondentes;
- qual ordenação é exigida: relaxed, acquire, release, full ou locked;
- se contexto de interrupção participa;
- se outra CPU pode acessar o objeto;
- se DMA ou dispositivo participa;
- hipóteses de largura e alinhamento;
- tempo de vida do objeto publicado;
- se o compilador conhece a sincronização;
- se o ChrisCPU consegue reproduzir o comportamento relevante;
- se existe litmus/stress test cobrindo a aresta pretendida.
Esse processo é mais confiável que adicionar volatile e fences até uma corrida aparentemente desaparecer.
Validação e limites da revisão
Este capítulo está conciliado com a revisão da branch main do ChrisOS da3df29cb397932c43d32373871fb9380e688ade.
Execute:
O script prova propriedades apenas de seu modelo didático finito. Ele não executa o kernel, não mede hardware nativo, não valida todo o modelo de memória Intel/AMD e não certifica o compilador.
Os testes existentes do KCC verificam separadamente que seus builtins __sync suportados emitem LOCK CMPXCHG, LOCK XADD e a store de zero usada em release. A documentação e o código do ChrisCPU estabelecem separadamente as limitações atuais de vCPU único e ausência de fences.
Alterações em spin.c, job.c, smp.c, ac97.c, lowering atômico do KCC, instruções locked no ChrisAsm ou execução SMP do ChrisCPU devem disparar revisão deste capítulo.
Referências primárias
- Intel 64 and IA-32 Architectures Software Developer's Manual, System Programming Guide, seções de ordenação de memória, operações locked e multiprocessamento.
- AMD64 Architecture Programmer's Manual, Volume 2: System Programming, seções Memory System, ordenação e fences.
- Documentação GCC dos builtins __sync.
- Documentação GCC dos builtins __atomic.