
Coerência de cache e memória multiprocessada
O problema de correção criado por cópias privadas
Em um uniprocessador, a cache pode ser tratada como uma estrutura privada de desempenho entre um mecanismo de execução e os níveis inferiores da memória. Um multiprocessador altera o problema. Se dois processadores puderem armazenar em cache o mesmo bloco de memória física, cada processador poderá possuir uma cópia privada enquanto o software espera uma única posição de memória compartilhada.
Considere o endereço físico X inicialmente com valor 0. A CPU 0 lê X e obtém uma cópia em cache. A CPU 1 também lê X. Em seguida, a CPU 0 escreve 1. Se a CPU 1 puder continuar lendo indefinidamente sua cópia privada antiga, a máquina deixa de se comportar como o sistema de memória compartilhada esperado por software SMP. A coerência de cache restringe essas cópias para que mudanças de propriedade e visibilidade permaneçam consistentes.
Coerência, portanto, não é apenas uma otimização de acertos em cache. É um mecanismo de correção sobre cópias de um mesmo bloco coerente. Uma implementação coerente precisa comunicar mudanças de propriedade de escrita, requisições de outros participantes, expulsões de linhas modificadas e situações em que uma cópia em outra cache é mais nova que a DRAM.
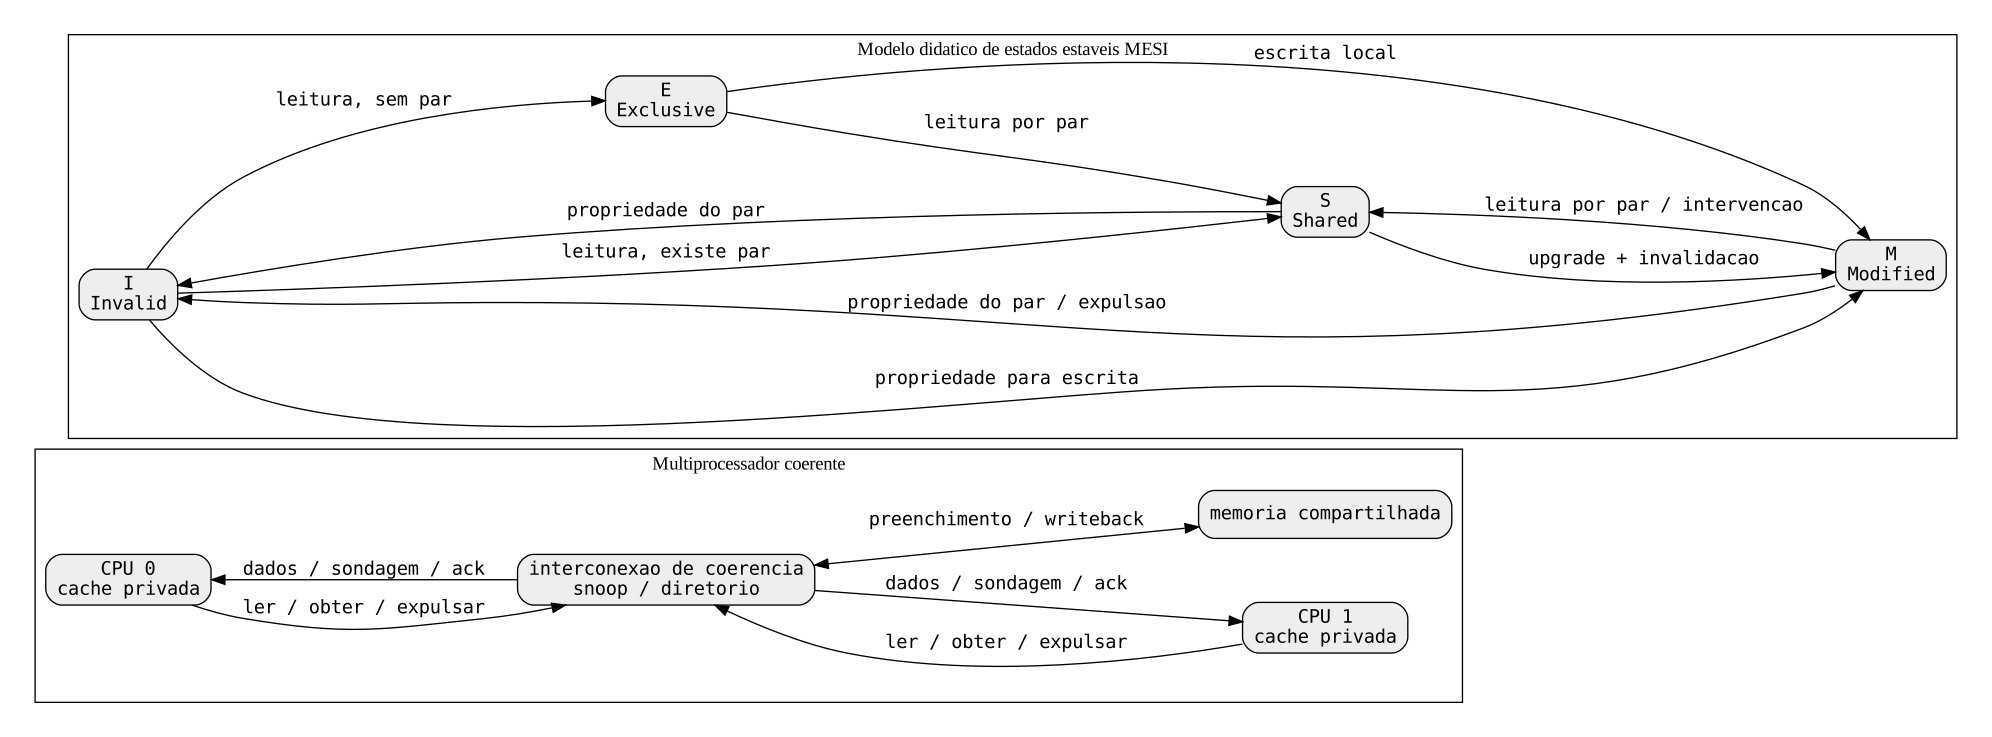
O diagrama é conceitual. Processadores reais podem empregar snooping, diretórios distribuídos, filtros de sondagem, interconexões hierárquicas, caches não inclusivas, estruturas de vítima e estados transitórios específicos da implementação. O software deve depender do modelo de memória arquitetural documentado, e não de uma topologia interna presumida.
Coerência, ordenação de memória e sincronização são camadas diferentes
Esses mecanismos resolvem problemas distintos.
| Camada | Pergunta respondida | Mecanismos típicos |
|---|---|---|
| Coerência de cache | O que acontece quando vários agentes coerentes possuem cópias de uma linha? | sondagens, invalidação, transferência de propriedade, estado de diretório |
| Consistência / ordenação de memória | Em que ordens leituras e escritas podem se tornar observáveis? | regras arquiteturais, fences, instruções locked |
| Sincronização em software | Qual execução pode entrar em uma região crítica ou publicar dados? | spinlocks, mutexes, atômicos, protocolos condicionais |
| Coerência de tradução | Como traduções de endereço obsoletas são removidas? | invalidação e shootdown da TLB |
Uma máquina coerente ainda pode tornar operações de memória observáveis em ordem diferente da ordem do código-fonte. Uma fence restringe ordenação, mas não substitui o mecanismo de propriedade das linhas. Um lock é um protocolo de software construído sobre atomicidade e ordenação. Um shootdown de TLB resolve outro problema de cache: uma tradução virtual antiga.
Essa distinção é essencial no ChrisOS porque o kernel SMP nativo utiliza memória comum coerente para locks e, ao mesmo tempo, implementa shootdown explícito da TLB para alterações de tabelas de páginas.
Invariante de um escritor e múltiplos leitores
Uma regra útil para protocolos de coerência baseados em invalidação é:
No máximo um participante coerente pode possuir permissão de escrita sobre uma linha de cache em determinado instante.
Vários processadores podem manter cópias legíveis. Antes de um deles modificar a linha, precisa alcançar um estado em que as cópias concorrentes não possuam direitos conflitantes.
A unidade de coerência normalmente é a linha de cache, não um campo em C. Se duas variáveis independentes compartilham uma linha, escrever em qualquer uma delas pode mover a propriedade da linha inteira. Esse é o fundamento do false sharing.
A ideia pode ser expressa como permissões:
| Permissão | Quantidade de possuidores | Pode ler? | Pode escrever sem nova transação de coerência? |
|---|---|---|---|
| Inválida | 0 cópias úteis | não | não |
| Leitura compartilhada | uma ou mais | sim | não |
| Exclusiva limpa | uma | sim | sim, após promoção local de estado |
| Exclusiva modificada | uma | sim | sim |
Os nomes variam entre protocolos, mas a exclusividade é mais importante que a nomenclatura.
MESI como protocolo didático
MESI fornece quatro estados estáveis úteis para explicar coerência por invalidação.
| Estado | Significado no modelo didático | Leitura local | Escrita local |
|---|---|---|---|
| Modified (M) | única cópia válida; diferente da memória inferior | acerto | acerto |
| Exclusive (E) | única cópia válida; limpa | acerto | promoção local para M |
| Shared (S) | cópia limpa; outras cópias podem existir | acerto | exige aquisição de propriedade |
| Invalid (I) | não há cópia utilizável | exige aquisição | exige aquisição de propriedade |
MESI não é uma descrição universal de toda implementação x86. A AMD documenta MOESI, que inclui o estado Owned. Processadores comerciais também utilizam estados internos e transitórios que não fazem parte da interface arquitetural para software. MESI é utilizado aqui como um modelo estável e auditável.
Falta de leitura
Com as duas cópias em Invalid:
CPU0 lê X
    emitir requisição de leitura/compartilhamento
    se nenhuma outra cópia coerente existir:
        CPU0 -> Exclusive
    caso contrário:
        cópias participantes -> Shared
Se outra cache possuir uma cópia Modified, a requisitante precisa receber os bytes mais novos. Retornar uma DRAM antiga enquanto existe uma cópia modificada mais recente quebraria a coerência.
Escrita em Shared ou Invalid
CPU0 quer escrever X
    solicitar propriedade exclusiva
    invalidar cópias coerentes concorrentes
    obter os reconhecimentos necessários
    garantir que os dados atuais estejam presentes
    CPU0 -> Modified
    realizar a escrita
A requisição pode ser difundida ou direcionada por um diretório. A regra do estado estável não exige uma interconexão específica.
Leitura de uma linha modificada em outra CPU
CPU1 lê X
CPU0 possui X em Modified
    localizar o proprietário atual
    transferir ou escrever de volta os bytes mais novos
    rebaixar o estado da CPU0 conforme o protocolo
    instalar uma cópia legível para CPU1
Em um MESI simplificado, ambas podem terminar em Shared. Em um protocolo da família MOESI, a antiga proprietária pode permanecer em Owned e continuar responsável pelos dados sujos.
Implementações reais exigem estados transitórios
Estados estáveis escondem latência. Transferir propriedade leva tempo. Um controlador pode estar aguardando dados, reconhecimentos de invalidação, escrita de uma vítima, resposta a uma sondagem ou repetição de uma requisição após pressão de recursos.
Um simulador detalhado pode precisar de estados transitórios conceituais como:
I -> IS    requisição de leitura emitida, dados pendentes
S -> SM    propriedade solicitada, invalidações pendentes
M -> MI    escrita de retorno / expulsão pendente
Um controlador não pode expor a linha como gravável antes de estabelecer a propriedade exclusiva exigida pelo protocolo. Muitos bugs difíceis de coerência aparecem apenas em corridas entre ações transitórias: faltas simultâneas, sondagem durante expulsão, esgotamento de filas ou duas CPUs requisitando propriedade ao mesmo tempo.
Um emulador funcional pode evitar essa complexidade se não modelar caches. Um simulador que afirma reproduzir coerência e temporização não pode omitir esse espaço de estados.
Organizações por snooping e diretórios
Snooping e diretórios respondem como os participantes descobrem as ações de coerência.
Snooping
Um sistema pequeno pode empregar uma interconexão logicamente difundida.
- Uma CPU emite uma requisição de leitura ou propriedade.
- As caches pares observam a requisição.
- Cada par responde de acordo com seu estado.
- A requisitante conclui após receber as respostas necessárias.
O modelo é conceitualmente simples, mas o custo de difusão cresce mal com a quantidade de participantes. Máquinas reais utilizam filtros, hierarquias e otimizações específicas da topologia.
Coerência por diretório
Um diretório registra quais agentes podem possuir uma linha e qual agente, se houver, possui permissão de escrita.
Um vetor completo com P bits de compartilhadores custa O(P) bits por linha rastreada em uma máquina com P processadores. Codificações esparsas reduzem o armazenamento no caso comum, mas precisam tratar overflow. Diretórios reduzem broadcast, porém adicionam consulta, armazenamento e roteamento de mensagens.
MESI/MOESI e snooping/diretório não são nomes concorrentes para a mesma coisa. MESI/MOESI descreve permissões e relações entre cópias. Snooping ou diretório descreve como a máquina coordena as transições.
Invalidação, atualização e tráfego
Coerência orientada a invalidação torna inutilizáveis as cópias concorrentes antes de permitir a escrita. Leitores posteriores precisam readquirir a linha. Protocolos de atualização, por outro lado, distribuem os novos dados às cópias já existentes.
Atualizar pode economizar uma falta futura quando muitos consumidores precisam imediatamente de todo novo valor, mas também pode desperdiçar largura de banda quando os pares nunca leem a atualização. O projeto de coerência equilibra latência, largura de banda, armazenamento, topologia e complexidade do controlador.
False sharing e ping-pong de propriedade
Considere uma linha de 64 bytes:
Não existe conflito lógico no código-fonte se cada variável possuir um único escritor. O protocolo de coerência, porém, enxerga uma única linha.
CPU0 obtém a linha para escrita -> cópia da CPU1 é invalidada
CPU1 obtém a linha para escrita -> cópia da CPU0 é invalidada
CPU0 obtém a linha para escrita -> cópia da CPU1 é invalidada
...
Esse ping-pong de propriedade pode dominar o custo mesmo sem uma CPU ler o contador da outra.
Mitigações seguem propriedade e medição:
- separar estado por CPU muito escrito em linhas diferentes;
- agrupar atualizações e combiná-las com menor frequência;
- particionar dados mutáveis por processador;
- reduzir contadores globais em caminhos quentes;
- medir antes de introduzir padding.
Preencher todas as estruturas pode ampliar o conjunto de trabalho, desperdiçar cache e aumentar pressão sobre a TLB. Não é uma otimização universal.
Operações atômicas dependem de coerência, mas não são coerência
Uma operação atômica read-modify-write precisa parecer indivisível para observadores participantes. Em uma máquina coerente com write-back, a implementação normalmente precisa de propriedade exclusiva da linha relevante enquanto a operação é consolidada.
O protocolo fornece uma cópia gravável única. A instrução define a transformação atômica. O modelo de memória define a ordenação ao redor dela.
O ChrisOS atual encapsula builtins de sincronização do compilador em kernel/metal/spin.c.
int cas_u32(volatile uint32_t *cell, uint32_t expected, uint32_t desired) {
    return __sync_bool_compare_and_swap(cell, expected, desired);
}
spin_lock repete CAS de 0 para 1 e executa pause após falha. spin_unlock utiliza __sync_lock_release. atomic_add_u32 utiliza __sync_fetch_and_add.
No caminho self-hosted do KCC, o compilador examinado emite lock cmpxchg para compare-and-swap suportado e lock xadd para fetch-and-add suportado. São primitivas arquiteturais x86 de sincronização. A semântica de atomicidade e ordenação pertence ao próximo capítulo; a coerência é a camada inferior que torna uma linha compartilhada um domínio significativo de propriedade.
O que o SMP nativo do ChrisOS faz atualmente
O kernel já foi escrito para mais de um processador físico ou virtual x86.
smp_init lê a resposta multiprocessada do bootloader, aloca pilhas para os application processors, publica os pontos de entrada dos APs e aguarda cpu_online_count atingir a quantidade esperada. A inicialização de um AP incrementa essa contagem com __sync_fetch_and_add.
A região da pilha do AP também identifica a CPU em execução. smp_current_cpu deriva o índice a partir da pilha atual em vez de confiar em um mapeamento LAPIC compartilhado. Protocolos de propriedade por CPU dependem de identificar corretamente o participante; confundir CPUs pode corromper reconhecimentos e decisões de propriedade.
Os locks do kernel protegem estruturas mutáveis compartilhadas. A documentação atual de locking define uma ordem entre JIT, gerenciamento de memória, heap, PMM e alguns subsistemas. A coerência torna as palavras de lock e os dados protegidos visíveis entre CPUs, mas não impede deadlock. A ordem de locks é uma propriedade de software.
Shootdown da TLB demonstra outro domínio de coerência
A alteração de tabelas de páginas mostra por que coerência da cache de dados não é suficiente.
Uma CPU pode observar coerentemente os bytes mais novos da tabela de páginas na memória e ainda utilizar uma tradução antiga já armazenada em sua TLB. Por isso o ChrisOS executa invalidação explícita de traduções.
O caminho atual de shootdown realiza conceitualmente:
- publicar o intervalo virtual que precisa de invalidação;
- identificar CPUs alvo online;
- enviar o IPI LAPIC de vetor 0xF0 quando possível;
- cada alvo executa mm_tlb_poll, aplica invlpg ao intervalo e reconhece a geração;
- a CPU iniciadora espera antes de permitir reutilização segura dos quadros físicos afetados.
Um participante que deixe de responder pode impedir reutilização segura. O código atual possui mecanismos de fencing e quarentena em vez de presumir que todo reconhecimento chegará.
Isso é coerência de tradução gerenciada por software. Não deve ser descrita como protocolo de coerência da cache de dados.
DMA e I/O coerente
Um dispositivo com DMA pode ser outro participante do sistema de memória. A necessidade de manutenção explícita de cache depende da plataforma.
Em uma plataforma com I/O coerente, a interconexão participa de um protocolo que preserva a visibilidade necessária. Em uma plataforma não coerente, o software pode precisar executar clean/invalidate ou utilizar mapeamentos com atributos especiais.
Portanto:
- volatile não cria coerência de DMA;
- uma memory barrier não escreve automaticamente linhas sujas para um dispositivo não coerente;
- caches coerentes entre CPUs não provam que determinado caminho de dispositivo seja coerente.
A documentação de drivers precisa declarar o contrato da plataforma antes de depender de coerência.
Código auto-modificável e visibilidade de instruções
Busca de instruções forma outro problema distinto. Uma CPU pode escrever bytes que depois serão executados. A arquitetura define procedimentos para tornar essas modificações visíveis à busca de instruções e para ordenar a transição entre escrita e execução.
Coerência da cache de dados não deve ser usada como prova completa de sincronização da cache de instruções. Um JIT precisa tratar separadamente:
- propriedade dos dados enquanto os bytes gerados são escritos;
- permissões de mapeamento e correção da TLB;
- sincronização de busca de instruções exigida pela arquitetura antes da execução.
O ChrisOS já possui trabalho explícito de TLB no ciclo de vida do JIT. Isso, isoladamente, não prova uma sequência completa de publicação de instruções para toda arquitetura.
ChrisCPU atual: um vCPU e nenhum modelo de coerência do guest
O modelo atual de ChrisVM possui um único ponteiro de CPU. machine.c chama backend->create_cpu(m, 0), e a documentação de backend define create_cpu como a alocação do vCPU 0.
O interpretador não modela atualmente:
- linhas privadas de cache L1/L2 do guest;
- estados MESI/MOESI;
- transferências cache-a-cache;
- filas de snoop ou probe;
- diretório de coerência;
- latência de coerência;
- execução simultânea de múltiplos vCPUs do guest.
As operações de memória do guest terminam no armazenamento compartilhado do hospedeiro por meio do caminho funcional de memória física descrito no capítulo anterior.
A consequência é precisa: o kernel nativo do ChrisOS possui requisitos SMP reais, mas o caminho direto atual do ChrisCPU não consegue reproduzir corridas que exigem dois processadores convidados.
As caches reais da CPU hospedeira continuam tornando o processo ChrisVM coerente e afetam o tempo de parede. Elas pertencem à microarquitetura do host, não ao modelo de cache do guest.
Requisitos para um ChrisCPU multiprocessado
Alocar mais estruturas ChrisCpu não é suficiente. Um projeto SMP confiável precisa declarar contratos explícitos.
Máquina compartilhada e topologia de vCPUs
ChrisMachine
    memória física compartilhada do guest
    dispositivos e roteamento de interrupções
    vCPU[0..N-1]
    semântica de ordenação de memória do guest
    modelo opcional de cache/coerência
    escalonador determinístico ou executor paralelo
Um intercalador determinístico melhora a reprodutibilidade. Threads hospedeiras paralelas podem aumentar desempenho, porém introduzem corridas no host que precisam ser sincronizadas independentemente da semântica convidada.
Transações atômicas de memória do guest
Uma instrução locked do guest não pode ser implementada como:
se outro vCPU puder executar entre essas etapas. O emulador precisa de uma transação indivisível do ponto de vista do guest ou de um mecanismo equivalente de sincronização global ou por linha.
Modelo de memória explícito
Mesmo sem caches simuladas, vários vCPUs exigem uma regra definida de ordenação. O emulador não deve herdar acidentalmente propriedades indefinidas do compilador ou da ISA do hospedeiro. Loads, stores, operações locked e fences do guest precisam de semântica deliberada.
Inicialização de APs e interrupções
A plataforma virtual precisará fornecer descoberta de APs, estado LAPIC, interrupções interprocessador e entrega por vCPU. Se todo boot direto permanecer restrito ao vCPU 0, o SMP do ChrisOS não poderá ser validado nesse backend.
Fidelidade opcional de cache
Um emulador SMP funcional pode deliberadamente apresentar memória compartilhada coerente sem modelar temporização de caches. Isso é válido se documentado. Um simulador que afirmar reproduzir MESI ou tempos de cache também precisará modelar estado por linha, transições, mensagens pendentes e limites de recursos.
Invariantes de protocolo testáveis
Para uma linha em todas as caches modeladas, um verificador MESI de estados estáveis pode impor:
quantidade de cópias M <= 1
quantidade de cópias E <= 1
se existir M, todas as demais cópias são I
se existir E, todas as demais cópias são I
a cópia M contém o valor autoritativo mais novo
todas as cópias S contêm o mesmo valor coerente
O verificador incluído com este capítulo testa:
- primeira leitura produzindo Exclusive;
- segundo leitor produzindo cópias Shared;
- promoção para escrita invalidando pares;
- intervenção de leitura sobre Modified;
- escritas concorrentes sequenciadas;
- ping-pong de false sharing em granularidade de linha.
O modelo é pequeno para que possa ser auditado. Ele não representa uma microarquitetura Intel ou AMD específica.
Custos de desempenho da coerência
Coerência gera tráfego adicional além de faltas de capacidade. Uma escrita pode exigir:
- latência da requisição de propriedade;
- mensagens de invalidação;
- reconhecimentos;
- transferência de dados de outra cache;
- writeback de vítima modificada;
- espera em filas da interconexão ou do diretório.
Uma linha local em Shared pode exigir upgrade antes de uma store. Uma falta de leitura pode receber dados diretamente de outra cache, sem que a DRAM seja a fonte crítica.
Uma análise útil deve separar faltas locais, upgrades de propriedade, invalidações, transferências remotas de cache, false sharing, saturação da interconexão e efeitos NUMA quando aplicáveis. Tempo de parede isolado não identifica o mecanismo dominante.
Limites de correção para o ChrisOS
O kernel nativo examinado presume memória compartilhada x86 coerente para RAM comum cacheável, o que é adequado ao alvo SMP x86 atual.
Isso não demonstra:
- que todo caminho DMA seja coerente;
- que volatile seja sincronização;
- que toda largura e alinhamento de acesso sejam atômicos;
- que entradas de TLB sejam automaticamente coerentes;
- que o ChrisCPU atual modele caches multiprocessadas;
- que o compilador possa reordenar livremente acessos ao redor da sincronização;
- que padding sempre melhore desempenho.
Cada item depende de uma regra arquitetural, protocolo de software ou medição própria.
Validação e limites da revisão
Este capítulo está conciliado com a revisão da branch main do ChrisOS da3df29cb397932c43d32373871fb9380e688ade.
Execute:
O verificador reproduz as transições MESI didáticas e a sequência de false sharing. Ele não executa o ChrisOS, não mede hardware, não valida detalhes internos de Intel ou AMD e não prova ausência de corridas no kernel.
Alterações em spin.c, smp.c, no protocolo de TLB, em ChrisCpuBackend, na execução de memória do guest, na inicialização de APs ou no modelo de locking devem disparar revisão deste capítulo.
O capítulo seguinte trata separadamente atomicidade e o contrato de ordenação de memória x86. Coerência restringe cópias de uma posição; o modelo de memória restringe a ordem observável entre operações.
Referências primárias
- Intel, Intel 64 and IA-32 Architectures Software Developer's Manual, System Programming Guide: gerenciamento multiprocessado, ordenação de memória e operações locked.
- AMD, AMD64 Architecture Programmer's Manual, Volume 2: System Programming, capítulo Memory System.
- AMD, AMD64 Architecture Programmer's Manual, Volume 1: Application Programming, visão geral de coerência e MOESI.