
Predição de branches e execução especulativa
Sobre este capítulo Datapath, microarquitetura e ISA
Neste capítulo
- Predição de branches e execução especulativa
- Escopo
- Por que control hazards reduzem throughput
- Predição de direção e de alvo
- Predição estática
- Predictor dinâmico de um bit
- Contadores saturantes de dois bits
- Histórico local e global
- Gshare
- Aliasing do predictor
- Branch Target Buffer
- Return Address Stack
- Predição de branches indiretos
- Fetch especulativo
- Execução especulativa
- Resolução do branch
- Recuperação de misprediction
- Momento de treinamento
- Accuracy e MPKI
- Acurácia depende do workload
- Fluxo de controle atual no ChrisCPU
- O ChrisCPU atual não possui estado de predictor
- Arquitetura mínima de predictor para um futuro ChrisCPU
- Registro de prediction por branch em voo
- Invariantes de flush
- Interação com exceções
- Interação com interrupções
- Predictor e mudanças de contexto
- Speculation e side channels
- Determinismo
- Estratégia de validação
- Métricas
- Complexidade
- Limitações atuais
- Fronteira de roadmap
- Registro de revisão
Escopo
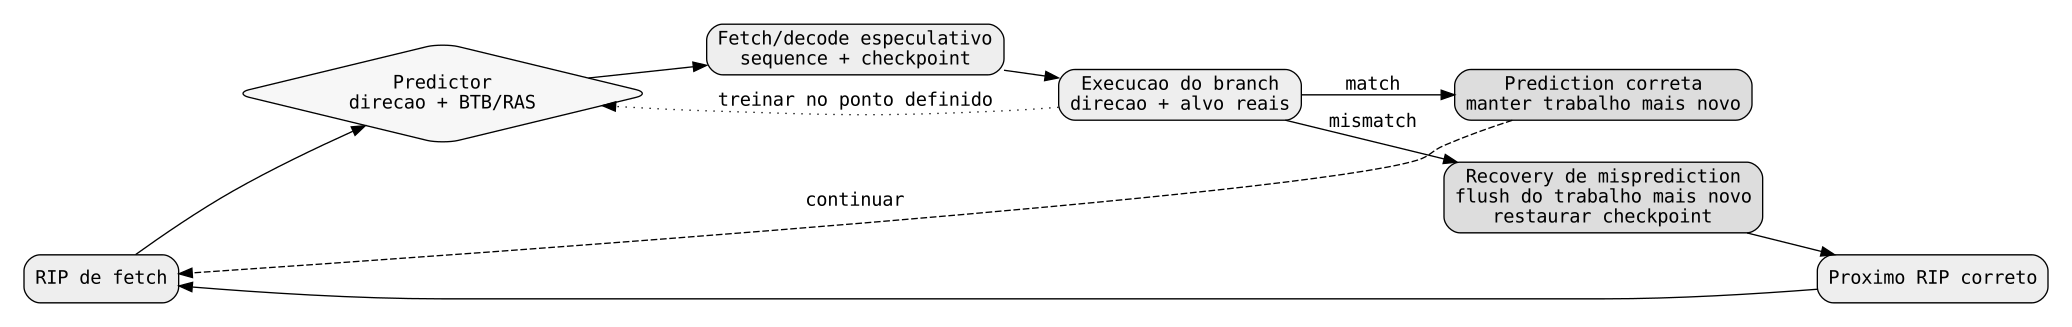
Um processador com pipeline precisa decidir o que buscar antes que todo branch anterior tenha necessariamente alcançado o ponto em que sua direção e alvo reais são conhecidos. Um branch predictor é um mecanismo microarquitetural que estima o fluxo de controle futuro para que o front end continue fornecendo trabalho útil. Speculation é o conceito mais amplo de permitir que operações baseadas nessa estimativa avancem antes da confirmação arquitetural.
Prediction não faz parte do estado arquitetural x86-64. Software correto não pode depender de um algoritmo específico, tamanho de tabela ou comprimento de histórico. O requisito arquitetural é que uma previsão errada seja recuperável: instruções do caminho incorreto não podem fazer commit de efeitos arquiteturais.
A implementação atual do ChrisCPU não prediz branches. Ela executa uma instrução arquitetural por vez, resolve o fluxo de controle de forma síncrona e só então inicia a próxima iteração. A teoria deste capítulo descreve microarquitetura de processadores reais e um possível backend temporal futuro do ChrisCPU, não o comportamento atual do interpretador.
Por que control hazards reduzem throughput
Considere um pipeline didático de cinco estágios em que um branch condicional é resolvido em EX. Quando o branch entra em IF, o processador ainda não sabe se a próxima instrução arquitetural é:
fallthrough = branch_rip + branch_length
ou:
target = fallthrough + signed_displacement
Se fetch esperar até EX determinar a condição, o front end pode perder vários ciclos por branch. Se branches ocorrem com frequência B e cada branch não resolvido introduz P ciclos perdidos, uma contribuição idealizada para CPI é:
CPI_control = B * P
Com acurácia de prediction A e custo de recuperação M:
CPI_mispredict = B * (1 - A) * M
Esse é um modelo didático. Máquinas reais sobrepõem trabalho, resolvem tipos diferentes de branch em profundidades distintas, podem possuir vários branches em voo e sofrem outras limitações de front end.
A conclusão estrutural é a mesma: prediction existe porque pipelines precisam de um próximo endereço de fetch antes que a decisão verdadeira esteja sempre disponível.
Predição de direção e de alvo
Um branch condicional cria pelo menos duas perguntas.
- Direção: o branch será tomado?
- Alvo: se tomado, qual endereço deve ser usado por fetch?
Para um Jcc relativo direto, o alvo pode ser calculado a partir do displacement decodificado. Porém o front end pode precisar do alvo antes do decode completo. Um Branch Target Buffer (BTB) armazena alvos de controle associados ao endereço de fetch.
Jumps e calls indiretos são mais difíceis porque o alvo depende de registrador ou memória. Returns são branches indiretos especiais, normalmente relacionados à estrutura de calls, e podem ser previstos por uma Return Address Stack (RAS).
Um front end prático separa funções:
| Estrutura | Função típica |
|---|---|
| Direction predictor | prever taken/not-taken de branches condicionais |
| BTB | prever alvo e frequentemente presença/tipo de branch |
| RAS | prever alvos de return |
| Indirect predictor | prever alvos obtidos de registradores/memória |
| History state | representar comportamento recente para correlação |
Essas estruturas são escolhas de implementação, não recursos visíveis pela ISA.
Predição estática
A estratégia mais simples não aprende em runtime.
Exemplos:
- sempre not taken;
- sempre taken;
- backward taken, forward not taken;
- hints do compilador em arquiteturas em que esses hints tenham significado.
Predição estática quase não exige estado de treinamento e é simples de reproduzir em um simulador. Sua limitação é não se adaptar a fases do programa ou branches dependentes de dados.
É uma boa primeira etapa para um pipeline educacional porque testa redirect e flush antes de introduzir estado dinâmico.
Predictor dinâmico de um bit
Um predictor de um bit armazena o último resultado observado para cada índice.
Estado:
0 = prever not taken
1 = prever taken
Update:
state <- actual_outcome
Para um branch de loop que é tomado muitas vezes e não tomado apenas na saída, um predictor de um bit frequentemente erra duas vezes entre invocações:
- na saída, porque as iterações anteriores eram taken;
- na primeira iteração da próxima invocação, porque a saída treinou not taken.
Isso motiva histerese.
Contadores saturantes de dois bits
Um predictor didático comum usa quatro estados:
00 strongly not taken
01 weakly not taken
10 weakly taken
11 strongly taken
O bit mais significativo forma a previsão. Taken incrementa até 11; not-taken decrementa até 00.
Pseudocódigo:
predict = counter >= 2

if actual_taken:
    counter = min(counter + 1, 3)
else:
    counter = max(counter - 1, 0)
São necessários dois resultados opostos consecutivos para sair de um estado forte e começar a prever a outra direção. Isso reduz sensibilidade a uma saída isolada de loop.
Uma tabela com N entradas de dois bits usa 2N bits de estado bruto, sem contar tags ou metadata. Quando indexada apenas por bits baixos do endereço do branch, branches diferentes podem compartilhar a mesma entrada. Essa aliasing pode ajudar por coincidência, ser neutra ou prejudicar a acurácia.
Histórico local e global
Alguns branches se correlacionam com seus próprios resultados anteriores. Outros se correlacionam com branches diferentes.
Um local-history predictor pode manter um shift register recente por branch ou índice. Esse histórico seleciona uma pattern table.
Um global-history predictor mantém uma única sequência recente:
GHR = ((GHR << 1) | actual_taken) & history_mask
Uma pattern table indexada pelo GHR pode aprender correlação entre branches. Porém branches estáticos diferentes passam a compartilhar padrões, a menos que o endereço também participe do índice.
Gshare
Gshare combina o endereço do branch e histórico global, normalmente por XOR:
index = (branch_index_bits XOR GHR) & mask
A ideia é que bits do endereço distingam branches estáticos enquanto GHR captura o caminho recente. XOR distribui combinações sem exigir uma tabela bidimensional.
Para uma tabela de 2^k contadores e histórico de k bits, o armazenamento inclui:
- 2^(k+1) bits para os contadores de dois bits;
- k bits para GHR;
- tags ou confidence metadata opcionais.
Aumentar k amplia capacidade de correlação, mas também aumenta armazenamento e pode aumentar aliasing destrutiva se a tabela for pequena para o working set.
Aliasing do predictor
Um predictor finito mapeia um grande espaço de endereços/históricos em uma tabela menor. Colisões são inevitáveis.
Se dois branches caem no mesmo contador e preferem direções opostas, podem destruir repetidamente o estado aprendido um do outro. Isso é aliasing destrutiva.
Predictors taggeados reduzem parte dessas colisões. Projetos mais avançados combinam múltiplos comprimentos de histórico e tabelas. O princípio continua: prediction é também um problema de alocação de armazenamento.
Em um simulador, aliasing deve ser deliberada e reproduzível. Um dicionário ilimitado indexado pelo RIP completo não reproduz as colisões de uma estrutura física finita.
Branch Target Buffer
Um BTB prevê que determinado endereço de fetch corresponde a controle e fornece um provável target.
Uma entrada conceitual:
| Campo | Significado |
|---|---|
| valid | entrada pode participar do lookup |
| tag | distingue endereços que compartilham o índice |
| target | destino previsto |
| type | conditional, jump, call, indirect, return |
| metadata | informação de replacement/confidence |
Em hit, o front end pode redirecionar antes do decode completo. Em miss, fetch pode continuar sequencialmente até decode ou execução descobrir o controle.
BTB não é o mesmo que direction predictor. Um branch condicional pode estar no BTB e ainda ser previsto not taken. Se for previsto taken, é necessário um target utilizável.
Return Address Stack
Calls e returns apresentam estrutura semelhante a uma stack:
call function
    ...
    ret
Uma RAS prevê returns empilhando o fallthrough do call e desempilhando no return.
Conceitualmente:
on predicted call:
    RAS.push(call_rip + call_length)

on predicted return:
    target = RAS.top()
    RAS.pop()
O comportamento fica mais difícil com exceções, controle não convencional, overflow/underflow, calls especulativos, caminhos errados e mudanças de contexto. Uma RAS especulativa pode exigir checkpoint ou recuperação para desfazer pushes/pops do caminho incorreto.
A call stack arquitetural em memória e a RAS microarquitetural são estruturas diferentes. Correção do software depende da primeira.
Predição de branches indiretos
O target de um branch indireto vem do estado arquitetural, não de displacement fixo.
Exemplos:
- jump por function pointer;
- virtual dispatch;
- switch dispatch;
- call indireto;
- return.
Um predictor simples pode memorizar o último target para determinado branch. Estruturas mais avançadas incorporam histórico porque o target frequentemente depende do caminho de execução.
Esse tipo de previsão é especialmente sensível a aliasing porque identidade do branch e identidade do target importam.
Fetch especulativo
Quando há prediction, fetch pode continuar pelo próximo RIP previsto antes de o branch ser resolvido.
Uma instrução especulativa precisa carregar identidade suficiente para ser invalidada. Metadata útil:
- sequence number ou idade;
- predicted next RIP;
- fonte/tipo da prediction;
- índice do predictor;
- snapshot de histórico;
- identificador de checkpoint;
- valid bit.
Isso é bookkeeping microarquitetural. O significado arquitetural da instrução não muda.
Execução especulativa
Prediction é mais valiosa quando instruções mais novas podem avançar por decode ou execute antes de branches anteriores serem resolvidos. Isso é speculative execution.
Regra central:
Trabalho especulativo pode usar recursos internos e produzir estado microarquitetural transitório, mas não pode modificar irreversivelmente estado arquitetural antes de ser validado.
Em pipeline in-order, isso pode significar retardar side effects até depois da resolução do branch. Em uma máquina out-of-order, resultados especulativos normalmente permanecem em physical registers, queues e reorder structures até retirement.
Memória e dispositivos exigem cuidado especial. Um write de MMIO de caminho incorreto não pode escapar apenas porque endereço e dados ficaram prontos.
Resolução do branch
Um branch condicional é resolvido quando se conhece:
- resultado real da condição;
- target ou fallthrough corretos;
- se prediction correspondeu.
Para um branch equivalente a Jcc:
actual_taken = condition(RFLAGS)

if actual_taken:
    actual_next = branch_rip + length + displacement
else:
    actual_next = branch_rip + length
Existe misprediction se direção ou target previsto diferirem do próximo endereço real.
A resolução pode ocorrer mais cedo ou mais tarde dependendo de onde operands e flags estão disponíveis. Resolver antes reduz penalty, mas pode exigir mais forwarding e complexidade no front end.
Recuperação de misprediction
Um mecanismo correto deve:
- identificar o branch cuja previsão falhou;
- calcular o RIP correto;
- invalidar todas as instruções mais novas do caminho errado;
- restaurar metadata especulativa alterada por elas;
- redirecionar fetch;
- preservar instruções anteriores válidas e estado já comprometido.
Em pipeline escalar mínimo, invalidar pode significar limpar valid bits em IF/ID e ID/EX.
Com global history especulativo, recuperação precisa restaurar o histórico. Um checkpoint pode salvar o valor anterior ao branch, ou a máquina pode reconstruí-lo a partir de metadata ordenada.
Com register renaming e out-of-order, a recuperação também restaura rename maps ou reconstrói a partir do estado comprometido. Esse tema aparece no capítulo seguinte.
Momento de treinamento
Uma escolha importante é quando atualizar o predictor.
Possibilidades:
- quando o branch executa;
- quando se torna não especulativo;
- em retirement.
Treinar cedo disponibiliza aprendizado mais rápido, mas exige política de undo/contaminação se o branch que treinou for depois eliminado por branch ou exceção anterior.
Para um primeiro ChrisCPU temporal, treinamento em retirement é mais simples. Pode ser menos realista que alguns processadores físicos, mas oferece invariante limpo: somente branches não eliminados atualizam estado permanente.
Se history especulativo for necessário antes de retirement, deve ser separado do committed history ou checkpointed.
Accuracy e MPKI
Acurácia:
accuracy = correct_predictions / total_predictions
Essa métrica pode ser enganosa quando a frequência de branch varia. Outra métrica útil:
MPKI = 1000 * mispredictions / retired_instructions
Um predictor pode ter alta acurácia percentual e ainda perder desempenho relevante se branches forem frequentes e a penalidade de recuperação for grande.
Estimativa simplificada:
lost_cycles ~= mispredictions * average_recovery_penalty
Isso não inclui poluição de cache, perturbação da instruction window ou perda de memory-level parallelism.
Acurácia depende do workload
Nenhum predictor possui uma acurácia universal. O resultado depende de:
- estrutura do código;
- dados de entrada;
- transformações do compilador;
- inlining;
- layout de endereços;
- working set de branches;
- history length;
- tamanho das tabelas;
- context switches;
- mudanças de fase.
Um benchmark do ChrisCPU deve informar workload, instruções, branches e configuração, não apresentar um único percentual como propriedade intrínseca do algoritmo.
Fluxo de controle atual no ChrisCPU
O interpretador atual resolve controle de forma síncrona.
Para branches condicionais, do_jcc calcula o displacement relativo assinado e chama chris_cc_true usando RFLAGS arquitetural atual. Se a condição for verdadeira, escreve o target em arch.rip e marca rip_dirty. Se falsa, não altera RIP, e cpu_run avança pelo comprimento da instrução.
do_jmp, direto ou indireto, escreve o destino e marca rip_dirty.
do_call calcula o próximo RIP arquitetural, empilha pelo caminho do emulador, escreve o destino e marca rip_dirty.
do_ret desempilha o destino, ajusta RSP conforme a instrução e escreve RIP.
Portanto o loop nunca precisa de um RIP arquitetural adivinhado. Antes da próxima iteração, o efeito real da instrução atual já é conhecido.
O ChrisCPU atual não possui estado de predictor
A estrutura ChrisCpu revisada contém execução, IRQ, tracing, geração de TLB e break state, mas nenhum campo equivalente a:
- branch history table;
- pattern history table;
- BTB;
- RAS;
- indirect-target predictor;
- prediction confidence;
- speculative history;
- branch checkpoints;
- contador de misprediction.
A revisão atual também não contém reorder buffer ou rename map que sustentariam speculation mais profunda.
Essa ausência é uma fronteira arquitetural importante. Um trace do ChrisCPU atual representa fluxo realmente executado, não caminhos previstos e depois descartados.
Arquitetura mínima de predictor para um futuro ChrisCPU
Um primeiro modelo temporal deve preferir predictor explícito e inspecionável.
Configuração inicial possível:
direction table de 1024 entradas
contadores saturantes de 2 bits
BTB taggeado de 256 entradas
RAS de 16 entradas
fallback estático em BTB miss
Estruturas conceituais:
typedef struct {
    uint8_t counter;
} BranchCounter;

typedef struct {
    bool valid;
    uint64_t tag;
    uint64_t target;
    uint8_t type;
} BtbEntry;

typedef struct {
    BranchCounter pht[1024];
    BtbEntry btb[256];
    uint64_t ras[16];
    unsigned ras_top;
} BranchPredictor;
Isso não existe no source atual.
O predictor deve ficar separado do estado arquitetural para manter possível a execução diferencial com o backend funcional.
Registro de prediction por branch em voo
Cada branch previsto deve manter dados suficientes para validação:
| Campo | Função |
|---|---|
| branch_rip | identidade |
| predicted_taken | direção prevista |
| predicted_target | próximo endereço previsto |
| fallthrough | endereço sequencial |
| predictor_index | entrada usada para treinamento |
| history_before | estado de recuperação |
| sequence | idade da instrução |
| valid | branch ainda em voo |
Na resolução, prediction é comparada ao resultado real.
Um simples booleano "was predicted" não é suficiente quando existem tabelas, history e checkpoints.
Invariantes de flush
Um futuro ChrisCPU especulativo deve garantir:
- Nenhuma instrução do caminho errado pode fazer retirement.
- Nenhum store, MMIO ou port-I/O do caminho errado pode se tornar externo.
- Misprediction remove toda instrução mais nova e nenhuma mais antiga.
- Fetch retoma no próximo RIP arquitetural correto.
- Recovery de predictor não restaura estado anterior ao checkpoint correto.
- Exceções produzidas por instruções squashed não são entregues.
- Um branch treina predictor conforme política definida exatamente uma vez.
Esses invariantes podem ser testados independentemente da acurácia.
Interação com exceções
Suponha que uma instrução especulativa mais nova gere page fault, mas um branch anterior depois prove que ela estava no caminho errado. O fault não pode ser entregue arquiteturalmente.
Portanto informação de exceção produzida especulativamente deve ficar associada ao registro da instrução, e não ser aplicada imediatamente ao estado comprometido.
Essa é uma diferença significativa em relação ao caminho funcional atual, no qual helpers de memória podem chamar chris_raise diretamente durante execute. Um backend especulativo precisará:
- de helpers sem commit que retornem fault descriptors; ou
- de execução sobre shadow/speculative state com exception injection adiada.
Reutilizar helpers com side effects sem essa separação tornaria rollback inseguro.
Interação com interrupções
Interrupções externas devem ser reconhecidas em uma fronteira arquitetural definida. O predictor pode ter produzido várias instruções mais novas quando uma interrupção se torna elegível.
Um modelo simples pode:
- parar a entrada de novo trabalho especulativo;
- retirar instruções mais antigas até a fronteira escolhida;
- limpar instruções mais novas;
- entregar a interrupção usando estado comprometido;
- retomar fetch no RIP do handler.
Implementações mais agressivas podem adotar regras diferentes, mas visibilidade arquitetural deve permanecer precisa.
Predictor e mudanças de contexto
Branch predictors são normalmente estado microarquitetural, não estado arquitetural pertencente ao processo. Políticas de compartilhamento ou particionamento afetam desempenho e segurança.
Para um emulador educacional, possibilidades incluem:
- preservar predictor entre context switches;
- limpar em transições de privilégio selecionadas;
- manter estado por address space;
- permitir configuração para experimentos.
A política precisa ser documentada porque altera benchmark mesmo quando correção arquitetural é igual.
Speculation e side channels
Instruções especulativas podem modificar estado microarquitetural mesmo quando resultados arquiteturais são descartados. Cache fills, predictor updates e contenção podem criar diferenças temporais observáveis.
Esse é o tipo geral de problema evidenciado por ataques de speculative execution como Spectre. A lição relevante para um simulador é que impedir retirement do caminho errado não basta para afirmar ausência de side channels. Se caches e predictor tiverem tempo observável, updates especulativos podem ser detectáveis.
Um primeiro modelo funcional pode deliberadamente não modelar esses canais. Se temporização compartilhada for adicionada, a fronteira de segurança deve ser revisada explicitamente.
Determinismo
Um simulador orientado à documentação deve ser reproduzível.
Comportamento do predictor deve evitar aleatoriedade oculta, salvo se um seed determinístico fizer parte da configuração. A configuração deve registrar:
- tamanho das tabelas;
- history length;
- estado inicial dos counters;
- replacement policy;
- profundidade da RAS;
- política de flush entre contextos;
- momento de treinamento.
Um trace pode então registrar decisões:
cycle 1042
RIP 0xffffffff80001230
JNE +0x24
predicted: taken -> 0xffffffff80001256
actual: not-taken -> 0xffffffff80001236
recovery: flush seq > 801
Isso torna a microarquitetura inspecionável.
Estratégia de validação
Validação deve separar correção de qualidade da previsão.
Testes de correção
- branch sempre taken;
- branch sempre not-taken;
- branch alternante;
- calls e returns aninhados;
- jump direto;
- jump indireto;
- misprediction seguido por store no caminho errado;
- misprediction seguido por fault no caminho errado;
- branch cujas flags vêm por forwarding;
- interrupção enquanto há trabalho especulativo.
O estado arquitetural comprometido deve coincidir com o interpretador funcional.
Testes de estado do predictor
Para contador de dois bits:
start = 01
T -> 10
T -> 11
N -> 10
N -> 01
N -> 00
N -> 00
Para global history, verificar shift e máscara exatamente.
Para BTB, verificar index/tag e replacement.
Para RAS, verificar calls aninhados, overflow, underflow e recuperação de call especulativo squashed.
Execução diferencial
Executar o mesmo programa sob:
- ChrisCPU funcional;
- ChrisCPU temporal com prediction desativada;
- ChrisCPU temporal com prediction ativada.
A sequência arquitetural de retirement deve ser equivalente. Contagem de ciclos e traces especulativos podem diferir.
Métricas
Um backend temporal deve expor, no mínimo:
- retired instructions;
- conditional branches;
- predicted branches;
- correct predictions;
- direction mispredictions;
- target mispredictions;
- BTB hits/misses;
- RAS hits/misses;
- pipeline flushes;
- ciclos perdidos em recovery.
A partir disso são calculados accuracy, MPKI e recovery penalty médio.
Esses contadores não devem ser confundidos com TSC arquitetural sem uma definição explícita de temporização.
Complexidade
Lookup em tabela direct-mapped é O(1). Um BTB set-associative com A ways custa O(A) em um simulador de software direto. Push/pop de RAS é O(1).
Predictors baseados em history permanecem O(1) por branch quando quantidade de tabelas e cálculo do índice são fixos.
O maior custo de um simulador detalhado normalmente não é o lookup do predictor, mas a manutenção de instruções especulativas, checkpoints e recovery.
Limitações atuais
Na revisão analisada, ChrisCPU não modela:
- branch direction prediction;
- BTB;
- return prediction;
- speculative fetch;
- wrong-path decode/execute;
- branch checkpoints;
- predictor training;
- branch misprediction penalty;
- predictor side channels.
A execução atual de branches é funcional e síncrona.
Fronteira de roadmap
Uma sequência segura:
- adicionar classificação explícita de branch e registros de outcome/target reais;
- implementar prediction estática em backend temporal;
- provar flush e recovery contra o interpretador funcional;
- adicionar contadores de dois bits;
- adicionar BTB taggeado;
- adicionar RAS;
- adicionar global history/gshare opcional;
- explicitar checkpoint de history especulativo;
- integrar predictor a futuros checkpoints de rename/ROB;
- somente então considerar predictors indiretos ou multi-table mais complexos.
Sofisticação de prediction nunca deve avançar mais rápido que a correção do recovery.
Registro de revisão
Este capítulo foi reconciliado com a revisão e05a17fd76333114a3fb5c2452f38ca747d4ac56 da branch main do ChrisOS. Afirmações sobre implementação atual se limitam aos arquivos declarados. Algoritmos de predictor, equações temporais e estruturas especulativas são teoria arquitetural e proposta futura, não alegação de que ChrisCPU já os implementa.