
Representações intermediárias
Sobre este capítulo Construção de compiladores
Neste capítulo
- Representações intermediárias
- Escopo
- Por que compiladores introduzem IR
- Níveis de representação
- Node[] do ChrisC como high-level IR AST-like
- Representação de grafo por índices
- Informação preservada pela árvore ChrisC
- Control flow antes do lowering
- Lowering direto de Node[] para CLVM
- Branch fixups
- CLVM bytecode como low-level stack IR
- Stack IR versus three-address IR
- CLVM é representação executável, não apenas compiler IR
- A camada de types compiler/il
- Type merging em il_verify
- Garantias atuais do verifier
- Limitações atuais do verifier
- CLA como metadata ao redor da IL
- Geração de CLA companion no language pipeline
- KCC deliberadamente não possui general IR persistente
- Assembly do KCC é IR?
- ChrisO é object representation, não compiler IR
- Consequências para otimização
- Complexidade e comportamento de memória
- Evidência de validação
- Limitações atuais
- Fronteira de roadmap
- Mapa de source e revisão
Escopo
Uma representação intermediária, ou IR, é uma representação do programa usada entre o parsing da linguagem-fonte e a execução final ou geração de código da máquina-alvo. O termo cobre formas muito diferentes: abstract syntax trees, árvores tipadas, control-flow graphs, three-address code, static single assignment, stack bytecode, instruções de máquina virtual, IR de baixo nível orientada à máquina e registros de relocação de object files.
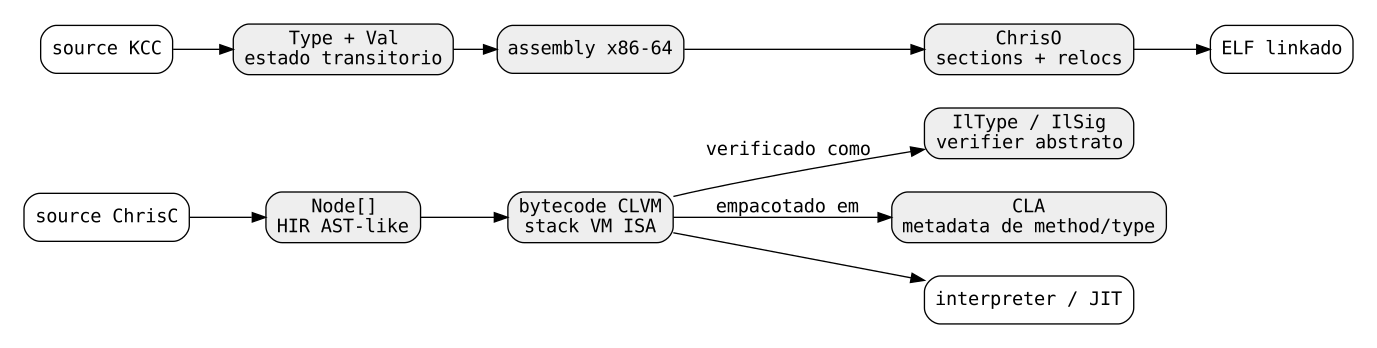
ChrisOS não possui atualmente uma IR universal compartilhada por todos os seus sistemas de linguagem.
Em vez disso, o projeto contém várias camadas de representação com finalidades diferentes:
- ChrisC constrói uma tabela fixa de registros Node semelhante a uma AST;
- ChrisC reduz esses nodes diretamente para stack bytecode CLVM;
- compiler/il fornece um pequeno sistema abstrato de types e um verifier sobre opcodes CLVM;
- CLA empacota bytes CLVM/IL com metadata de methods, types e referências;
- KCC mantém estado transitório Type e Val durante parsing e emite assembly x86-64 textual diretamente;
- ChrisAsm converte esse assembly em sections, symbols e relocations do formato target ChrisO.
Essas camadas não devem ser tratadas como se fossem a mesma coisa. Syntax tree, bytecode stream, type lattice de verificação e native object file resolvem problemas diferentes.
Por que compiladores introduzem IR
Um compilador pode traduzir source diretamente para machine code, especialmente quando a linguagem é pequena, mas uma IR cria uma fronteira estável entre front end e back end.
Uma IR útil pode fornecer:
- instruction vocabulary mais simples que a linguagem-fonte;
- semântica explícita de types e values;
- control flow normalizado;
- local para otimizações independentes do parser;
- target para verificação e debugging;
- portabilidade entre machine backends;
- source mapping estável;
- testes mais simples de transformations.
O custo é manter outra representação, sua alocação, invariants, validação e semântica.
ChrisOS atualmente usa os dois estilos. ChrisC possui uma representação AST-like persistente antes do lowering em CLVM. KCC combina parsing, semantic actions e native assembly emission, evitando uma general-purpose IR persistente.
Níveis de representação
É útil distinguir quatro níveis conceituais.
Uma high-level IR preserva conceitos próximos do source, como calls, fields, loops e typed expressions.
Uma mid-level IR costuma normalizar construções de source em operações e basic blocks explícitos, mantendo independência do target.
Uma low-level IR representa operações próximas de máquina, loads/stores, branches e calling conventions.
Uma virtual instruction set é executável por interpreter ou JIT e também pode funcionar como uma low-level IR.
No ChrisOS atual, Node[] é a representação mais próxima de high-level IR, enquanto o CLVM bytecode é a representação mais próxima de low-level stack IR / virtual ISA.
Não existe hoje uma IR geral em SSA, three-address ou control-flow graph explícito entre essas duas camadas.
Node[] do ChrisC como high-level IR AST-like
ChrisC transforma source em uma tabela fixa:
Node nodes[NODE_MAX]
dentro de Compiler.
NodeKind diferencia operações e statements como:
- blocks e declarations;
- assignments;
- if, while, for, do e switch;
- return, break, continue e goto;
- integer, float e string literals;
- variables e indexing;
- direct e indirect calls;
- arithmetic, comparison e bitwise operators;
- address e dereference;
- casts e sizeof;
- ternary e comma expressions;
- field e pointer-field access;
- pre/post increment e decrement.
Um Node guarda referências inteiras para left, right e third children, link next, payload value, source line/column, classificação float, um structure/type side ID e um pequeno campo name.
Isso é mais que uma parse tree, porque os nodes já contêm informação semântica e orientada ao lowering. Ainda é AST-like porque as construções do source permanecem reconhecíveis.
Representação de grafo por índices
Children são representados por índices inteiros, não por pointers.
Isso produz várias consequências.
Primeiro, todo o node graph reside num único array limitado. Alocar um node significa avançar nnode, e não executar heap allocation para cada nó.
Segundo, referências permanecem estáveis durante a vida da tabela.
Terceiro, inspection ou eventual serialization podem conceitualmente trabalhar com IDs inteiros em vez de host pointers arbitrários.
O trade-off é um hard limit NODE_MAX e uma representação ligada ao lifetime de Compiler.
Não existe garbage collection ou node reclamation durante a compilation. A construção funciona essencialmente como uma arena fixa.
Informação preservada pela árvore ChrisC
A árvore preserva informação suficiente para o lowering CLVM posterior reconstruir a intenção do source.
Source coordinates permitem diagnostics e source mapping.
Node kind preserva operation semantics.
Child references preservam a hierarquia de expressions e statements.
is_float permite ao lowering escolher operações floating do CLVM ou inserir conversions.
sid e índices de symbols preservam semântica selecionada de structures e storage.
name carrega identifiers ou labels para operações que precisam de textual identity.
Nem todos os detalhes do C type system são canonicalizados dentro da árvore. Como descrito no capítulo de semantic analysis, facts importantes permanecem em Symbol, StructDef, FuncDef e tabelas de typedef.
A high-level representation é, portanto, um graph mais semantic side tables, e não uma typed AST totalmente autossuficiente.
Control flow antes do lowering
No nível Node, control flow permanece estruturado.
Um if ainda é um if node com condition e branch subtrees.
Um loop permanece um loop node em vez de um ciclo de basic blocks.
Logical operators e ternaries continuam source-shaped nodes.
Isso simplifica code generation, mas impede que vários algoritmos clássicos de control flow operem diretamente sobre a representação.
Não existe hoje uma passagem que converta Node[] em:
basic blocks
predecessors/successors
dominator tree
dominance frontier
phi nodes
def-use chains
Consequentemente, ChrisC não executa otimização em estilo SSA sobre sua representação de programa.
Lowering direto de Node[] para CLVM
gen_expr e gen_stmt percorrem recursivamente o Node graph e emitem bytes CLVM diretamente em Compiler.out.
Os primitive emission helpers operam sobre o byte stream final.
byte escreve um opcode byte.
push escreve CL_OP_PUSH seguido por immediate de 32 bits little-endian.
fpush escreve CL_OP_FPUSH seguido pelo bit pattern floating.
branch reserva bytes para relative branch.
patch preenche posteriormente o relative displacement quando o destination program counter é conhecido.
A propriedade arquitetural importante é que não existe uma segunda instruction-list IR entre o Node graph e os bytes CLVM.
Assim que gen_expr ou gen_stmt emite um opcode, aquela parte do programa já cruzou para o virtual-machine instruction format.
Branch fixups
Forward control-flow targets nem sempre são conhecidos no primeiro momento da emissão.
branch escreve um placeholder de displacement e retorna o byte offset da instruction.
patch calcula:
displacement = target_pc - next_instruction_pc
e grava o valor relativo nos bytes reservados.
O helper atual promove os principais branch/call forms para variantes de 32 bits, como CL_OP_JMP32, CL_OP_JZ32, CL_OP_JNZ32 e CL_OP_CALL32, ao criar esses placeholders.
É um mecanismo clássico de fixup. Não é uma CFG: o control flow já está codificado em instruction bytes e apenas recebe o offset posteriormente.
CLVM bytecode como low-level stack IR
compiler/clvm/clvm.h define a virtual instruction set executável.
O instruction set inclui categorias como:
- constants: PUSH, PUSH64, FPUSH;
- integer arithmetic: ADD, SUB, MUL, DIV, MOD;
- floating arithmetic: FADD, FSUB, FMUL, FDIV;
- comparison operations;
- bitwise e shift operations;
- stack manipulation: DUP, DROP, SWAP;
- loads e stores com formas byte, 32-bit, 64-bit e float;
- relative control flow;
- direct e indirect calls;
- conversion operations FTOI e ITOF;
- argument/local instructions;
- object/field instructions;
- string e safepoint operations;
- system-call entry.
Como a maior parte da arithmetic consome operands do VM stack e coloca results novamente na stack, CLVM é uma representação de stack machine, não uma IR baseada em registers ou three-address.
Stack IR versus three-address IR
Uma expression como:
a + b * c
pode conceitualmente ser reduzida em stack IR para:
load a
load b
load c
mul
add
Uma three-address IR poderia usar temporaries explícitos:
t1 = mul b, c
t2 = add a, t1
Stack IR é compacta e combina naturalmente com interpreter.
Three-address IR deixa data dependencies mais explícitas e costuma facilitar várias análises de otimização.
ChrisC atualmente favorece a forma stack executável porque CLVM é simultaneamente compilation target e runtime ISA.
CLVM é representação executável, não apenas compiler IR
Classificar CLVM como IR é útil apenas com essa ressalva.
O mesmo byte stream é:
- produzido pelo ChrisC;
- empacotado em CLV images;
- interpretado por ClvmVm;
- consumido pelo JIT;
- inspecionado pela infraestrutura de verification.
CLVM não é apenas um temporary internal compiler format. É uma execution boundary estável e uma virtual-machine ISA.
Por isso alterações na semântica de opcodes têm impacto maior que alterações em uma IR privada usada somente durante compilation.
A camada de types compiler/il
compiler/il não define outro instruction encoding.
Ele define um pequeno vocabulário abstrato:
IL_VOID
IL_I4
IL_I8
IL_F4
IL_F8
IL_PTR
IL_REF
e um IlSig contendo return type, argument count e até oito entradas de argument type.
il_verify percorre CLVM bytecode simulando uma abstract operand stack.
A verifier stack possui atualmente limite de 256 entries.
Para PUSH, adiciona IL_I4.
Para PUSH64, adiciona IL_I8.
Para FPUSH, adiciona IL_F4.
Arithmetic retira operands e usa bin_t para derivar a categoria resultante.
Loads substituem uma entrada address-like pelo loaded value type.
Stores consomem address e value.
Conditional branches consomem condition.
Isso é abstract interpretation do bytecode, e não uma nova IR emitida.
Type merging em il_verify
bin_t implementa uma regra pequena de widening.
Se algum operand for IL_F8, o resultado é IL_F8.
Caso contrário, IL_F4 domina integer categories.
IL_I8 ou IL_PTR resulta em IL_I8.
IL_REF possui caminho especial.
Nos demais casos, o result é IL_I4.
Esse modelo é muito menor que o type system do ChrisC ou do C.
O verifier rastreia stack shape e broad categories, e não a identidade completa dos source-language types.
Garantias atuais do verifier
il_verify valida algumas propriedades estruturais importantes:
- immediates das instructions reconhecidas não ultrapassam o method byte range recebido;
- stack pops não sofrem underflow em várias operações;
- abstract pushes não excedem o limite de 256 entries;
- field operations selecionadas recebem category compatível com address/reference;
- CALLT pode consumir arguments com base na supplied signature;
- typed conversion opcodes atualizam a abstract stack type.
Esses checks conseguem rejeitar byte streams malformados antes da execução nos caminhos que invocam o verifier.
Limitações atuais do verifier
A implementação é intencionalmente pequena e não deve ser descrita como um bytecode proof system completo.
Na revisão documentada, ela não constrói control-flow graph nem propaga stack states independentes por branches.
Não faz merge de abstract states nos join points.
Não verifica que branch displacements apontem para instruction boundaries válidas.
O default case de opcode atualmente avança sem rejeitar explicitamente todo opcode desconhecido.
RET pode retirar um value se existir, mas a implementação não estabelece complete return-type conformance em todos os paths.
IlSig possui args[8], enquanto o wire format CLA atual persiste return type e argument count, mas não serializa o array completo de argument types.
Portanto, il_verify deve ser entendido como bounded stack/type structural verifier, não como verifier completo de uma managed-runtime IL madura.
CLA como metadata ao redor da IL
CLA é um container, não uma instruction language diferente.
ClaMethod guarda:
- method name;
- relative byte offset;
- method byte size;
- metadata IlSig.
ClaType guarda type name, size, GC bitmap e field count em memória.
ClaImage reúne methods, types, nomes de assemblies referenciados e uma região de IL bytes.
cla_write serializa esse metadata seguido pelos IL bytes.
cla_parse reconstrói a view.
cla_load_bytes valida o range de cada method e chama il_verify sobre cada method slice antes de aceitar a image. Também resolve referências de CLA por nome contra assemblies já carregados.
Assim, CLA adiciona module/method/type metadata ao redor de executable IL sem transformar o instruction stream numa nova IR.
Geração de CLA companion no language pipeline
O language pipeline atual mostra claramente essa distinção.
Depois que ChrisC produz code_buffer e o CLV image é escrito, o pipeline também constrói um pequeno ClaImage.
Ele cria um único method chamado main, aponta para o mesmo code buffer, registra method size e classificação de return IL_I4 e escreve um arquivo CLA companion.
Os code bytes são reutilizados. Não existe uma passagem separada de lowering ChrisC-to-CLA.
CLA é uma camada de metadata/package sobre o CLVM instruction stream já produzido nesse caminho.
KCC deliberadamente não possui general IR persistente
KCC segue outra arquitetura.
Durante expression parsing, ele carrega um Val contendo Type, lvalue classification, location local/global/address e immediate state.
Esses registros são semantic/code-generation state transitório.
O parser emite assembly x86-64 textual em g_asm à medida que reconhece o source program.
Ao final de kcc_compile_named:
preprocess
    ->
compile_unit
    ->
assembly text em g_asm
    ->
chrisasm_assemble
    ->
ChrisoImage
Não existe persistent AST nem target-independent instruction graph entre parsing e assembly.
Assembly do KCC é IR?
Textual assembly pode ser chamado de intermediate representation no sentido amplo do pipeline, pois existe entre source parsing no KCC e machine objects ChrisO.
Porém é assembly x86-64 target-specific, não uma portable compiler IR.
Registers, instructions, addressing e calling behavior já estão orientados à máquina.
Isso significa que um futuro backend não-x86 não poderia simplesmente reutilizar g_asm.
Uma target-independent IR teria de existir antes dessa etapa.
ChrisO é object representation, não compiler IR
ChrisAsm produz um ChrisoImage.
ChrisoImage contém target sections:
- text;
- rodata;
- data;
- bss;
além de ChrisoSym e ChrisoRel relocation records.
Essa representação já pertence ao território machine-code/object.
Ela suporta linking, symbol resolution e relocation, mas não preserva semantics de arithmetic expressions, source loops ou typed operations adequadas a target-independent optimization.
Na documentação, ChrisO pertence depois de native code generation, e não à camada principal de IR.
Consequências para otimização
O design atual do ChrisC permite transformations locais de árvore antes da emissão, mas não existe framework geral de optimization passes sobre Node[].
Depois que bytes CLVM são emitidos, relações high-level tornam-se mais difíceis de reconstruir.
O KCC pode fazer otimizações locais durante emission, como seu dead-store handling, mas não possui program graph estável para global analyses.
A ausência de infraestrutura geral de IR significa que hoje não existe framework comum para:
- constant propagation sobre CFG;
- common subexpression elimination;
- dead-code elimination baseada em liveness;
- loop-invariant code motion;
- register-independent instruction scheduling;
- SSA-based value numbering;
- generic target lowering.
Isso não significa ausência total de otimização. Significa que optimizations são locais e específicas em vez de organizadas num shared IR pass pipeline.
Complexidade e comportamento de memória
Node allocation é O(1) por node até atingir NODE_MAX.
Uma traversal completa por gen_expr/gen_stmt tende a O(n) no número de nodes visitados.
Byte emission é append-oriented e O(1) por byte/instruction, fora bookkeeping de fixups.
il_verify executa linear bytecode walk sobre a sequência inspecionada, com abstract stack fixa de 256 entries.
KCC evita custo de allocation de AST, mas paga pelo acoplamento entre parse-time state e backend emission e pela necessidade de rollback em contextos como sizeof expressions.
São trade-offs de engenharia diferentes, e não uma hierarquia universal entre designs.
Evidência de validação
Os language tests do ChrisC exercitam source constructs que formam Node trees e executam o CLVM resultante.
test_chrisc_c17.c cobre subset amplo incluindo structures, casts, arrays, function pointers e control flow.
tools/test_cla_gc.c constrói CLA image, escreve, recarrega, verifica um IL method e exercita loading de references.
Os tests do KCC compilam snippets e source real do kernel através de assembly até ChrisoImage.
O build também compila compiler/il, CLA e runtime language pipeline como partes ativas do projeto.
Esses testes demonstram que os caminhos de representation descritos estão ativos. Eles não provam propriedades como SSA correctness porque SSA não existe atualmente nesse compiler pipeline.
Limitações atuais
Na revisão documentada:
- não existe uma compiler IR universal do ChrisOS;
- ChrisC Node[] é AST-like e não uma normalized CFG IR;
- type information fica parcialmente em semantic side tables e não integralmente em cada node;
- ChrisC faz lowering direto de Node[] para CLVM bytes;
- não existe general three-address ou SSA representation;
- não existem phi nodes, dominator structures ou def-use chains explícitos;
- CLVM é executable VM bytecode, não apenas private compiler IR;
- compiler/il verifica CLVM com pequeno abstract type system, sem definir outro instruction set;
- il_verify não executa full control-flow verification;
- CLA é principalmente metadata/container ao redor da IL;
- KCC emite target-specific assembly durante parsing e não possui persistent general AST/IR;
- ChrisO é native object representation posterior ao codegen;
- optimization é local e subsystem-specific, não organizada em torno de shared pass manager.
Fronteira de roadmap
Uma futura compiler architecture poderia introduzir uma typed target-independent IR entre semantic analysis e backends CLVM/native.
Um design útil poderia incluir:
- explicit basic blocks;
- typed virtual registers ou SSA values;
- load/store e address operations com widths claros;
- calls e returns normalizados;
- explicit conversion operations;
- source spans;
- function signatures;
- target-independent control flow;
- verifier invariants;
- deterministic serialization para debugging;
- pass interfaces para analysis e transformation.
ChrisC poderia reduzir Node[] para essa IR.
KCC poderia parsear para a mesma representação ou uma forma native-oriented compatível.
CLVM e x86-64 então seriam backends separados de uma semantic representation compartilhada.
Essa arquitetura poderia permitir cross-backend differential tests e reusable optimization passes.
Nada disso descreve comportamento atual até existir source e validation correspondentes.
Mapa de source e revisão
A high-level representation e lowering do ChrisC ficam em compiler/chrisc/chrisc.c, especialmente NodeKind, Node, Compiler.nodes, gen_expr, gen_stmt, byte, push, branch e patch.
A executable low-level representation é definida por ClvmOpcode em compiler/clvm/clvm.h.
A abstract verifier type layer está em compiler/il/il.h e compiler/il/il.c.
CLA metadata e loading estão em compiler/cla/cla.h e compiler/cla/cla.c, com a geração de CLA companion visível em compiler/lang_pipeline.c.
O caminho direto source-to-assembly do KCC está em compiler/kcc/kcc.c e termina em chrisasm_assemble e ChrisoImage.
Todas as afirmações sobre comportamento atual deste capítulo foram reconciliadas com a revisão ChrisOS e05a17fd76333114a3fb5c2452f38ca747d4ac56.