
Parsing e gramáticas
Sobre este capítulo Construção de compiladores
Neste capítulo
- Parsing e gramáticas
- Escopo
- Gramática versus implementação
- Input do parser ChrisC
- Output do ChrisC
- Primary expressions
- Postfix
- Unary
- Cast versus expressão entre parênteses
- Compound literals
- Precedência binária no ChrisC
- Associatividade à esquerda
- Assignment à direita
- Ternary
- Comma operator
- Calls e arguments
- Declarations dentro de statements
- Ambiguidade de typedef
- Statements e blocks
- For loops
- Top level
- Initializers
- Fail-fast no ChrisC
- Semântica dentro do parsing ChrisC
- Arquitetura do parser KCC
- Primary, postfix e unary no KCC
- Precedence climbing
- Longest operator no KCC
- Associatividade binária no KCC
- Short circuit
- Assignment no KCC
- Ternary no KCC
- `sizeof` e speculative parsing
- Declarations no KCC
- Parameters
- Globals e functions
- Inline forms
- Constant expressions
- Error handling no KCC
- Recursive depth
- Grammar do ChrisAsm
- Grammar do CLASM
- Parser generator versus design atual
- Evidência de validação
- Testes ainda úteis
- Segurança e robustez
- Limitações atuais
- Fronteira de roadmap
- Mapa de source e revisão
Escopo
Parsing transforma token stream ou character stream em uma interpretação estruturada do programa.
No ChrisOS não existe parser gerado nem grammar engine compartilhado.
As ferramentas atuais são hand-written:
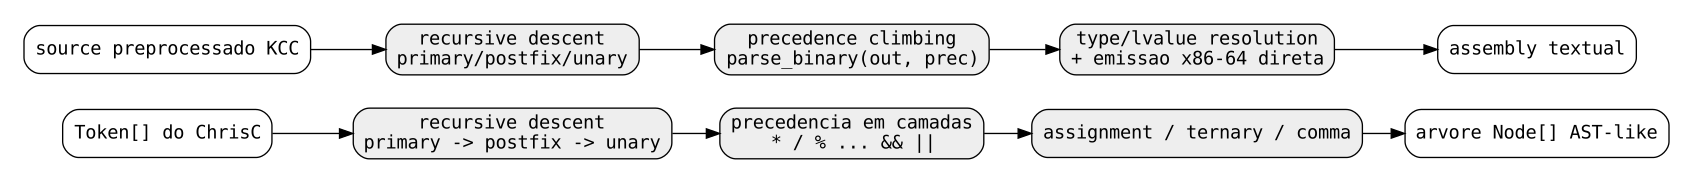
- ChrisC usa recursive descent sobre `Token[]` e constrói records `Node` semelhantes a AST.
- KCC combina scanner, recursive descent, precedence climbing e geração nativa diretamente sobre o pointer do source preprocessado.
- ChrisAsm e CLASM usam parsers pequenos por linha, apropriados a gramáticas de assembly.
Este capítulo documenta como esses parsers reconhecem estrutura, precedência e associatividade, onde sintaxe e semântica se misturam e quais partes do language profile são específicas do projeto.
Gramática versus implementação
Uma gramática descreve combinações válidas de símbolos.
Um parser decide se o input segue essa gramática e normalmente constrói alguma representação.
Uma forma simplificada da gramática de expressões seria:
expression
    := assignment ("," assignment)*

assignment
    := logical_or
     | logical_or "=" assignment

logical_or
    := logical_and ("||" logical_and)*
ChrisC implementa esse estilo diretamente em funções C.
KCC codifica parte da mesma precedência numericamente dentro de um parser de precedence climbing.
Nenhum deles é gerado por BNF, EBNF, Yacc/Bison ou arquivo declarativo.
O source atual é a grammar executável.
Input do parser ChrisC
ChrisC começa o parsing depois de preprocessing e lexical analysis.
O parser opera sobre:
Helpers fornecem, conceitualmente:
- token atual;
- consumo condicional;
- expectativa obrigatória;
- criação de diagnostic.
Como kind e source position já existem nos tokens, o parser trabalha em nível de token, não de caractere.
Output do ChrisC
ChrisC constrói nodes em:
Um node guarda:
- kind;
- children left/right/third;
- next;
- payload inteiro;
- line/column;
- classificação float;
- informação lateral de struct/type;
- name.
A representação é AST-like, mas contém também estado útil ao lowering.
Parsing e semantic analysis não são fases totalmente separadas.
Primary expressions
`primary` reconhece formas básicas como:
- integer literal;
- float literal;
- string literal;
- expressão entre parênteses;
- identifier;
- enum/constants;
- calls;
- function references;
- array indexing;
- member access;
- `_Generic`.
A função já consulta tabelas de constants, symbols e functions.
Por isso, um identifier desconhecido pode falhar ainda durante construção da árvore.
Isso já é trabalho semântico dentro do parser.
Postfix
`postfix_expr` estende repetidamente uma expressão.
Trata formas como:
e combinações encadeadas.
Como o loop envolve o resultado anterior, postfix operations ligam mais forte que operadores binários e associam naturalmente da esquerda para a direita.
Unary
`unary` cobre:
Operadores prefix chamam `unary` recursivamente.
Assim:
vira estruturalmente:
Cast versus expressão entre parênteses
Em C-like syntax existe a ambiguidade clássica:
Pode ser uma expressão entre parênteses ou início de cast se `x` for type name.
ChrisC resolve com:
seguido de:
Se os tokens após `(` formam um type reconhecido, segue pelo cast.
Caso contrário, `primary` trata como parenthesized expression.
Portanto conhecimento de typedef participa diretamente da gramática.
Compound literals
Depois de um cast type, ChrisC também aceita forma com braces:
A implementação atual analisa a expressão relevante e consome itens adicionais separados por comma até fechar o brace.
É comportamento específico do projeto, não uma implementação completa de todas as regras de initializer do C.
Precedência binária no ChrisC
ChrisC implementa precedência como camadas de recursive descent.
O helper:
chama primeiro o nível mais forte e depois consome operadores do nível atual.
A ordem atual, do mais forte para o mais fraco, é:
Isso acompanha a precedência usual do C para os operadores suportados.
Associatividade à esquerda
`binary` começa com:
e repetidamente cria node com:
Logo, operadores desse helper associam à esquerda.
Exemplo:
é:
Assignment à direita
`assignment_expr` primeiro lê `logical_or`.
Ao encontrar assignment ou compound assignment, o lado direito chama novamente:
Isso produz associatividade à direita:
vira:
Ternary
O operador `?:` também fica em `assignment_expr`.
Depois do condition e de `?`, branches são parseados com lógica de assignment expression.
O colon é obrigatório.
O node guarda três filhos:
A estrutura recursiva permite ternaries aninhados.
Comma operator
O nível mais fraco é:
Ele lê uma `assignment_expr` e depois repete enquanto houver comma.
Cada comma cria `N_COMMA` entre resultado anterior e próxima assignment expression.
Isso torna comma left-associative na AST.
Calls e arguments
Quando identifier é seguido de `(`, ChrisC cria call node.
Arguments são parseados como:
e não como full comma expression, porque comma separa argumentos nesse ponto da grammar.
Nested calls são primeiro armazenadas em array local.
O comentário no source registra o motivo: usar diretamente a tabela compartilhada já permitiu que arguments de nested calls se intercalassem.
É um exemplo de bug estrutural de parser causado não pela grammar, mas pelo storage usado durante o parse.
Declarations dentro de statements
O statement parser reconhece declarations diretamente.
Ele trata formas suportadas envolvendo:
- integer widths;
- float;
- char;
- pointers;
- arrays;
- typedefs;
- structs/unions;
- enums;
- qualifiers;
- function-pointer-shaped declarations;
- alignment.
Ao parsear declaration válida, o parser pode imediatamente criar symbol-table entry.
Ambiguidade de typedef
Em C, identifier pode ser nome comum ou typedef.
ChrisC consulta:
e usa lookahead para decidir se statement começa uma declaration.
Assim, o parser depende de estado semântico para interpretar a gramática.
Statements e blocks
Block é reconhecido por braces.
`stmt_or_block` aceita:
- block braced;
- statement único embrulhado em block-like node.
O statement parser cobre formas do perfil atual como:
if
while
for
do
switch
case
default
break
continue
return
goto
labels
expression statements
declarations
For loops
ChrisC separa:
do parser principal de statements.
Initializer pode ser vazio, declaration suportada ou expression.
Step pode ser vazio ou expression.
Isso modela explicitamente a estrutura especial de semicolon/parentheses do `for`.
Top level
`parse_decls` percorre até `T_EOF`.
Distingue:
- typedef;
- enum;
- struct/union;
- globals;
- arrays;
- function prototypes;
- function definitions.
`parse_type_n` e tabelas de symbol/type participam das decisões.
Function parsing registra parâmetros e return metadata enquanto constrói o body.
Initializers
ChrisC tem parser especializado para global initializer.
Há caminhos separados para:
Helpers conseguem contar ou pular elementos em brace initializers acompanhando nesting de parentheses, brackets e braces.
Isso não é recovery genérico; é traversal específico de initializer.
Fail-fast no ChrisC
ChrisC normalmente encerra a compilation no primeiro parse error relevante.
Checks do tipo `expect` geram mensagens como:
Não existe panic-mode geral que sincronize no próximo semicolon e continue coletando dezenas de syntax errors.
Embora `ChrisResult` suporte múltiplos diagnostics estruturados, o parser continua majoritariamente fail-fast.
Semântica dentro do parsing ChrisC
Durante parsing já ocorrem operações como:
- lookup de variables;
- validação de struct fields;
- lvalue check;
- assignment-to-const check;
- function lookup;
- typedef classification;
- propagação de float/type metadata.
Logo, a fronteira:
é conceitual, não uma separação física limpa no source atual.
Arquitetura do parser KCC
KCC parseia diretamente de:
apontando para o source preprocessado.
Não existe `Token[]` nem AST.
Os helpers simultaneamente:
- reconhecem syntax;
- resolvem names/types;
- mantêm lvalue state;
- emitem assembly x86-64.
O parser é mais próximo de um syntax-directed translator.
Primary, postfix e unary no KCC
`parse_primary` trata literals, identifiers, parenthesized expressions e function-like names.
`postfix_tail` adiciona calls, indexing, member access e postfix inc/dec.
`parse_unary` trata prefix forms, casts, address/deref e `sizeof`.
O retorno `Val` carrega type e codegen state.
Precedence climbing
KCC implementa:
com arrays de operator spellings e numeric precedence.
Grupos atuais:
Primeiro lê unary.
Depois encontra operator válido no threshold atual e parseia o lado direito com:
É precedence climbing.
Longest operator no KCC
Como não existe lexer separado, `parse_binary` também precisa resolver fronteiras de operator.
Ele compara vários spellings e favorece o match mais longo.
Além disso evita que operator de um char seja tratado como prefixo de forms como:
Portanto parte da responsabilidade lexical está dentro do expression parser.
Associatividade binária no KCC
A chamada recursiva com:
faz equal-precedence operators agruparem à esquerda.
Isso vale para arithmetic, shifts, comparisons e bitwise no subset atual.
Short circuit
`&&` e `||` não passam pelo ordinary `apply_bin`.
O parser emite labels e conditional jumps durante o reconhecimento.
O right side só executa quando necessário.
Isso evidencia o acoplamento parse/codegen: reconhecer o operator já altera o control-flow assembly.
Assignment no KCC
Depois do binary layer, em top-level precedence, KCC verifica:
- ternary;
- compound assignments;
- ordinary assignment.
RHS usa `parse_expr` recursivamente.
Lvalue é validado imediatamente.
O destination `Val` é salvo, o right side emite native code e o result é armazenado durante o parsing.
Ternary no KCC
Para `?:`, KCC cria labels de branches durante o parse.
Ele parseia yes/no expression e emite jumps diretamente.
Não existe ternary AST node.
Parser e backend funcionam como uma transação única.
`sizeof` e speculative parsing
`parse_sizeof_type` mostra um efeito importante desse acoplamento.
Quando `sizeof` recebe expression, KCC precisa descobrir o type sem manter o código emitido.
A implementação salva e restaura:
- assembly length;
- overflow state;
- dead-store state;
- temporary count;
- frame state.
Assim, parseia a expressão e desfaz backend side effects.
É uma simulação de unevaluated expression por rollback.
Declarations no KCC
`parse_base` trata storage/type qualifiers e base types.
Inclui forms suportadas de:
- struct;
- pointers;
- typedef-like known types;
- volatile;
- const;
- unsigned;
- static/extern/inline.
Struct-body parsing calcula field offsets, alignment e size ao mesmo tempo.
Syntax e layout semantics estão combinadas.
Parameters
`parse_params` lê parameter declarations até `)`.
Trata pointer, array e function-pointer-like forms suportadas.
Também atribui frame offsets durante o parsing.
Parameters após os seis primeiros recebem positions de stack compatíveis com o calling-convention model da toolchain.
Globals e functions
`parse_global` diferencia:
- objects;
- arrays;
- function declarations;
- definitions;
- function pointers;
- initialized globals.
Ao reconhecer function definition, já emite:
e parseia statements emitindo o body.
Não existe AST posterior da função inteira.
Inline forms
Algumas `inline` forms podem ter body pulado em vez de compilado normalmente.
O parser usa brace-depth scanning para atravessar o body.
É comportamento do subset do projeto, não implementação geral da semântica C de inline.
Constant expressions
KCC mantém caminho separado:
Usado para:
- array bounds;
- enum values;
- preprocessor conditions;
- static assertions.
Esse parser replica boa parte da precedência normal, mas calcula values diretamente em vez de emitir runtime code.
Ter dois expression parsers cria obrigação de manter semantics e precedence alinhadas.
Error handling no KCC
KCC também é majoritariamente fail-fast.
Falha registra:
via `KccDiag`.
Não há recovery geral para continuar em declarations posteriores.
Como parser e codegen estão juntos, recovery seguro também exigiria rollback de assembly, symbols e frame state.
Recursive depth
ChrisC e KCC usam a própria C stack para nested syntax.
Source com nesting profundo de:
- unary;
- parentheses;
- declarators;
- statements;
pode consumir stack do processo/compiler.
Não existe um parser depth limit geral para todos os caminhos.
Algumas estruturas possuem limites próprios.
Grammar do ChrisAsm
ChrisAsm usa:
como dispatcher.
A linha começa com directive, label ou mnemonic.
Helpers leem:
- identifiers;
- integers;
- memory operands;
- strings;
- registers.
Cada branch de instruction valida operands esperados e emite bytes imediatamente.
É um parser preditivo hand-written para grammar pequena.
Grammar do CLASM
CLASM também parseia por linha.
Modelo aproximado:
Pass 1 registra labels e sizes.
Pass 2 resolve operands de label e emite bytecode CLVM.
Rejeita:
- unknown instruction;
- missing operand;
- extra text;
- undefined label;
- short branch fora de range.
Parser generator versus design atual
Um parser generator poderia fornecer:
- grammar declarativa;
- parse tables;
- conflict reporting;
- separação mais formal de semantic actions.
ChrisOS hoje usa parsers manuais porque:
- language subsets ainda evoluem;
- dependências permanecem pequenas;
- semantic/codegen state é muito específico;
- debugging direto do parser C é simples.
O custo é manter grammar, precedence e recovery manualmente.
Evidência de validação
ChrisC
`test_chrisc_c17.c` cobre declarations, calls, casts, `sizeof`, switches, loops, compound literals, `_Generic`, structs, arrays, function pointers e múltiplas translation units.
`test_chrisc_lang.c` compila e executa programas, validando o comportamento resultante no CLVM.
`test_fuzz_chrisc.c` envia source malformado pseudo-random e verifica que o compilador continua utilizável.
KCC
`test_kcc.c` parseia snippets e source real do projeto.
Cobre globals, functions, structs, pointers, arrays, expressions, volatile, relocatable calls e multi-object linking.
Assemblers
`test_chrisasm.c` e `test_clasm.c` exercitam suas line grammars e rejection paths.
Testes ainda úteis
A suite ganharia com testes focados em:
- cada fronteira de precedence;
- associatividade esquerda/direita;
- nested parentheses;
- nested ternary;
- assignment chains;
- comma expressions;
- typedef-name ambiguity;
- cast versus parenthesized expression;
- malformed declarators;
- unmatched braces;
- missing semicolon;
- parser stack-depth stress;
- rollback de speculative parsing no KCC;
- equivalência entre `ce_expr` e runtime expression precedence;
- diagnostics determinísticos para malformed forms equivalentes.
Segurança e robustez
Riscos de parser incluem:
- recursion depth;
- backtracking excessivo;
- rollback inconsistente;
- integer overflow em sizes derivados da grammar;
- exhaustion de tables;
- malformed nesting;
- backend parcialmente alterado após failure.
ChrisC normalmente avança sobre token stream já pronto e usa lookahead local, então a complexidade tende a ser próxima de linear em input normal.
KCC também avança principalmente um pointer, mas alguns helpers salvam/restauram positions e `sizeof` salva backend state.
Nenhum parser é documentado atualmente como hardened para source hostil arbitrário.
Limitações atuais
Na revisão documentada:
- não existe grammar declarativa;
- não existe parser generator;
- syntax/semantics são intercaladas;
- ChrisC AST contém lowering-specific state;
- KCC não tem AST e emite native assembly durante parsing;
- ambos são majoritariamente fail-fast;
- sem recovery geral de syntax error;
- type/typedef state participa diretamente do parse;
- KCC possui parsers separados para runtime e constant expressions;
- speculative parse pode exigir rollback de backend;
- suporte é project-specific, não full ISO C;
- nesting profundo depende da C stack;
- ChrisAsm/CLASM usam grammar code ad-hoc por instruction.
Fronteira de roadmap
Uma evolução pode incluir:
- machine-readable language-profile grammar;
- fronteiras mais claras entre syntax e semantics;
- parser contexts reentrantes;
- source-span objects;
- AST validation passes;
- typed IR antes de native codegen;
- precedence definition única reutilizada pelo constant parser;
- structured parser error codes;
- synchronization-based multi-error recovery;
- recursion-depth guards;
- grammar differential tests;
- coverage-guided parser fuzzing;
- documentação gerada a partir da grammar.
Esses itens continuam roadmap até existirem no source e testes.
Mapa de source e revisão
Parsing ChrisC está concentrado em `compiler/chrisc/chrisc.c`: primary/postfix/unary, layered binary precedence, assignment/comma, statements, blocks, declarators e top-level functions/globals. Parsing KCC está em `compiler/kcc/kcc.c`: scanner sob demanda, recursive descent, precedence climbing, constant expressions, declarations e emissão direta x86-64. Parsers de assembly ficam em `compiler/chrisasm/chrisasm.c` e `compiler/clvm/clasm.c`.
Todas as afirmações sobre comportamento atual foram reconciliadas com ChrisOS `e05a17fd76333114a3fb5c2452f38ca747d4ac56`.