
Spinlocks, exclusão de interrupções e ordem de locks
Sobre este capítulo Concorrência e propriedade de recursos
Neste capítulo
- Spinlocks, exclusão de interrupções e ordem de locks
- Escopo
- Compare-and-swap atômico
- Loop de aquisição
- PAUSE
- Unlock
- Inicialização
- Spinlock não é recursivo
- Reentrância por interrupção
- irq_save
- irq_restore
- Padrão de locking do PMM
- Recursão controlada do PMM
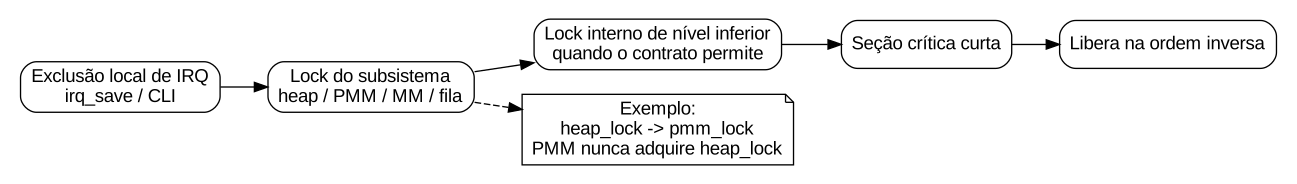
- Ordem heap → PMM
- Grafo de locks
- Limite IRQ-safety do heap
- Exemplo AC97
- Fila de jobs
- Contadores atômicos
- Acquire customizado em MM
- Serialização de TLB shootdown
- KMutex hoje é wrapper de Spinlock
- Modelo de KCond
- Locks de serial e klog
- Fairness
- Starvation e prioridade
- Lock não resolve lifetime
- Design da seção crítica
- Inicialização e publicação
- Error paths
- Performance
- False sharing
- Evidência de validação
- Limitações atuais
- Disciplina recomendada para o ChrisOS atual
- Fronteira de revisão
Escopo
Quando mais de uma CPU pode executar código do kernel, estado mutável compartilhado exige sincronização explícita.
O ChrisOS usa um spinlock pequeno construído sobre compare-and-swap atômico.
A estrutura é mínima:
Não existem owner, recursion count, fila de espera, política de fairness nem caminho de sleep.
Um waiter tenta repetidamente trocar locked de 0 para 1 e executa PAUSE enquanto o lock continua ocupado.
A simplicidade ajuda a entender o primitive, mas correção de sincronização exige muito mais que a função spin_lock.
O caller precisa responder:
- qual estado o lock protege;
- se IRQ pode reentrar na mesma CPU;
- qual é a ordem entre locks;
- se a seção crítica entra em outro allocator/subsystem;
- se o objeto continua vivo depois do unlock;
- se existe requisito de liveness, como acknowledgement de TLB.
Compare-and-swap atômico
cas_u32 usa:
A operação só retorna verdadeiro quando o valor anterior corresponde a expected e a substituição por desired ocorre atomicamente.
Para adquirir o lock:
Somente um CPU concorrente pode vencer essa transição para um estado unlocked.
Os demais recebem falha e repetem.
O source usa os builtins legados __sync do GCC, e não tipos atomics C11.
Essa escolha faz parte do contrato atual da toolchain.
Loop de aquisição
spin_lock equivale a:
É um busy-wait lock.
A CPU que espera continua executando instruções.
Spinlock é adequado quando:
- a seção crítica é curta;
- o owner deve progredir rapidamente;
- dormir é impossível ou mais caro;
- o contexto é baixo nível e não pode bloquear num scheduler.
Não é adequado para espera longa ou sem limite.
PAUSE
Depois de um CAS falhar, o código executa a instrução x86 PAUSE.
PAUSE não libera a CPU para um scheduler.
É apenas um hint para um spin loop.
O waiter continua ativo.
O ChrisOS usa PAUSE também em outros loops cooperativos, mas isso não transforma automaticamente esses loops em spinlocks.
Unlock
spin_unlock chama:
que devolve o estado do lock a zero por meio do primitive de sincronização do compilador.
A correção depende de o código protegido seguir consistentemente o mesmo contrato de acquire/release.
A teoria completa de memory ordering está no capítulo de atomics; aqui o ponto principal é que acesso ao estado protegido precisa obedecer uma disciplina única e explícita.
Inicialização
spin_init executa simplesmente:
O lock não pode ser usado concorrentemente antes que sua inicialização e o estado que ele protege estejam publicados.
Locks atuais são normalmente objetos estáticos inicializados durante o boot do subsistema antes de workers concorrentes.
Exemplos:
- heap_lock;
- pmm_lock;
- g_q_lock;
- g_serial_lock.
Spinlock não é recursivo
Spinlock não guarda CPU owner nem depth.
Se uma CPU que já possui o lock chamar spin_lock no mesmo objeto, o CAS nunca terá sucesso antes que a aquisição externa faça unlock.
Mas a aquisição externa não pode prosseguir enquanto a chamada interna gira.
Resultado: self-deadlock.
A recursão existente no PMM não é uma propriedade de Spinlock.
É uma camada específica construída ao redor de pmm_lock.
Reentrância por interrupção
SMP não é a única forma de concorrência.
Uma IRQ pode interromper código na mesma CPU.
Considere:
e o handler tentar:
O handler gira indefinidamente porque o código interrompido não volta para liberar L até o handler terminar.
Isso é deadlock na mesma CPU.
spin_lock isoladamente não desabilita interrupções.
irq_save
spin.h oferece:
No kernel freestanding ele:
- lê RFLAGS;
- executa CLI;
- devolve os flags anteriores.
Assim o caller sabe se IF estava ligado.
O inline assembly usa memory clobber para impedir movimentação livre de operações comuns pelo compilador através desse ponto.
Em testes CHRIS_HOST_METAL, CLI/STI são no-op porque seriam instruções privilegiadas no processo host.
irq_restore
irq_restore testa os flags salvos.
Se IF estava ligado, executa STI.
Se o código entrou com IF já desligado, mantém interrupções desabilitadas.
Isso permite composição com regiões que já tinham desabilitado IRQs.
Executar STI incondicionalmente seria incorreto porque alteraria o estado herdado do caller.
Padrão de locking do PMM
PMM é o exemplo mais claro de combinação entre exclusão local de IRQ e exclusão entre CPUs.
Na entrada externa, pmm_enter:
- obtém o software CPU index;
- salva IF e executa CLI;
- adquire pmm_lock;
- define recursion depth como 1.
Na saída externa, pmm_leave:
- zera depth;
- libera pmm_lock;
- restaura IF.
Isso protege o bitmap contra:
- outra CPU entrando ao mesmo tempo;
- IRQ na mesma CPU reentrando no PMM enquanto o lock está ocupado.
São problemas diferentes:
Recursão controlada do PMM
PMM permite nesting específico na mesma CPU.
Se pmm_depth[cpu] já é positivo, pmm_enter incrementa o contador e não tenta o spinlock outra vez.
Isso é necessário porque pmm_foreach_free_run chama um callback mantendo pmm_lock, e heap_init pode executar pmm_claim_at nesse callback.
A entrada externa já desligou interrupções. Assim uma IRQ não consegue aparecer na mesma CPU e ser confundida com recursão legítima.
A regra geral é:
recursão pertence ao contrato do subsistema, não ao spinlock genérico.
Ordem heap → PMM
O heap possui heap_lock global.
kmalloc pode manter heap_lock e chamar PMM quando precisa crescer.
A ordem atual é:
O PMM explicitamente não deve alocar pelo heap.
A ausência da relação inversa impede:
Lock ordering é, portanto, propriedade de todo o grafo de subsistemas.
Grafo de locks
Uma forma de raciocinar é representar cada lock como nó.
Quando código pode adquirir B segurando A, existe aresta:
Um sistema de ordem consistente deve manter o grafo acíclico.
Um ciclo:
representa uma possibilidade de circular wait quando CPUs diferentes ocupam pontos diferentes do ciclo.
À medida que o ChrisOS cresce, essas relações precisam permanecer documentadas.
Limite IRQ-safety do heap
heap.c usa heap_lock, mas kmalloc/kfree não fazem irq_save automaticamente.
Assim heap_lock não é, sozinho, proteção contra reentrância arbitrária do heap por IRQ na mesma CPU.
O contrato atual deve ser entendido como:
- kmalloc/kfree são serializados entre CPUs;
- não são automaticamente IRQ-reentrant;
- handlers que possam interromper um holder do heap precisam de desenho específico antes de entrar no allocator.
Isso é uma restrição da API, não uma afirmação de que todas as IRQs atuais violam o contrato.
Exemplo AC97
O áudio demonstra um lock combinado explicitamente com IRQ exclusion.
Um caminho produtor executa:
flags = irq_save()
spin_lock(g_ac97_lock)
modifica ring/estado do device
spin_unlock(g_ac97_lock)
irq_restore(flags)
Isso é necessário porque o estado também pode ser tocado pelo handler do dispositivo.
Nem todo spinlock precisa desligar IRQs; a necessidade depende de quem pode acessar o estado.
Fila de jobs
g_q_lock protege:
- head;
- tail;
- count;
- entries durante enqueue/dequeue.
job_submit adquire o lock, insere uma entrada, atualiza índices/count, incrementa g_inflight atomicamente e libera.
job_worker_once mantém o lock apenas durante a remoção.
O callback do job é executado depois do unlock.
Essa decisão é essencial.
Executar callback arbitrário mantendo g_q_lock produziria seção crítica longa e criaria possíveis dependências com qualquer lock adquirido pelo callback.
Contadores atômicos
g_completed e g_inflight usam atomic_add_u32.
Isso mostra que nem toda variável precisa do lock estrutural quando a operação pode ser um update atômico independente.
Entretanto atomic não resolve uma invariante composta automaticamente.
Head/tail/count e conteúdo da ring precisam ser alterados em conjunto, então continuam protegidos pelo lock.
Acquire customizado em MM
MM possui mm_lock, mas mm_enter não chama spin_lock diretamente.
O loop faz:
A razão é liveness.
Uma CPU aguardando mm_lock pode simultaneamente precisar reconhecer uma geração TLB publicada por outro CPU.
Se ficasse presa num spin genérico sem polling, o initiator poderia esperar por um ack que nunca chega.
Aqui sincronização precisa de um progress hook além de exclusão mútua.
Serialização de TLB shootdown
O publicador de shootdown usa outro flag CAS, mm_tlb_busy.
O wait loop também chama mm_tlb_poll.
Existe apenas um payload global de geração/range, então as publicações precisam ser serializadas.
Ao mesmo tempo, waiter precisa continuar respondendo ao protocolo de outra CPU.
É outro exemplo em que o loop de espera é especializado.
KMutex hoje é wrapper de Spinlock
kthread.h define:
kmutex_lock e kmutex_unlock chamam diretamente spin_lock/spin_unlock.
Logo KMutex não é atualmente um sleeping mutex.
Um kthread bloqueado nele ocupa a CPU em busy-wait.
O nome cria uma interface de nível mais alto, mas o mecanismo permanece spin-based.
Modelo de KCond
KCond armazena um volatile sequence counter.
kcond_wait:
- captura seq;
- libera KMutex;
- espera seq mudar;
- em UP chama job_worker_once para garantir progresso;
- em SMP executa PAUSE;
- readquire KMutex.
kcond_signal faz seq++.
É uma condição cooperativa simples, não uma wait queue do scheduler.
O incremento de seq é atualmente um volatile increment comum, não atomic_add_u32.
Se múltiplas CPUs sinalizarem a mesma KCond simultaneamente sem outra disciplina de proteção, updates podem colidir.
O protocolo externo precisa definir a sincronização correta.
Locks de serial e klog
serial.c protege saída COM1 com g_serial_lock por caractere.
klog.c protege ring buffer com g_lock.
Esses locks serializam estado entre CPUs.
Eles também não desabilitam IRQ automaticamente.
Como logging pode aparecer em paths de IRQ, fault e panic, reentrância precisa de cuidado: uma CPU interrompida enquanto possui um lock de diagnóstico não pode adquirir novamente o mesmo lock não-recursivo.
Esse é um risco clássico de logging de baixo nível e motivo para dependências mínimas em paths de emergência.
Fairness
O Spinlock genérico não usa ticket nem fila.
Todos os waiters competem repetidamente pela transição 0 -> 1.
Não existe garantia FIFO.
Uma CPU pode teoricamente perder várias vezes para concorrentes.
O primitive garante exclusão mútua, não fairness.
Starvation e prioridade
Não existe handoff orientado a prioridade.
O ChrisOS também não possui scheduler geral preemptivo por prioridade para esses usuários.
Mesmo assim a hipótese do spinlock é clara: o holder precisa continuar executando e liberar rapidamente.
Se scheduling evoluir, priority inversion e preemption segurando locks precisarão de política explícita.
Lock não resolve lifetime
Lock prova que dois CPUs não modificam simultaneamente um estado protegido.
Não prova que o objeto continua vivo depois do unlock.
Exemplo:
- CPU A remove objeto de tabela sob lock;
- libera lock;
- libera a memória;
- CPU B ainda possui referência obtida antes.
A solução pode exigir:
- reference counting;
- epoch/reclamation;
- TLB shootdown;
- quiescência de hardware;
- outra regra de lifetime.
A quarentena de TLB do ChrisOS é um exemplo concreto onde spinlocks não bastam.
Design da seção crítica
Uma seção protegida por spinlock deve evitar:
- loops muito grandes;
- espera por I/O;
- serial logging longo;
- callbacks arbitrários;
- alocação que cria ordem de locks desconhecida;
- operações de hardware com latência não limitada.
O source frequentemente libera o lock antes de entrar em outra camada.
Exemplo: kthread_join desacopla a stack do slot sob g_slot_lock, libera o lock e só então chama kfree.
Isso reduz nesting de locks.
Inicialização e publicação
Mesmo que um objeto estático comece zerado, o código chama spin_init explicitamente.
Isso comunica quando o lock e o estado protegido passaram a ser válidos.
Workers não devem observar estrutura parcialmente inicializada só porque locked já é zero.
Inicialização do lock e publicação do subsistema são conceitos separados.
Error paths
Todo return/panic dentro de região crítica precisa ser auditado.
heap.c, por exemplo, libera heap_lock antes de chamar panic em erros descobertos depois da aquisição.
Perder um unlock em um caminho raro deixa o subsistema permanentemente bloqueado.
Seções críticas pequenas tornam essa análise mais simples.
Performance
Acquire sem contenção custa essencialmente a operação atômica e a seção crítica.
Sob contenção, waiters executam CAS falhos repetidos separados por PAUSE.
Operações atômicas de escrita sobre a mesma cache line geram tráfego de coerência.
O Spinlock atual não implementa test-and-test-and-set, backoff ou fila.
Por isso custo de contenção tende a crescer rapidamente com mais CPUs.
False sharing
Spinlock contém um uint32_t.
Não há alinhamento para cache line.
Se o lock compartilhar uma cache line com dados frequentemente modificados, o tráfego de coerência pode incluir objetos não relacionados.
Múltiplos locks próximos também podem false-share.
O projeto não possui hoje um tipo de lock padded para cache line.
Evidência de validação
Não existe um único unit test dedicado exclusivamente a spin_lock, mas vários testes exercitam usuários reais:
- tools/test_pmm_heap_smp usa quatro host threads contra PMM e heap;
- smp_job_selftest exercita concorrência na fila global;
- tools/test_job_saturate valida full/drain/reuse;
- tools/test_kthread_smp cobre operações de kthread em SMP simulado;
- runtime TLB depende de serialização por CAS e loops com polling.
Esses testes fornecem evidência prática de integração.
Um teste futuro dedicado poderia fazer incremento protegido massivo, fairness/stress e nesting de IF separadamente.
Limitações atuais
Spinlock genérico não possui:
- owner tracking;
- recursão;
- trylock;
- timeout;
- fairness;
- wait queue;
- backoff;
- sleep;
- lockdep;
- cacheline padding;
- variante spin_lock_irqsave integrada;
- metadata de debug com local de aquisição.
A simplicidade desloca responsabilidade para os contratos de cada subsistema.
Disciplina recomendada para o ChrisOS atual
Para cada objeto compartilhado, a documentação deve responder:
- Qual lock protege o objeto?
- IRQ pode acessá-lo?
- Se sim, onde IF é desabilitado?
- O holder chama outro subsistema?
- Qual ordem de locks é criada?
- O holder espera por trabalho que precisa desse mesmo lock?
- O objeto continua vivo após unlock?
- Error paths liberam corretamente?
- O tempo de contenção é curto?
Esse conjunto descreve sincronização real melhor que apenas verificar se há um spinlock no código.
Fronteira de revisão
Este capítulo foi reconciliado com ChrisOS main na revisão e05a17fd76333114a3fb5c2452f38ca747d4ac56.
O modelo atual é:
CAS atômico -> exclusão mútua por busy-wait
PAUSE       -> hint para o spin loop
irq_save    -> exclusão opcional de IRQ na CPU local
lock order  -> prevenção de deadlock entre subsistemas
loops CAS customizados -> liveness quando spin_lock genérico é insuficiente
lifetime    -> problema separado de exclusão mútua
Preemption, lockdep, locks enfileirados, allocators por CPU ou mutexes scheduler-backed exigirão extensão desse modelo.