
Espaços de endereçamento de processos e layout de memória virtual
Sobre este capítulo Frames e tradução de endereços
Neste capítulo
- Espaços de endereçamento de processos e layout de memória virtual
- Escopo
- Tabela de processos e identidade do address space
- Inicialização do processo kernel
- Criação da PML4 de processo
- Consequências do compartilhamento do upper half
- Regra geral do lower half
- Regiões virtuais nomeadas
- Janela de executável ELF
- Materialização de páginas ELF
- Overlap de segmentos e ownership por página
- Ordem da construção do executável
- Janela aceita por user-copy é diferente do address space
- Região VM para runtimes
- Heap
- Framebuffer do processo
- Stack e divergência atual de ABI
- Base de bibliotecas
- Entrada em user mode
- Troca de address space
- Ledger de ownership das páginas
- Teardown do address space
- Implicações para shared memory
- Política de permissões por origem do mapping
- Ausência de ASLR
- Ausência de fork e copy-on-write
- Concorrência e ownership de CPU
- Limites de capacidade
- Falhas de construção
- Complexidade
- Evidência de validação
- Limitações atuais
- Fronteira de revisão
Escopo
Um address space é o contexto de tradução que define quais endereços virtuais fazem sentido para um processo em execução, quais frames físicas eles alcançam e quais permissões se aplicam.
No ChrisOS, cada processo possui atualmente um CR3 próprio apontando para uma PML4 privada. A metade canônica inferior começa privada e vazia, exceto pelos mappings criados especificamente para aquele processo. A metade superior reutiliza as entradas PML4 já existentes do kernel.
Esse é um modelo compacto de memória de processos, e não um subsistema genérico de virtual memory areas. As regiões são representadas principalmente por constantes fixas e campos de Proc, em vez de descritores VMA alocados dinamicamente.
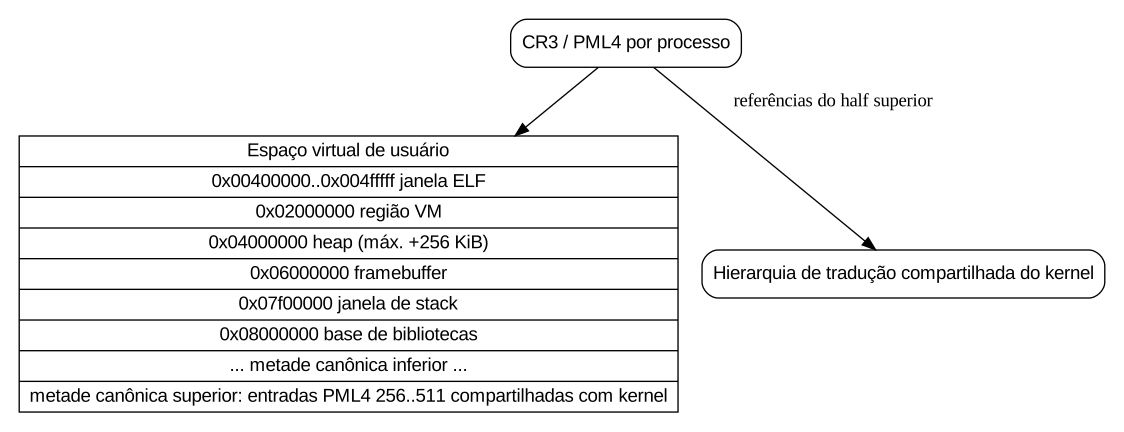
Tabela de processos e identidade do address space
O subsistema mantém um array global fixo:
O PID 0 é reservado ao kernel.
Cada Proc contém atualmente:
- used;
- alive;
- estado de scheduler;
- endereço físico do CR3;
- tamanho lógico da região VM;
- heap break;
- quantidade de páginas possuídas;
- quantidade de páginas de framebuffer;
- nome curto;
- array de pares página virtual/frame física.
O CR3 é a identidade arquitetural do contexto de tradução do processo.
Proc.pages não é a page table. É um ledger de ownership usado para lembrar quais frames folha precisam voltar ao PMM quando o processo termina.
A separação é essencial:
CR3/page tables -> para onde cada endereço virtual traduz
Proc.pages       -> quais frames folha pertencem ao processo
Inicialização do processo kernel
proc_init limpa todos os slots e inicializa o PID 0 como processo kernel.
Seu CR3 é obtido por mm_kernel_cr3, que representa a raiz adotada por mm_init a partir da hierarquia ativa criada durante o boot.
O subsistema de processos não cria um segundo address space do kernel.
PID 0 nomeia o contexto de tradução já ativo.
g_current começa em PROC_KERNEL.
Criação da PML4 de processo
proc_create percorre os PIDs 1..PROC_MAX-1 procurando um slot livre.
Ao encontrar um slot, chama mm_clone_kernel_space.
Essa função:
- aloca uma nova página PML4;
- zera suas entradas;
- obtém a PML4 atual do kernel via HHDM;
- copia as entradas 256..511;
- mantém as entradas 0..255 zeradas.
O resultado estrutural é:
| Faixa PML4 | Estado no novo processo |
|---|---|
| 0..255 | privada e inicialmente vazia |
| 256..511 | referências copiadas da hierarquia do kernel |
As entradas superiores não são deep copies. Elas continuam apontando para as mesmas estruturas inferiores do kernel.
O processo recebe, portanto, user half independente e kernel half compartilhado.
Consequências do compartilhamento do upper half
Compartilhar o kernel half evita duplicação de page tables do kernel para cada processo.
Isso permite que, após uma transição user -> kernel, o código e os dados essenciais do kernel permaneçam acessíveis no mesmo CR3 do processo.
Também mantém endereços virtuais do kernel estáveis entre trocas de processo.
A consequência de lifetime é igualmente importante: o teardown de processo nunca pode liberar recursivamente as tabelas do upper half.
mm_free_user_space percorre somente as entradas 0..255 da PML4 e depois libera a própria PML4 do processo.
Uma mutação de mapping compartilhado do kernel também possui implicações de TLB mais amplas, porque múltiplos CR3s podem referenciar as mesmas tabelas inferiores.
Regra geral do lower half
proc_map_user rejeita endereços virtuais maiores ou iguais a:
Essa é a fronteira da metade canônica inferior no modelo atual de quatro níveis.
Depois, a função chama mm_map_cr3 e força MM_USER nas flags.
Esse check é arquitetural e amplo. Ele não representa uma política completa de layout.
proc_map_user não impede por si só que um mapping se sobreponha a heap, VM, framebuffer, stack, janela ELF ou outra região nomeada.
Essas regras pertencem aos chamadores de nível superior.
Regiões virtuais nomeadas
proc.h e elf.c definem as principais convenções atuais:
| Região | Endereço atual | Função |
|---|---|---|
| Janela ELF | 0x00400000..0x004fffff | PT_LOAD de executáveis nativos |
| PROC_VM_VIRT | 0x02000000 | memória para CLVM/runtime |
| PROC_HEAP_VIRT | 0x04000000 | base do heap |
| PROC_FB_VIRT | 0x06000000 | framebuffer associado ao processo |
| PROC_STACK_VIRT | 0x07F00000 | janela de stack do subsistema de processos |
| PROC_LIB_VIRT | 0x08000000 | constante reservada para base de bibliotecas |
Esses endereços são convenções codificadas no source.
Ainda não há uma tabela central de regiões que valide dinamicamente todos os intervalos e não-overlaps.
Janela de executável ELF
elf.c define:
Cada segmento PT_LOAD precisa caber inteiramente nessa janela de 1 MiB depois do alinhamento em página.
O loader também exige:
- ELF64;
- little endian;
- ET_EXEC;
- arquitetura x86-64;
- versão suportada;
- no máximo 32 program headers;
- apenas PT_NULL ou PT_LOAD;
- filesz <= memsz;
- ausência de overflow aritmético;
- bytes file-backed dentro do arquivo;
- congruência entre offset de vaddr e offset de arquivo na página;
- ausência de segmento W+X;
- entry point dentro da janela;
- entry point pertencendo a um segmento executável;
- ausência de overlap entre segmentos declarados.
A janela ELF é, hoje, a região de user space com política de permissões mais explícita.
Materialização de páginas ELF
elf_map_segment transforma um segmento ELF em páginas de 4 KiB possuídas pelo processo.
Para cada página:
- aloca uma frame;
- zera os 4096 bytes;
- deriva flags da PTE a partir de PF_W e PF_X;
- chama proc_map_owned;
- copia a porção file-backed para a frame.
As permissões são:
O loader rejeita segmento com PF_W e PF_X simultaneamente.
Isso implementa W^X concreto no caminho ELF.
Zerar a frame inteira também fornece corretamente a parte BSS quando memsz > filesz.
Overlap de segmentos e ownership por página
elf_check_segment rejeita overlap entre intervalos de bytes de segmentos.
proc_map_owned também rejeita uma página virtual que já esteja registrada em Proc.pages.
O segundo check é relevante porque dois segmentos que não se sobrepõem em bytes podem ainda ocupar a mesma página física depois do page alignment.
O loader atual não combina conteúdo ou permissões desses segmentos em uma única página.
Se o segundo segmento tentar possuir uma página já registrada, o load falha e é abortado.
É uma política mais simples que a de loaders maduros que resolvem shared boundary pages entre segmentos.
Ordem da construção do executável
elf_load valida cabeçalho e segmentos antes de criar o processo.
Depois:
- guarda o PID anterior;
- cria um novo processo;
- troca para o CR3 do processo;
- mapeia cada segmento;
- configura a janela usada pelas cópias de syscall;
- devolve o entry point.
Se um mapping falhar, elf_abort destrói o processo parcial e restaura o processo anterior quando apropriado.
Isso fornece cleanup determinístico sem log transacional complexo.
Janela aceita por user-copy é diferente do address space
Uma página mapeada não é automaticamente aceita como argumento de syscall.
syscall.c mantém:
Depois de elf_load, o loader chama:
user_span_ok exige que buffers de usuário utilizados pelas cópias de syscall estejam dentro dessa faixa antes mesmo de caminhar as page tables.
Existem, portanto, duas camadas distintas:
- validade do address space: PTE e MM_USER determinam se a página existe para o processo;
- política de user-copy: g_user_map_lo/hi restringe ainda mais quais ponteiros são aceitos pelos helpers de syscall.
Na revisão atual, essa janela é estado global do syscall subsystem, não um campo por processo.
Isso se torna uma limitação importante quando processos com layouts diferentes coexistirem.
Região VM para runtimes
PROC_VM_VIRT vale 0x02000000.
proc_set_vm armazena vm_bytes, limitado a:
e comita a primeira página.
As demais são materializadas sob demanda pelo page-fault handler.
compiler/lang_pipeline.c usa proc_set_vm para associar memória virtual de runtime a processos, inclusive cenários relacionados ao CLVM.
proc_vm_ptr retorna sempre o mesmo endereço numérico.
O argumento pid não é usado na função, pois a identidade física da região depende do CR3 ativo, não do valor do ponteiro.
Esse é um exemplo direto de isolamento por memória virtual:
Heap
PROC_HEAP_VIRT vale 0x04000000.
Cada processo começa com:
proc_sbrk avança o break e devolve o valor antigo.
O limite atual é:
proc_sbrk não aloca frames.
A materialização física ocorre depois, em page fault, quando o processo toca uma página abaixo de heap_brk.
Ainda não existem shrink, free-region tree, mmap allocator ou metadados de alocação nesse nível.
Framebuffer do processo
PROC_FB_VIRT vale 0x06000000.
proc_fb_ptr aceita entre 1 e 16 páginas, registra fb_pages e comita cada página solicitada.
A função devolve a base virtual fixa.
Essas páginas são RAM comum possuída pelo processo e associada a uma interface de framebuffer.
Não são o mesmo mecanismo do mapping físico do framebuffer de boot realizado pelo subsistema MM.
O page-fault handler também reconhece o intervalo declarado do framebuffer.
Stack e divergência atual de ABI
PROC_STACK_VIRT vale 0x07F00000.
proc_create comita imediatamente uma página nesse endereço.
proc_fault_demand aceita uma janela de quatro páginas iniciada nessa base.
Isso sugere uma região pretendida de stack de processo.
Entretanto, o caminho runelf atual no shell executa:
portanto o RSP inicial fica dentro da janela ELF, e não em PROC_STACK_VIRT.
Existem, assim, duas convenções atuais:
- o subsistema genérico de processos provisiona stack perto de 0x07F00000;
- o launcher ELF do shell entra em user mode com stack em aproximadamente 0x00400FF8.
Essas duas convenções não devem ser documentadas como se fossem uma única ABI estabilizada.
PROC_STACK_VIRT é um mecanismo real, mas ainda não é a posição universal de stack inicial.
Base de bibliotecas
PROC_LIB_VIRT é definido como 0x08000000.
O código central de proc.c não implementa ainda um gerenciador genérico de bibliotecas dinâmicas baseado nessa constante.
Assim, o símbolo representa uma convenção/reserva de endereço, e não prova da existência de dynamic linker, shared-library VMAs ou relocations completas.
Entrada em user mode
enter_user recebe RIP e RSP.
A função prepara:
- GDT_USER_CODE com RPL 3;
- GDT_USER_DATA com RPL 3;
- RFLAGS = 0x202;
- kernel return RIP.
Depois monta um frame e executa IRETQ.
Troca de privilege level e troca de address space são operações distintas.
O chamador precisa selecionar o CR3 correto antes de enter_user.
elf_load faz isso por meio de proc_switch(pid).
A execução de usuário combina dois contextos:
Troca de address space
proc_switch possui uma invariante explícita: a troca de processos de usuário ocorre somente no CPU 0.
Se smp_current_cpu() != 0, a função entra em panic.
Para PID válido:
- lê o CR3 do processo;
- atualiza g_current;
- chama mm_switch.
mm_switch escreve CR3.
No design atual sem PCID, isso também tem consequência de TLB local.
O mesmo user address space, portanto, não é atualmente agendado simultaneamente em vários CPUs.
Ledger de ownership das páginas
Proc.pages possui capacidade fixa:
Cada entrada contém:
proc_map_owned verifica se a página virtual já existe no ledger e se ainda há capacidade.
Somente depois cria o mapping e registra ownership.
proc_commit aloca a frame internamente e preserva a mesma invariante.
A busca é linear O(n), com n <= 288.
Não há radix tree, árvore balanceada, reverse map ou objeto compartilhado com reference counting.
Teardown do address space
proc_destroy troca primeiro para o kernel se o processo alvo for o atual.
proc_release_user percorre Proc.pages.
Para cada frame:
- remove a PTE folha;
- devolve a frame ao PMM;
- limpa a entrada de ownership.
Depois mm_free_user_space libera recursivamente as estruturas do lower half e, ao final, a PML4 do processo.
As estruturas compartilhadas do kernel permanecem vivas.
O teardown também fecha arquivos e sockets associados ao processo.
O modelo atual pressupõe ownership exclusivo em vez de compartilhamento com contagem de referências.
Implicações para shared memory
O ledger atual pressupõe que as frames registradas pertencem ao processo.
Não existe objeto genérico de memória compartilhada com reference count.
Mapear manualmente a mesma frame em múltiplos processos exigiria uma política de ownership externa.
Caso contrário, o teardown de um processo poderia devolver ao PMM uma frame ainda referenciada por outro.
Portanto, shared memory arbitrária entre processos não é uma feature geral implementada nessa revisão.
Política de permissões por origem do mapping
As permissões dependem do produtor do mapping.
ELF
ELF pode criar páginas:
- read/execute;
- read/write/NX;
- read-only/NX conforme flags.
W+X é rejeitado.
Demand allocation
proc_commit cria:
sem adicionar NX.
Kernel e MMIO
Usam APIs e flags próprias.
Não há um VMA descriptor unificado que armazene permissões desejadas de todas as regiões.
Essa fragmentação é uma característica do estágio experimental atual.
Ausência de ASLR
Os executáveis nativos são ET_EXEC e precisam caber em 0x400000..0x500000.
Não há randomização do layout nesse caminho.
Também não há:
- PIE relocation;
- randomized stack;
- randomized mmap base;
- per-process layout seed;
- dynamic linker geral.
Endereços fixos favorecem determinismo e debugging, mas reduzem flexibilidade e hardening.
Ausência de fork e copy-on-write
proc_create cria um lower half vazio e copia apenas o upper half do kernel.
Ele não clona mappings de outro processo.
Não existem:
- fork-style duplication;
- COW PTE state;
- frames compartilhadas com reference count;
- write-fault path que faça duplicação de frame.
Cada processo nasce com user half limpo e é populado explicitamente pelo loader ou runtime.
Concorrência e ownership de CPU
A tabela de processos é global.
A regra BSP-only evita hoje vários problemas:
- atualizações concorrentes de g_current;
- mesmo CR3 de usuário ativo em CPUs diferentes;
- membership de shootdown por address space;
- migração de processos;
- mutação concorrente de Proc.pages.
É uma simplificação atual, não um scheduler SMP completo.
Os mappings de kernel continuam exigindo coerência multiprocessada porque são compartilhados.
Limites de capacidade
Diversos limites fixos definem o espaço prático:
| Limite | Valor/efeito |
|---|---|
| slots de processo | 32 incluindo kernel |
| páginas possuídas | 288 por processo |
| heap | crescimento lógico de 256 KiB |
| framebuffer | 16 páginas |
| janela de stack demand | 4 páginas |
| janela ELF | 1 MiB |
| tamanho VM | limitado a 288 páginas por proc_set_vm |
Esses limites interagem.
Páginas ELF, VM, heap, framebuffer e stack consomem o mesmo array Proc.pages.
Logo, os máximos regionais não podem necessariamente ser atingidos ao mesmo tempo.
O verdadeiro bound agregado é o ledger de 288 páginas.
Falhas de construção
A criação do address space pode falhar por:
- ausência de slot;
- falha ao alocar PML4;
- falha no commit inicial da stack;
- ELF inválido;
- falha de PMM durante load;
- falha na criação de page table;
- esgotamento de Proc.pages;
- tentativa de possuir uma página já existente.
proc_create destrói o processo parcial se o commit inicial falhar.
elf_load usa elf_abort para desfazer um load parcial e restaurar o processo anterior.
Esse modelo oferece cleanup simples e determinístico.
Complexidade
| Operação | Custo atual |
|---|---|
| encontrar slot de processo | O(PROC_MAX) |
| clonar upper half da PML4 | O(256) |
| procurar página possuída | O(n), n <= 288 |
| adicionar mapping | O(n) + walk de profundidade fixa |
| trocar address space | O(1) em software + custo arquitetural de CR3/TLB |
| liberar folhas possuídas | O(n) |
| liberar page tables de usuário | proporcional à árvore presente |
| detectar overlaps ELF | O(s²), s <= 32 |
Os limites são pequenos porque o design privilegia estruturas fixas e previsíveis.
Evidência de validação
O loader ELF possui testes host orientados a imagens malformadas/fuzzing.
Os gates da documentação verificam contratos de MMU, e os self-tests de MM cobrem mapping básico.
As principais invariantes source-backed são:
- divisão upper/lower half;
- switching apenas no BSP;
- bases virtuais fixas;
- W^X do loader ELF;
- entry dentro de segmento executable;
- teardown por ownership.
Ainda são úteis testes runtime adicionais para:
- isolamento entre múltiplos processos;
- tentativas explícitas de alias cross-process;
- ABI completa de stack;
- protection faults em cada classe de mapping;
- futuro switching SMP caso a regra BSP-only seja removida.
Limitações atuais
O subsistema ainda não possui:
- VMAs dinâmicas;
- mmap/munmap genérico;
- ASLR;
- PIE;
- fork;
- copy-on-write;
- shared memory genérica;
- reference counting de frames mapeadas;
- janela de user-copy por processo;
- ABI única de stack entre launchers;
- guard pages gerenciadas;
- mprotect-like transitions;
- scheduling de user process em múltiplos CPUs;
- gerenciador de bibliotecas em PROC_LIB_VIRT;
- estrutura escalável de ownership.
Esses são limites da implementação atual, não limitações da arquitetura.
Fronteira de revisão
Este capítulo foi reconciliado com ChrisOS main na revisão e05a17fd76333114a3fb5c2452f38ca747d4ac56.
Ele descreve o layout fixo, construção de CR3 por processo, janela ELF, regiões de demanda, ledger de ownership, janela de user-copy, divergência atual de stack, switching e teardown presentes nos arquivos declarados.
Um VMA manager futuro, redesign de scheduler, dynamic linker, shared-memory layer ou mudança de ABI de usuário exige nova revisão source-level.