
Page faults: semântica arquitetural e caminhos de recuperação no ChrisOS
Sobre este capítulo Frames e tradução de endereços
Neste capítulo
- Page faults: semântica arquitetural e caminhos de recuperação no ChrisOS
- Escopo
- Entradas arquiteturais do handler
- Normalização do frame de exceção
- Primeira decisão: tentar alocação sob demanda
- Regiões elegíveis para demanda
- O que proc_commit realmente executa
- Semântica de retry
- Limitação importante: causa do error code não governa recuperação
- User fault não recuperável
- Destruição do processo durante o fault
- Retorno ao kernel depois de user fault
- Kernel fault não recuperável
- Fronteira de contenção
- Falta de memória durante page fault
- Capacidade fixa de ownership
- Concorrência
- Propriedades de segurança implementadas
- Propriedades ainda ausentes no caminho de demanda
- Complexidade
- Evidência de validação
- Limitações atuais
- Fronteira de revisão
Escopo
Page fault é a exceção x86-64 gerada quando um acesso à memória linear não pode ser concluído pelas regras de paginação vigentes. Ela não significa simplesmente “página ausente”. O processador pode gerar o vetor 14 porque uma tradução não está presente, porque uma escrita viola proteção, porque user mode tenta acessar memória supervisor, porque existe codificação reservada inválida em uma estrutura de paging ou porque um fetch de instrução conflita com permissões de execução.
O ChrisOS usa page faults atualmente para dois propósitos distintos:
- alocação sob demanda recuperável em um pequeno conjunto de regiões virtuais pertencentes ao processo;
- contenção de falha quando um acesso de usuário não pode ser recuperado.
Um page fault em contexto de kernel que não seja consumido pelo caminho de demanda permanece fatal e chega ao tratamento genérico de exceção.
A implementação atual é propositalmente compacta. Ela não contém gerenciador genérico de VMAs, copy-on-write, swap, paging de arquivo ou política universal de recuperação de protection faults.
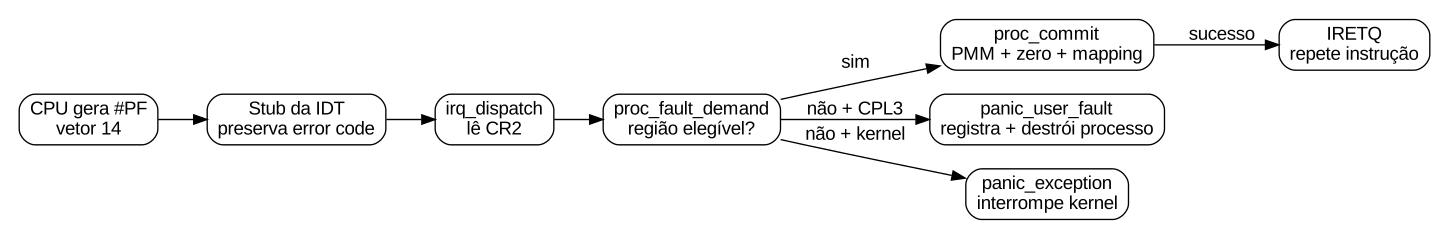
Entradas arquiteturais do handler
Três conjuntos de estado são especialmente importantes.
Vetor
O vetor arquitetural é 14.
Durante idt_init, o ChrisOS instala gates para os vetores e o vetor 14 aponta para isr14 da tabela de stubs.
CR2
Quando o processador gera #PF, CR2 contém o endereço linear cujo acesso causou a falha.
irq_dispatch lê CR2 explicitamente antes de tentar recuperação:
CR2 responde onde o acesso falhou. Ele não determina sozinho a causa.
Error code
Diferentemente de exceções sem error code de hardware, #PF empilha um valor arquitetural de erro.
idt_stubs.asm classifica o vetor 14 com ISR_WITH_ERROR. Portanto, o stub não cria um zero artificial para essa exceção: o error code produzido pelo CPU permanece em irq_frame.error.
Entre os campos arquiteturais comuns estão:
| Bit | Significado convencional |
|---|---|
| 0 | 0 = tradução não presente; 1 = violação de proteção |
| 1 | 0 = acesso semelhante a leitura; 1 = escrita |
| 2 | 0 = acesso supervisor; 1 = acesso de usuário |
| 3 | violação de bit reservado em estrutura de paging |
| 4 | fetch de instrução quando suportado/reportado |
| bits superiores | extensões dependentes das capacidades do processador |
O significado exato de alguns bits superiores depende das features do CPU.
O ChrisOS atual não decodifica esses bits para decidir a política de recuperação. O valor é preservado no frame e impresso no diagnóstico de user fault, mas proc_fault_demand decide com base no estado do processo e no endereço CR2.
A política atual é, portanto, orientada principalmente pelo endereço e não pela causa codificada no error code.
Normalização do frame de exceção
A camada assembly normaliza exceções para que irq_dispatch receba uma estrutura irq_frame comum.
Para vetores sem error code de hardware, ISR_NO_ERROR empilha um zero sintético e depois o número do vetor.
Para o vetor 14, ISR_WITH_ERROR empilha apenas o número do vetor, pois o processador já colocou o error code na pilha.
Depois que os registradores gerais são empilhados, a visão usada pelo C contém:
Quando a exceção cruza níveis de privilégio, x86-64 também salva o estado de stack necessário para IRETQ. Esses campos adicionais de transição de privilégio não aparecem explicitamente como membros de irq_frame no código atual. O stub assembly continua possuindo o frame completo da máquina e executa IRETQ no final.
Isso é uma fronteira importante: irq_frame é uma visão C conveniente sobre parte do estado de retorno, não uma serialização independente de todas as variantes possíveis do frame arquitetural.
Primeira decisão: tentar alocação sob demanda
irq_dispatch oferece a proc_fault_demand a primeira chance de resolver todo vetor 14.
O código atual não testa primeiro o error code para verificar se a causa foi “not present”, nem restringe essa primeira tentativa explicitamente a faults originados em user mode.
Na prática, a recuperação funciona quando:
- o PID atual representa um processo válido diferente do kernel;
- o processo existe e ainda está marcado como alive;
- CR2 cai em uma das regiões reconhecidas por proc_fault_demand;
- proc_commit consegue materializar a página.
Se proc_fault_demand retorna verdadeiro, irq_dispatch retorna imediatamente. O stub restaura o estado e IRETQ volta à execução.
Assim, o page-fault handler faz parte direta do mecanismo de alocação de memória do processo.
Regiões elegíveis para demanda
proc_fault_demand alinha CR2 para baixo em 4 KiB e testa quatro classes de região.
Região VM
A região VM começa em PROC_VM_VIRT, atualmente 0x02000000.
proc_set_vm registra vm_bytes e comita a primeira página imediatamente. Faults posteriores no intervalo:
podem alocar novas páginas sob demanda.
Esse caminho é usado pela infraestrutura de linguagem/VM como uma arena de memória limitada por processo.
Janela de stack
O subsistema de processo reconhece:
com PROC_STACK_VIRT atualmente em 0x07F00000.
proc_create comita a primeira página nesse endereço.
Essa é uma janela fixa de quatro páginas. Não existe ainda stack dinamicamente expansível com guard page móvel ou política arbitrária de tamanho máximo.
Existe também um detalhe importante: o caminho atual runelf do shell chama enter_user com RSP igual a 0x400FF8, e não com PROC_STACK_VIRT. Portanto, a janela definida no processo ainda não é uma ABI universal de stack para todos os executáveis de usuário. O capítulo de address spaces trata essa divergência com mais detalhes.
Região de heap
O heap começa em PROC_HEAP_VIRT, atualmente 0x04000000.
proc_sbrk avança heap_brk, limitado atualmente a 256 KiB acima da base. A função não materializa frames físicas por si só.
Um fault é elegível quando:
Assim, o limite lógico pode avançar primeiro e as páginas físicas aparecem posteriormente quando são tocadas.
Região de framebuffer do processo
PROC_FB_VIRT vale atualmente 0x06000000.
proc_fb_ptr registra quantas páginas de framebuffer pertencem ao processo, com limite de 16 páginas, e tenta comitá-las de forma eager.
Mesmo assim, proc_fault_demand também reconhece o intervalo registrado. Isso permite recuperar uma página ausente dentro da faixa declarada, embora o caminho normal já tente materializá-la antecipadamente.
O que proc_commit realmente executa
Resolver o fault não é apenas escrever uma PTE.
proc_commit executa uma transação de ownership entre PMM, MM e a tabela do processo:
- valida PID e estado do processo;
- alinha o endereço virtual em 4 KiB;
- retorna sucesso se a página já estiver registrada;
- verifica a capacidade fixa de Proc.pages;
- aloca uma frame física via PMM;
- obtém seu alias HHDM;
- zera os 4096 bytes da frame;
- instala mapping user/writable através de proc_map_user e mm_map_cr3;
- se o mapping falhar, devolve a frame ao PMM;
- se funcionar, grava o par virtual/físico em Proc.pages;
- se o processo for o atual, recarrega CR3 por mm_flush_tlb.
O zero-fill impede que uma página entregue ao user space exponha dados residuais de uma frame física reciclada.
O caminho de demanda usa MM_PRESENT | MM_WRITE, e proc_map_user adiciona MM_USER.
Ele não adiciona MM_NX. Portanto, as páginas demand-allocated de VM, heap, stack e framebuffer não são atualmente expressas como não executáveis nesse caminho.
Essa é uma limitação de segurança real da implementação presente. Ela difere do loader ELF, que deriva WRITE/NX das flags do segmento e rejeita segmentos simultaneamente writable e executable.
Semântica de retry
Quando um fault é resolvido com sucesso, a execução retorna normalmente para o mesmo RIP.
O handler não incrementa RIP após proc_fault_demand.
Isso é correto para uma página ausente: a instrução que falhou ainda não concluiu sua operação de memória e precisa ser repetida depois que a tradução existe.
Esse comportamento contrasta com alguns caminhos de syscall em syscall_dispatch, nos quais frame->rip é avançado explicitamente após a operação baseada em INT.
Limitação importante: causa do error code não governa recuperação
proc_fault_demand considera CR2 e membership da região, mas não interpreta frame->error antes de tentar commit.
Portanto, um fault dentro de uma região elegível pode chegar a proc_commit independentemente de o error code indicar not-present ou protection violation.
Se a página já constar em Proc.pages, proc_commit retorna sucesso imediatamente.
Assim, o fluxo atual não separa explicitamente na primeira decisão:
O caso esperado para demand allocation é uma página não presente, mas a política implementada é mais ampla.
Uma versão futura mais rigorosa normalmente verificaria frame->error antes de decidir materializar memória e separaria faults de write, user/supervisor, NX, reserved bit ou outras causas.
A documentação registra o código atual, sem atribuir ao sistema uma política mais forte que ainda não existe.
User fault não recuperável
Se o caminho de demanda não resolve a exceção, irq_dispatch examina o nível de privilégio salvo em CS:
indica contexto de retorno com RPL não zero, usado pelo caminho atual de user mode.
panic_user_fault então contém a falha em vez de interromper todo o sistema.
A sequência é:
- obtém proc_current();
- registra PID, CR2 e RIP no único ProcFault global;
- marca o processo como não alive;
- destrói o processo quando PID > 0;
- registra RIP, CR2, error code, CPU e identidade do build;
- define exit code -11;
- reescreve o frame de retorno para o ponto de retorno do kernel previamente salvo.
O nome panic_user_fault não significa que a função chama panic() para processos de usuário. Nesse caso, ela realiza contenção e retorno ao kernel.
Destruição do processo durante o fault
proc_destroy troca para PROC_KERNEL primeiro se o PID que está morrendo for o processo corrente.
Em seguida:
- limpa e libera páginas de usuário possuídas;
- destrói a hierarquia de page tables do half de usuário;
- fecha arquivos associados ao processo;
- fecha sockets do processo;
- marca o slot como livre.
A ordem é importante. Frames folha de dados são liberadas via Proc.pages antes que mm_free_user_space elimine as páginas intermediárias de page table.
Como proc_switch(PROC_KERNEL) escreve o CR3 do kernel antes da destruição da PML4 do processo, o CPU atual deixa de depender daquela hierarquia como contexto de tradução ativo.
Processos de usuário atualmente só executam no BSP, o que simplifica o lifetime de TLB de address spaces privados.
Retorno ao kernel depois de user fault
enter_user registra um RIP de retorno do kernel antes de mudar para ring 3.
panic_user_fault termina chamando syscall_return_to_kernel, que modifica o frame salvo:
- RIP passa a g_user_kernel_rip;
- CS passa ao seletor de código do kernel;
- RFLAGS passa a 0x202;
- g_user_exited é marcado.
O stub executa IRETQ depois.
O tipo irq_frame atual expõe RIP, CS e RFLAGS, mas não declara RSP/SS de transição de privilégio como membros nomeados. Esse mecanismo de retorno depende, portanto, da disposição real do stack frame produzido pelo hardware e pelo stub.
Qualquer mudança futura em exception frames, IST ou convenção de retorno de user mode precisa revisar essa dependência como se fosse uma ABI interna.
Kernel fault não recuperável
Se a demanda falha e CS indica privilégio de kernel, irq_dispatch cai no caminho genérico de exceção.
Para vetores abaixo de 32, panic_exception imprime:
- vector;
- error code;
- RIP;
- CR2;
- CPU;
- CR3;
- RSP;
- identidade de build/source.
Depois desabilita interrupções e executa HLT indefinidamente.
Não há atualmente tabela de fixup de page fault do kernel, mecanismo semelhante a exception tables, trampoline para copy-from-user ou recuperação por thread.
Por isso user_copy evita dereferenciar diretamente ponteiros de usuário em ring 0. A função caminha as page tables com mm_translate e copia usando aliases HHDM. Uma página ausente retorna erro em vez de provocar intencionalmente um kernel #PF.
Fronteira de contenção
O modelo atual pode ser resumido assim:
| Classe de fault | Resultado atual |
|---|---|
| Acesso em região de demanda e commit funciona | mapear página e repetir instrução |
| Região elegível, mas commit falha | seguir para falha de usuário/kernel |
| User fault fora do caminho recuperável | registrar, destruir processo, retornar ao kernel |
| Kernel fault fora do caminho recuperável | panic global e halt |
O sistema ainda não entrega sinais, core dumps, política de restart, pagers de userspace ou callbacks específicos por tipo de processo.
Falta de memória durante page fault
proc_commit pode falhar porque:
- Proc.pages atingiu sua capacidade;
- PMM não consegue fornecer frame;
- mm_map_cr3 não consegue construir a estrutura de page tables.
proc_fault_demand converte qualquer uma dessas falhas em “não tratado”.
Em user mode, isso resulta na terminação do processo.
Não há OOM killer, reclaim, swap, fila de retry ou distinção entre falha transitória e permanente.
Capacidade fixa de ownership
PROC_PAGES vale atualmente 288.
O array grava cada página possuída como:
Esse limite afeta diretamente o page-fault handler. Mesmo que o PMM tenha memória disponível, um processo cujo array esteja cheio não pode comitar nova página.
proc_set_vm também limita vm_bytes a PROC_PAGES * 4096, mas ELF, framebuffer, heap e outras páginas possuídas usam o mesmo array. Assim, a capacidade prática total é compartilhada entre classes de mapping do processo.
É uma limitação de escalabilidade, mas torna teardown e busca de ownership simples e determinísticos.
Concorrência
O estado de processo é global e processos de usuário executam somente no BSP.
proc_switch entra em panic se usado por um AP.
Assim, um address space privado de user process não é esperado simultaneamente em múltiplos CPUs.
As mutações de page table continuam protegidas por mm_lock, e proc_commit recarrega CR3 quando altera o processo corrente. Traduções compartilhadas de kernel permanecem um problema multiprocessado tratado pelo protocolo de TLB.
O page-fault handler roda em contexto de exceção. Ele não pode pressupor que primitivas comuns de bloqueio ou espera de scheduler sejam seguras.
Propriedades de segurança implementadas
Existem proteções concretas:
- páginas de usuário possuem MM_USER;
- mappings ELF derivam escrita e execução de PT_LOAD;
- ELF rejeita segmentos W+X;
- páginas de demanda são zeradas antes de exposição;
- user_copy exige mapping presente e user;
- escrita via user_copy exige MM_WRITE;
- faults de usuário não recuperáveis são contidos no processo em vez de derrubarem automaticamente o kernel.
Essas garantias são menores que as de um VM subsystem de produção, mas estão presentes no código.
Propriedades ainda ausentes no caminho de demanda
As páginas de demanda são atualmente graváveis e não recebem MM_NX.
A política não decodifica o error code antes de tentar recuperação.
Também não existem objetos de guard page, política de stack executável, descritores de permissão por região, copy-on-write, tracking de dirty state ou mudanças de proteção semelhantes a mprotect.
Um modelo futuro baseado em descritores de regiões poderia associar cada intervalo a tipos permitidos de fault e flags exatas da folha, em vez de depender de comparações hard-coded de endereço.
Complexidade
A classificação em proc_fault_demand é O(1), pois contém quatro checks de intervalo fixos.
page_owned e proc_commit fazem busca O(n) no array Proc.pages.
Com n limitado a 288, o custo possui teto pequeno e previsível.
A criação de mapping percorre quatro níveis fixos, portanto é O(1) em relação ao tamanho do address space.
Zerar uma frame custa 4096 stores de byte na implementação atual. Sob tamanho fixo de página, isso é assintoticamente constante, mas é um custo material maior que os checks de metadados.
Evidência de validação
O repositório possui gates de documentação e verificações de MMU, além de testes de mapping em MM.
A estrutura do page-fault path pode ser validada diretamente por:
- classificação do vetor 14 como exceção com hardware error code;
- captura de CR2 em irq_dispatch;
- lógica de commit sob demanda;
- registro de ProcFault;
- teardown de processo de usuário.
A aprovação do build de documentação, contudo, não demonstra todas as combinações runtime de #PF.
Ainda faltam ou não são exaustivos testes para:
- todas as combinações do architectural error code;
- faults NX em cada região;
- write fault em segmento ELF read-only;
- reserved-bit fault;
- OOM em cada etapa de criação de tabela;
- nested page fault dentro do próprio handler;
- validação completa do retorno depois da destruição de processo.
Esses são alvos úteis para gates runtime futuros.
Limitações atuais
Na revisão analisada, o subsistema não fornece:
- árvore/mapa de VMAs;
- política dirigida pelo error code;
- copy-on-write;
- page-in de arquivo;
- swap;
- page replacement;
- entrega de exceção ao processo;
- signals;
- pager em userspace;
- movimentação de guard page de stack;
- kernel exception fixups;
- recuperação de OOM;
- política genérica NX/W^X para páginas de demanda.
O design atual é um mecanismo experimental compacto que conecta diretamente exceções do processador a um modelo pequeno de memória de processos.
Fronteira de revisão
Este capítulo foi reconciliado com ChrisOS main na revisão e05a17fd76333114a3fb5c2452f38ca747d4ac56.
Os fatos atuais são o comportamento do stub do vetor 14, leitura de CR2, política de regiões fixas, proc_commit, contenção de user fault, destruição do processo e fallback fatal do kernel presentes nos arquivos declarados.
Planos futuros para paginação ou isolamento mais ricos devem permanecer separados até que existam no código.