
Translation Lookaside Buffer: cache de tradução, invalidação e ChrisOS
Sobre este capítulo Frames e tradução de endereços
Neste capítulo
- Translation Lookaside Buffer: cache de tradução, invalidação e ChrisOS
- Escopo
- O trabalho evitado pela TLB
- Estado de TLB não é a page table
- Invalidação local com INVLPG
- Invalidação de intervalo
- CR3 como contexto de tradução
- Por que existem map_4k e map_4k_nosync
- Instalação de mapping anteriormente ausente
- Unmap é mais perigoso que map
- Lifecycle do JIT como estudo de caso
- Mappings privados de processo
- Mappings compartilhados do kernel
- Poll de TLB dentro da espera por locks
- IPI para acelerar invalidação
- Shootdown de zero bytes não equivale a full flush
- Invalidação local versus shootdown remoto
- Permissões também fazem parte da tradução
- Page size e granularidade
- Modelo de performance
- Falhas típicas
- Evidência de validação
- Limitações atuais
- Referências arquiteturais e fronteira de revisão
Escopo
A page table é a estrutura autoritativa de tradução em memória, mas o processador não executa um walk completo de quatro níveis para cada load, store e fetch de instrução. Resultados recentes de tradução são mantidos em estruturas internas do processador, normalmente discutidas por meio do conceito de Translation Lookaside Buffer (TLB).
A TLB faz parte do estado prático da memória virtual mesmo não aparecendo como uma estrutura C comum do kernel.
Um modelo útil é:
endereço virtual
      |
      v
 consulta ao cache de tradução
   /         \
 hit         miss
  |           |
  |      page-table walk
  |           |
  +------> endereço físico + permissões efetivas
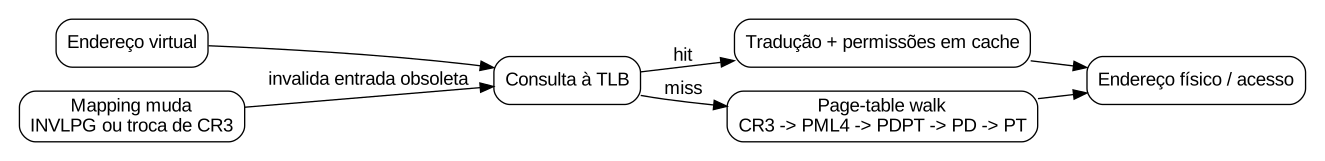
A consequência central para o sistema operacional é que alterar uma PTE na RAM não constitui, sozinho, uma atualização completa da tradução. O software precisa garantir que processadores deixem de usar estado derivado do mapping antigo quando a arquitetura e a política de reclamation exigirem.
Este capítulo trata do mecanismo local e de como ele aparece no ChrisOS atual. O protocolo multiprocessado é detalhado separadamente em TLB shootdown e reclamation.
O trabalho evitado pela TLB
Para uma página normal de 4 KiB no layout x86-64 de quatro níveis usado pelo ChrisOS, um miss de tradução pode exigir consultas a:
- PML4E;
- PDPTE;
- PDE;
- PTE final.
Esses acessos a estruturas de paging são acessos de metadados necessários apenas para descobrir onde o dado ou a instrução desejada reside.
Cachear a tradução amortiza esse custo.
Conceitualmente, uma entrada de tradução precisa conter informação suficiente para responder perguntas como:
- qual frame física corresponde à página virtual;
- a qual contexto de address space a tradução pertence;
- se o acesso é permitido para o nível de privilégio e tipo de operação;
- qual page size é representado.
A organização interna exata depende do processador. O kernel deve raciocinar a partir do contrato arquitetural de invalidação, e não assumir quantidade de entradas, associatividade, política de substituição ou hierarquia específica.
Estado de TLB não é a page table
Considere:
Uma CPU acessa V e mantém a tradução em cache.
Depois o kernel altera a page table:
A PTE em memória agora aponta para B, mas o processador pode ainda possuir estado de tradução derivado da PTE anterior até que a invalidação exigida ocorra.
Existem, portanto, dois estados:
Código correto de VM precisa sincronizar esses estados nos pontos exigidos pela arquitetura e pela política de lifetime do kernel.
O caso mais perigoso não é apenas ler dados antigos. É devolver a frame antiga ao PMM e reutilizá-la para outro objeto enquanto alguma CPU ainda consegue acessá-la por uma tradução virtual obsoleta.
Por isso coerência de TLB também é um problema de resource lifetime.
Invalidação local com INVLPG
O ChrisOS usa a instrução x86 INVLPG para invalidação local em granularidade de página.
Ela aparece em vários caminhos.
Para mapping 4 KiB de kernel, map_4k modifica a PTE e depois executa:
Ao remover mapping, unmap_4k zera a PTE sob mm_lock e invalida localmente o endereço virtual.
Para um CR3 de processo arbitrário, mm_unmap_cr3 só executa INVLPG quando o CR3 passado também é o CR3 atualmente ativo naquele CPU.
Essa distinção é essencial.
INVLPG atua na CPU que executa a instrução. Não é broadcast para os demais processadores.
Assim:
resolve apenas o estado local coberto pela operação.
Mappings de kernel compartilhados e visíveis em vários CPUs exigem um protocolo SMP antes que a memória física correspondente possa ser reutilizada com segurança.
Invalidação de intervalo
O ChrisOS implementa o helper interno mm_invlpg_span.
Ele recebe base virtual e quantidade de bytes, alinha a primeira e a última página em 4 KiB e executa um INVLPG para cada página coberta.
Para um intervalo de N páginas:
O código também protege a aritmética do intervalo contra wraparound do espaço de 64 bits.
O protocolo de shootdown publica o mesmo par base/bytes para que CPUs remotas executem a mesma invalidação página a página.
Não existe atualmente heurística que substitua muitos INVLPG por uma invalidação de contexto mais ampla acima de determinado limiar.
CR3 como contexto de tradução
CR3 seleciona a raiz da hierarquia de paging atual.
O ChrisOS troca address spaces com mm_switch:
e implementa mm_flush_tlb lendo o CR3 atual e escrevendo o mesmo valor novamente.
No nível do software essas operações são O(1), mas o custo arquitetural não equivale a um simples register move porque o contexto de tradução é afetado.
O processo atual não utiliza política PCID-aware.
Não há preservação explícita de vários contextos de processo tagueados por PCID no software. proc_switch simplesmente escreve o CR3 do processo selecionado.
É uma simplificação do design atual.
Por que existem map_4k e map_4k_nosync
As duas funções fazem a mesma mutação de page table sob mm_lock.
A diferença é a etapa final:
- map_4k instala a PTE e executa INVLPG local;
- map_4k_nosync instala a PTE sem essa invalidação.
O nome nosync não significa “seguro sem sincronização em qualquer cenário”.
Significa apenas que a função não executa o INVLPG local final.
O chamador precisa ter uma justificativa para omitir ou postergar a invalidação.
A escrita na page table continua serializada por mm_lock.
Instalação de mapping anteriormente ausente
É comum imaginar que invalidação só seja relevante ao substituir ou remover mapping presente. Hardware de tradução também mantém estado relacionado ao processo de paging, e software precisa seguir o contrato arquitetural ao tornar uma tradução anteriormente inválida em válida.
O JIT atual mostra uma política concreta do ChrisOS.
jit_seal mapeia páginas executáveis antes ausentes e usa map_4k para cada página. O comentário no source registra que a escolha foi INVLPG local, não reload global de CR3.
O raciocínio implementado é:
- a nova tradução precisa ser observável localmente no momento do seal;
- uma operação global mais ampla já causou falha severa nesse caminho;
- outra CPU que posteriormente execute o trabalho obterá a tradução dentro de seu próprio contexto.
Isso não deve ser generalizado como garantia universal para todos os futuros produtores de mappings. É o contrato do caminho atual.
Unmap é mais perigoso que map
Criar mapping e remover mapping possuem consequências de lifetime distintas.
Se uma CPU ainda não percebe um mapping novo, ela pode faultar ou continuar tratando o endereço como ausente.
Se uma CPU continua percebendo mapping já removido, ela pode acessar a frame antiga.
Se a frame já voltou ao PMM, o stale access pode atingir um objeto completamente diferente.
A ordem segura de teardown é:
remover PTE
invalidar traduções em todas as CPUs relevantes
provar que a invalidação terminou
só então reutilizar a frame física
O teardown do JIT é o exemplo atual mais direto dessa regra.
Lifecycle do JIT como estudo de caso
O JIT mantém dois aliases para a mesma alocação física contígua:
- alias HHDM gravável em buf->w;
- alias virtual alto executável em buf->x.
jit_seal cria o alias executável página a página.
jit_free:
- remove cada leaf executável com unmap_4k;
- executa mm_tlb_shootdown_range para todo o intervalo;
- devolve frames ao PMM imediatamente apenas se o shootdown provar reuse-safe;
- caso contrário, envia as frames para a quarentena de TLB.
A invariante real é:
O protocolo de TLB fecha essa diferença.
Mappings privados de processo
Mappings privados possuem modelo de concorrência mais estreito.
Processos de usuário atualmente executam apenas no BSP.
mm_unmap_cr3 remove uma leaf de um CR3 específico. O INVLPG local só ocorre se aquele CR3 também for o contexto atual.
Durante proc_destroy, se o processo destruído for o corrente, o sistema troca primeiro para o CR3 do kernel e depois libera páginas e page tables do processo.
Como o mesmo address space de usuário não é executado simultaneamente em múltiplos CPUs no design atual, teardown privado ainda não exige o mesmo modelo de shootdown por address space que seria necessário em um scheduler SMP geral.
Essa restrição faz parte do argumento de correção atual.
Se processos se tornarem migráveis ou executáveis simultaneamente em vários CPUs, será necessário rastrear residência de address spaces por CPU.
Mappings compartilhados do kernel
O upper half do kernel é compartilhado entre PML4s de processo pela cópia das entradas 256..511.
Assim, uma CPU com CR3 de processo ainda pode utilizar mappings superiores compartilhados do kernel.
A reclamation de mapping de kernel é, portanto, um problema global de coerência entre CPUs, e não simplesmente um problema do CR3 do PID 0.
O protocolo atual rastreia CPUs, não usuários individuais de cada CR3.
Isso é adequado ao caso de uso atual de kernel mappings compartilhados.
Poll de TLB dentro da espera por locks
mm_enter não usa spin_lock diretamente.
Enquanto espera por mm_lock, ele:
- chama mm_tlb_poll();
- tenta CAS no lock;
- executa pause em caso de falha.
Essa é uma propriedade de liveness.
Uma CPU esperando o lock de MM ainda precisa perceber e reconhecer uma geração de TLB pendente. Caso contrário, o initiator poderia esperar pelo ack de uma CPU que está travada girando dentro do próprio subsistema de memória.
O mesmo padrão existe ao esperar pelo serializador mm_tlb_busy.
A coerência de tradução está integrada aos loops de espera.
IPI para acelerar invalidação
Quando LAPIC está disponível, o initiator envia vetor 0xF0 às CPUs remotas participantes.
irq_dispatch trata esse vetor especificamente:
mm_tlb_poll verifica se a CPU atual ainda não viu a geração publicada. Se houver trabalho, invalida a faixa e atualiza o ack.
O IPI acelera o progresso.
Polling continua existindo em workers e wait loops, portanto o sistema não depende de um único caminho de entrega.
A máquina de estados completa é tratada no capítulo de shootdown.
Shootdown de zero bytes não equivale a full flush
A função pública mm_tlb_shootdown atualmente chama o protocolo com:
mm_invlpg_span não executa invalidação para bytes == 0.
Logo, na revisão analisada, mm_tlb_shootdown deve ser entendido como publicação/sincronização de uma geração sem payload real de intervalo, e não como um full architectural TLB flush.
A API mm_tlb_shootdown_range é a função que transporta uma faixa concreta de invalidação.
Essa diferença precisa ser explícita porque o nome da função isoladamente pode sugerir comportamento mais forte.
Invalidação local versus shootdown remoto
| Mecanismo | Escopo atual | Uso principal |
|---|---|---|
| INVLPG | CPU executora, uma página | invalidação local |
| mm_invlpg_span | CPU executora, intervalo | múltiplas páginas locais |
| mm_flush_tlb | CPU atual, CR3 atual | refresh amplo do contexto local |
| mm_switch | CPU atual | seleção de outro CR3 |
| mm_tlb_shootdown_range | CPUs participantes | reclamation de mapping compartilhado |
| mm_tlb_quarantine | lifetime físico | impedir reuse sem prova de coerência |
São mecanismos relacionados, mas não equivalentes.
Permissões também fazem parte da tradução
Uma tradução não é apenas um número de frame.
Permissões efetivas derivadas do caminho de page tables determinam se um acesso pode ocorrer.
Alterar permissões de mapping existente também pode exigir invalidação de estado antigo.
Exemplos conceituais:
- writable -> read-only;
- executable -> NX;
- user -> supervisor-only.
O ChrisOS atual possui handling explícito mais forte para remoção de mappings do que uma API geral de permission transition.
Não existe ainda subsistema semelhante a mprotect centralizando mudança de permissões e invalidação.
Uma futura API desse tipo precisa tratar a invalidação como parte da transação de segurança.
Page size e granularidade
Os mappings criados pelo ChrisOS usam folhas de 4 KiB.
O walker de software reconhece huge pages existentes de 2 MiB e 1 GiB, mas a API de mutação não cria nem divide essas folhas.
mm_invlpg_span avança em PMM_PAGE, hoje 4096 bytes.
O protocolo atual foi, portanto, construído ao redor da granularidade de 4 KiB.
Suporte geral à mutação de huge pages exigirá política explícita de split e invalidação.
Modelo de performance
Um TLB hit evita page-table walk e é um componente importante do desempenho de memória virtual.
Invalidação possui custo próprio.
Para N páginas:
Para shootdown em C CPUs, somam-se:
- publicação de estado;
- seleção de targets;
- até O(C) IPIs;
- invalidação remota;
- espera por acknowledgements.
O tempo real também depende de latência de interrupção, estado dos workers e tráfego de coerência de cache.
O ChrisOS atual privilegia correção explícita e diagnóstico em vez de heurísticas sofisticadas de batching.
Falhas típicas
Erros de TLB frequentemente passam despercebidos em testes single-core.
Classes relevantes incluem:
- alterar mapping sem invalidar tradução local obsoleta;
- liberar frame antes de peers reconhecerem a invalidação;
- assumir que IPI requisitado foi necessariamente processado;
- esperar indefinidamente por CPU que não progride;
- usar apenas cpu_online_count como se fosse membership exato;
- aplicar reload de contexto amplo em caminho runtime sensível;
- publicar faixa diferente daquela realmente desmontada.
O ChrisOS trata parte desses riscos com gerações, polling, fencing e quarentena.
Evidência de validação
O repositório possui teste host específico do protocolo em tools/test_tlb_proto.c.
MM também possui self-test de alias 4 KiB, verificando coerência entre mapping criado e alias HHDM.
O fechamento do JIT executa um fluxo runtime real:
CI também contém verificações source-bound da área de memória.
Testes futuros úteis incluem:
- stress de map/unmap repetido da mesma VA em todos os CPUs;
- downgrade de permissões;
- injeção de perda/atraso de IPI;
- invalidação de huge pages se mutação for implementada;
- migração de processo quando scheduling SMP existir;
- medição comparativa de INVLPG por faixa versus estratégias alternativas.
Limitações atuais
Na revisão analisada, o ChrisOS não possui:
- PCID-aware switching;
- INVPCID;
- heurística para substituir muitos INVLPG por invalidação mais ampla;
- tracking de CPUs residentes por address space;
- execução SMP de user processes;
- API geral de permission transition;
- política de invalidação para huge-page split/create;
- abstração TLB independente de arquitetura;
- semântica de full flush no wrapper mm_tlb_shootdown de zero bytes.
A implementação é diretamente x86-64 e usa mappings de 4 KiB, CR3, INVLPG e um protocolo global próprio de shootdown.
Referências arquiteturais e fronteira de revisão
Os conceitos arquiteturais correspondem ao comportamento de paging e translation caching descrito pelo Intel 64 and IA-32 Software Developer's Manual e pela documentação AMD64 equivalente.
As afirmações específicas do ChrisOS foram reconciliadas com a revisão main e05a17fd76333114a3fb5c2452f38ca747d4ac56.
A distinção entre INVLPG local, refresh local via CR3, shootdown por faixa, processos de usuário restritos ao BSP e quarentena de frames do JIT deriva do código declarado, e não de uma extrapolação teórica.