
Análise lexical
Sobre este capítulo Construção de compiladores
Neste capítulo
- Análise lexical
- Escopo
- Responsabilidade do lexer
- ChrisC: tokenização explícita
- Estrutura de Token
- Linha e coluna
- Classes de caracteres
- Comprimento de identifier
- Keywords
- Identifiers comuns
- Whitespace
- Comments
- Strings
- Escapes em strings
- Concatenação de strings adjacentes
- String não terminada
- Character literals
- Integers
- Sufixos de integer
- Hexadecimal inválido
- Float literals
- Operadores e maximal munch
- Pontuação
- Caractere inválido
- EOF token
- Yield cooperativo
- Diagnostics lexicais do ChrisC
- KCC: scanner sob demanda
- Preprocessing no KCC
- `skip`
- Keywords no KCC
- Operadores no KCC
- Identifiers no KCC
- Integers no KCC
- Floats no KCC
- Characters no KCC
- Strings no KCC
- Comments no KCC
- Markers de origem
- Comparação arquitetural
- Scanner do ChrisAsm
- Números no ChrisAsm
- Comments no ChrisAsm
- Scanner do CLASM
- Números no CLASM
- Comments e trailing text no CLASM
- Evidência de validação
- Lacunas de teste
- Segurança e robustez
- Complexidade
- Limitações atuais
- Fronteira de roadmap
- Mapa de source e revisão
Escopo
Análise lexical é a fronteira entre caracteres brutos do source e as unidades sintáticas consumidas pelo parser.
Um lexer tradicional transforma algo como:
em uma sequência conceitual semelhante a:
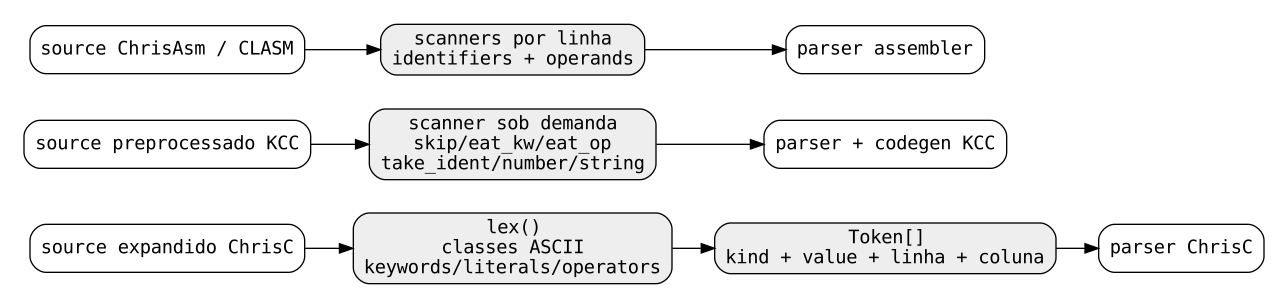
No ChrisOS essa fronteira não é implementada de uma única forma.
A distinção principal é:
- ChrisC possui lexer explícito, que materializa um array fixo de `Token` antes do parsing.
- KCC não possui token stream separado. O parser percorre source preprocessado sob demanda por helpers como `eat_kw`, `eat_op`, `take_ident` e `take_number`.
- ChrisAsm e CLASM usam scanners menores, orientados por linha e adequados à sintaxe de assembly.
Este capítulo descreve essas implementações reais.
Responsabilidade do lexer
Um lexer normalmente decide:
- onde um token termina e outro começa;
- quais sequências são identifiers;
- quais identifiers são keywords;
- como literals numéricos são decodificados;
- como strings e chars são lidos;
- qual operador vence quando spellings compartilham prefixos;
- como whitespace/comments são descartados;
- qual posição de source pertence ao token;
- quando input malformado vira lexical error.
Ele normalmente não decide se símbolo existe, type combina, chamada tem argc correto ou statement é semanticamente legal. Essas tarefas pertencem a parsing e semantic analysis.
ChrisC: tokenização explícita
O lexer ChrisC fica em:
Depois do preprocessing gerar a translation unit combinada, a compilação chama:
O parser recebe um array materializado de tokens e não precisa revarrer o texto para separar lexemas.
Estrutura de Token
ChrisC define:
typedef struct Token {
    TokenKind kind;
    int32_t value;
    int line, column;
    char name[NAME_MAX];
} Token;
Limites atuais:
Logo, uma compilação pode manter no máximo 262.144 tokens, e um identifier tem no máximo 47 caracteres armazenados mais NUL.
Quando o array enche, a compilação falha com:
Linha e coluna
O lexer mantém contadores de linha e coluna durante o scan.
Cada token grava a linha e a coluna inicial.
Como preprocessing pode incorporar includes e outros arquivos, o compilador também conserva mapeamentos de origem.
`line_origin` traduz linha da translation unit expandida de volta para arquivo e linha originais.
Esse mecanismo conecta o source transformado aos diagnostics visíveis ao usuário.
Classes de caracteres
ChrisC usa regras ASCII simples.
Identifier começa com:
- underscore;
- `a-z`;
- `A-Z`.
Depois pode conter também `0-9`.
Não há suporte a categorias Unicode para identifiers.
Comprimento de identifier
Se o spelling ultrapassa `NAME_MAX - 1`, ChrisC falha com:
Não ocorre truncation silencioso.
Isso evita que dois nomes longos diferentes se tornem o mesmo identifier interno.
Keywords
Depois de ler um identifier, ChrisC chama:
A comparação é exata e case-sensitive.
Exemplos de palavras reconhecidas:
void
int
float
char
struct
if
else
while
for
return
break
continue
long
short
unsigned
signed
const
static
extern
volatile
enum
union
typedef
switch
case
default
do
goto
sizeof
asm
_Generic
_Static_assert
_Alignas
_Alignof
_Bool
restrict
_Noreturn
_Thread_local
_Complex
Existem escolhas de compatibilidade específicas do projeto.
Por exemplo:
- `double` cai no mesmo `T_FLOAT` que `float`;
- `bool` compartilha caminho com `_Bool`;
- `register` e `auto` usam hoje o mesmo token path usado por `inline`.
Essas escolhas não significam conformidade semântica completa com ISO C.
Identifiers comuns
Se `keyword` não reconhece spelling reservado, o kind é:
O texto é copiado para `name`.
Somente etapas posteriores decidem se o name representa variável, typedef, enum, function, member ou builtin.
Whitespace
ChrisC ignora space, tab, carriage return e newline.
Newline incrementa linha e reinicia coluna em 1.
Whitespace não chega ao parser.
Comments
O lexer reconhece:
Line comment termina em newline.
Block comment termina no primeiro `*/`.
Nested block comments não são suportados.
EOF antes do fechamento produz:
Strings
Ao encontrar aspas duplas, o lexer grava bytes decodificados em um string pool compartilhado.
Limite:
O token não armazena toda a string; `value` aponta para o offset inicial no pool.
Escapes em strings
ChrisC trata especialmente:
Outro caractere precedido de backslash é inserido diretamente.
Não existe aqui implementação completa de octal, hex escape ou universal character name do C.
Concatenação de strings adjacentes
Após fechar uma string, o lexer pula whitespace horizontal e newlines.
Se o próximo item for outra string, continua anexando no mesmo payload.
Assim:
vira uma única string lógica.
O NUL final é colocado quando termina a sequência de literals adjacentes.
String não terminada
Newline ou EOF antes do fechamento produz:
Pool esgotado produz:
Esses erros ocorrem antes do parsing.
Character literals
Character literal vira:
com o byte em `value`.
Escapes especiais:
Falta de fechamento gera:
O modelo atual é byte-oriented e não cobre toda a gramática de wide/multicharacter/universal literals do C.
Integers
ChrisC reconhece decimal e hexadecimal com `0x`/`0X`.
Leading zero sozinho não ativa octal.
O limite acumulado é:
Overflow gera:
Sufixos de integer
Depois dos digits, o lexer consome:
O suffix não cria um objeto de tipo lexical rico.
O token continua com um valor de 32 bits, e interpretação de type acontece depois.
Hexadecimal inválido
Um source como:
sem digit hexadecimal produz:
Float literals
ChrisC suporta forma decimal simples, incluindo:
O bit pattern de `float` fica no campo `value`.
Limites atuais incluem ausência de:
- exponent notation como `1e6`;
- hexadecimal float;
- representação lexical distinta de double precision.
Operadores e maximal munch
Muitos operadores compartilham prefixos:
ou:
O lexer testa spellings maiores antes dos menores.
Há token kinds para formas como:
O parser recebe a separação já resolvida.
Pontuação
Também existem tokens de um caractere para:
Caractere inválido
Byte que não corresponde a whitespace, comment, identifier, literal ou operador/pontuação conhecidos gera:
O lexer não ignora input desconhecido silenciosamente.
EOF token
Ao terminar o source, ChrisC adiciona:
com posição atual.
O parser distingue fim normal de input via token stream.
Yield cooperativo
O loop principal chama:
Quando há callback instalado, compilation longa pode devolver controle periodicamente ao ambiente.
Isso é cooperação, não parallel lexing.
Diagnostics lexicais do ChrisC
Erros relevantes incluem:
source size outside limit
unterminated comment
identifier too long
string pool full
unterminated string
unterminated char
integer literal overflow
bad integer literal
invalid character
too many tokens
O mapeamento de origem permite relacionar essas falhas a arquivos originais mesmo após includes/expansion.
KCC: scanner sob demanda
KCC segue arquitetura diferente.
Depois do preprocessing, `g_p` aponta para o buffer preprocessado.
O parser avança esse pointer diretamente.
Não existe um `Token[]` independente entre preprocessing e parsing.
A fronteira lexical está espalhada por helpers.
Preprocessing no KCC
Antes dos scanners do parser, KCC:
- lê logical lines;
- trata line continuations;
- remove comments;
- processa directives;
- expande macros;
- resolve includes;
- escreve markers `#line`.
Por isso o parser trabalha sobre source já transformado.
`skip`
`skip()` consome spaces, tabs, CR e newlines.
Também processa markers:
por `parse_hash`.
Ao ler marker, atualiza `g_file` e `g_line`.
KCC preserva provenance sem armazenar span em cada token, porque não há token object materializado.
Keywords no KCC
KCC usa:
A função confirma que o próximo character depois da palavra não pertence a identifier.
Assim:
não casa com keyword:
O parser define em qual posição cada keyword é válida.
Operadores no KCC
KCC usa:
para operadores e punctuation.
A função faz string match direto e avança `g_p`.
Ela não impõe token boundary depois do operador.
Logo, disambiguation de operadores sobrepostos depende da ordem em que o parser testa os spellings.
Isso é diferente do maximal-munch centralizado do ChrisC.
Identifiers no KCC
`take_ident` aceita:
O input inteiro é consumido.
Porém somente a parte que cabe no buffer do caller é copiada.
Não existe erro lexical equivalente a `identifier too long`.
Portanto callers precisam dimensionar buffers corretamente, e identifiers excessivamente longos podem ser truncados na representação local.
Integers no KCC
`take_number` aceita decimal, hex `0x`/`0X` e suffixes `u/U/l/L`.
O acumulador é 64-bit.
Overflow gera:
É uma faixa maior que a do lexer ChrisC.
Leading zero sem `x` não cria octal.
Floats no KCC
O primary-expression path atual usa `take_number`, `take_char`, `take_string` e identifiers.
Não existe scanner separado de floating literal no source atual.
KCC tem `TY_FLOAT`, mas existência do type não significa que a grammar de literal seja equivalente ao `T_FNUM` do ChrisC.
Characters no KCC
`take_char` trata:
e um byte comum.
Se a closing quote estiver presente, ela é consumida.
Porém o helper não gera diretamente erro de “unterminated char” ao alcançar fim sem fechamento.
O parser pode falhar depois, mas a validação lexical é menos centralizada.
Strings no KCC
`take_string` reconhece:
e copia para buffer fornecido pelo caller.
Ele mantém o decoded length mesmo se o output buffer não comportar todo o conteúdo, permitindo que caller detecte oversized use.
O helper também não rejeita diretamente EOF antes de closing quote.
Comments no KCC
KCC remove comments no preprocessing com:
São reconhecidos line comments e block comments, mantendo estado do block comment entre linhas lógicas.
Double-quoted strings são rastreadas para que delimitadores de comment dentro delas não sejam tratados como comment.
Markers de origem
O preprocessor insere:
no buffer `g_pp`.
`skip` consome esses markers e atualiza source location.
É a alternativa do KCC ao modelo per-token do ChrisC.
Comparação arquitetural
Vantagens do token stream do ChrisC
- regras lexicais centralizadas;
- maximal munch único;
- linha/coluna estáveis por token;
- lookahead do parser separado do raw source;
- erros lexicais claros.
Custos: um pass adicional, memória para tokens e limite fixo.
Vantagens do scanner sob demanda do KCC
- menos memória para token stream;
- helpers pequenos;
- fácil integração com parser específico do projeto.
Custos:
- lexer e parser mais acoplados;
- order-dependent operator matching;
- tratamento de input malformado distribuído;
- enforcement menor de identifier length;
- diagnostics menos centralizados.
Scanner do ChrisAsm
ChrisAsm é line-oriented.
`parse_ident` lê até whitespace ou delimiters como:
O spelling pode representar mnemonic, register, symbol ou directive conforme contexto.
Números no ChrisAsm
`parse_u64` aceita decimal e hexadecimal com `0x` e protege overflow de 64 bits.
É scanner de operand de assembler, não grammar de C literal.
Comments no ChrisAsm
Depois de whitespace, linha iniciando com:
é ignorada.
Semicolon também aparece como delimiter durante parsing de statements.
Scanner do CLASM
O assembler CLVM possui scanner por linha ainda menor.
`word` aceita:
para labels e instruction names.
Comparação de nomes é case-insensitive, diferente de identifiers ChrisC/KCC.
Números no CLASM
`number` aceita sinal negativo opcional, decimal e hex.
Acumula 32 bits e entrega `int32_t`.
A regra existe especificamente para operands da VM.
Comments e trailing text no CLASM
Tail de linha é considerado vazio se houver whitespace ou começar por:
Texto extra inesperado é rejeitado por `parse_line`.
A fronteira entre scanning e grammar validation é estreita.
Evidência de validação
`tools/test_chrisc_c17.c` exercita macros, identifiers, literals, operadores e muitas keywords C-like em compile-and-run.
`tools/test_fuzz_chrisc.c` envia source pseudo-random determinístico, exige retornos de sucesso/falha válidos e depois confirma que programa conhecido continua compilando.
`tools/test_kcc.c` compila fixtures e arquivos reais do kernel, exercitando preprocessing/scanning/parsing do KCC em corpus amplo.
`tools/test_chrisasm.c` verifica assembly aceito, mnemonic desconhecido e symbol references com relocation.
`tools/test_clasm.c` verifica labels, instructions, integer operands e bytecode gerado.
Lacunas de teste
Ainda não há suite table-driven específica do lexer ChrisC cobrindo cada spelling e cada erro.
Casos úteis:
- todas as keywords;
- todos os multi-character operators;
- conflitos de maximal munch;
- limite exato de identifier;
- limite de integer overflow;
- `0x` inválido;
- adjacent strings entre linhas;
- todos os escapes suportados;
- comportamento de escape não suportado;
- comment/string/char não terminados;
- bytes não ASCII;
- limite de token count;
- truncation de identifier no KCC;
- strings/chars não terminados no KCC;
- operator-prefix ordering no KCC;
- source position através de nested include/macro expansion.
Segurança e robustez
Lexers processam texto potencialmente hostil.
Riscos incluem:
- integer overflow;
- buffer overflow;
- escapes malformados;
- delimiters não terminados;
- erro de bounds;
- confusão comment/string;
- operator matching ambíguo;
- rescans patológicos.
ChrisC centraliza vários desses controles com bounds e hard errors.
KCC usa muitos buffers limitados, mas o tratamento de malformed input está distribuído entre preprocessor, scanner helpers e parser.
Nenhum dos dois deve ser descrito como hardened parser para input adversarial sem fuzzing e testes específicos.
Complexidade
O lexer ChrisC é fundamentalmente:
no tamanho do source expandido.
Keyword lookup é uma sequência curta de comparações exatas.
KCC não tem um único lexical pass.
O custo de scanning aparece distribuído nas operações do parser e em lookaheads.
A maior parte avança `g_p`, mas algumas rotinas salvam/restauram o pointer, acoplando custo lexical à grammar.
Limitações atuais
Na revisão documentada:
- identifiers ChrisC são ASCII-only;
- armazenamento de identifier ChrisC é limitado a 47 caracteres;
- integers ChrisC têm valor lexical máximo de 32 bits;
- ChrisC tem decimal/hex, sem octal mode;
- float syntax ChrisC não cobre exponent/hex float;
- escapes ChrisC são subset pequeno;
- token e string pools possuem limites fixos;
- KCC não tem token stream independente;
- operator matching KCC depende da ordem do parser;
- identifiers KCC podem ser truncados no buffer destino;
- primary scanner KCC não possui general float-literal scanner;
- string/char helpers KCC não rejeitam diretamente closing quote ausente;
- ChrisAsm/CLASM usam scanners propositalmente menores;
- não existe biblioteca lexical comum à toolchain.
Fronteira de roadmap
Uma camada lexical mais forte pode adicionar:
- especificação formal do language profile;
- tabelas geradas para keywords/operators;
- source-span reutilizável;
- política explícita UTF-8/Unicode;
- grammar completa de numeric literal para cada profile;
- grammar completa de escapes;
- testes lexicais standalone;
- property-based/coverage-guided fuzzing;
- error codes estruturados;
- scanner KCC reentrante;
- separação mais clara entre scanner e parser do KCC;
- preservation de source span através de macro expansion.
Esses itens continuam roadmap até existirem no source e validação.
Mapa de source e revisão
O lexer explícito ChrisC, token kinds, storage e source-position logic estão em `compiler/chrisc/chrisc.c`. Os helpers scanner-on-demand e preprocessing do KCC estão em `compiler/kcc/kcc.c`. O scanner ChrisAsm está em `compiler/chrisasm/chrisasm.c`, e o scanner do assembler CLVM em `compiler/clvm/clasm.c`.
Todas as afirmações sobre comportamento atual foram reconciliadas com ChrisOS `e05a17fd76333114a3fb5c2452f38ca747d4ac56`.