
Cache e allocation de blocks no ChrisFS
Sobre este capítulo Estruturas e recuperação do ChrisFS
Neste capítulo
- Cache e allocation de blocks no ChrisFS
- Escopo
- Estrutura do cache em memória
- Cache por objeto Cfs
- Reset do cache
- Lookup de tag
- Invalidação de duplicatas
- Caminho de hit
- Caminho de miss
- Política de victim
- Write-through
- Raw write versus write journaled
- Sem writeback atrasado
- Read-ahead separado
- Contiguidade física obrigatória
- Read-ahead não aquece o cache
- Contadores não incluem read-ahead
- API dos counters
- Estrutura do bitmap
- Endereços absolutos e relativos
- Bitmap reads passam pelo cache
- Bitmap write é read-modify-write
- Allocation hint
- Hint inicial
- Busca de allocation
- Allocation bem-sucedida
- Rollback de allocation
- Free
- Free não zera o block
- Localidade de allocation
- Fragmentação
- Complexidade do allocator
- Complexidade do cache
- Interação com lock global
- Reentrada
- Validação de concorrência
- Evidência de validação do cache
- Evidência de allocation
- Bypasses diretos do BlockDevice
- Limitações atuais
- Fronteira de roadmap
- Mapa de source e revisão
Escopo
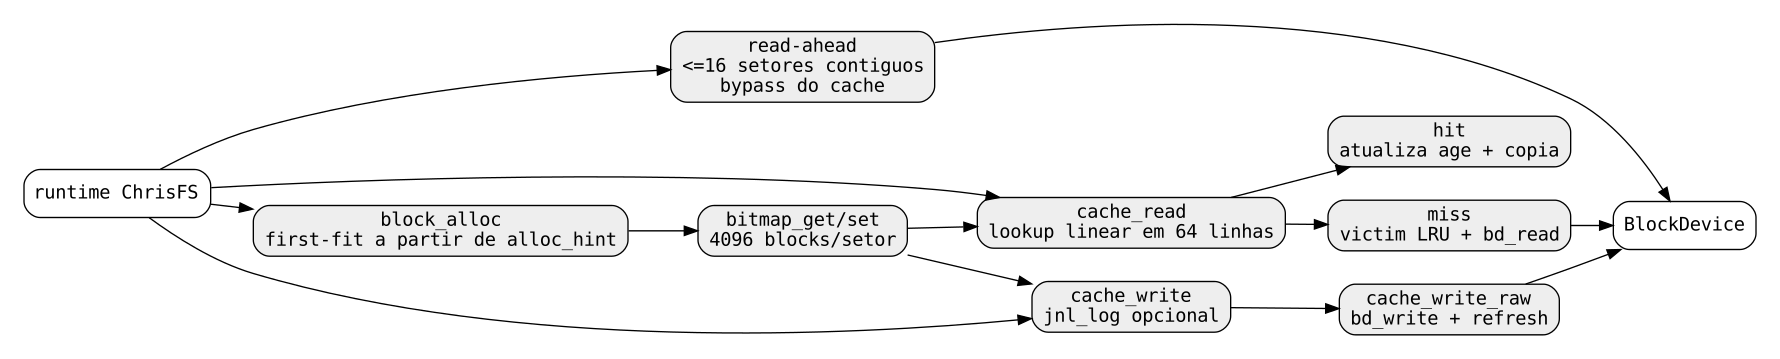
ChrisFS combina dois mecanismos centrais no objeto montado Cfs:
- cache de setores com 64 linhas;
- allocator por bitmap com allocation hint móvel.
O cache é deliberadamente simples:
- um setor de 512 bytes por linha;
- lookup linear de tags;
- comportamento write-through;
- sem dirty lines;
- substituição aproximadamente LRU via contador de age.
O allocator também é compacto:
- um bit por setor da data region;
- allocation e free usando os mesmos bitmap sectors cacheados;
- um
alloc_hintpara evitar reiniciar toda busca no bit zero.
Esses mecanismos estão fortemente ligados ao journal e ao lock global do filesystem. Cache writes são o ponto de interceptação usado pelo journaling, enquanto allocation modifica bitmap sectors pelo mesmo caminho.
Este capítulo documenta ChrisOS e05a17fd76333114a3fb5c2452f38ca747d4ac56.
Estrutura do cache em memória
Cada cache line contém:
O número de linhas é fixado por:
Logo, a capacidade de payload é exatamente:
além de metadata de tag/age/valid e padding normal de C.
Não há dimensionamento dinâmico conforme RAM ou capacidade do device.
Cache por objeto Cfs
O array de cache fica dentro de:
junto de:
- superblock montado;
- scratch sector de 512 bytes;
- clock de age;
- contadores de hit/miss;
- journal state;
- allocation hint.
Portanto o cache é por objeto Cfs, não process-global.
O lock do filesystem, porém, é global, então dois mounts independentes ainda ficam serializados pela implementação atual.
Reset do cache
cache_reset:
- zera cache clock;
- zera hit counter;
- zera miss counter;
- marca as 64 linhas como inválidas;
- zera LBA e age armazenados.
Não zera os 512 bytes de payload de cada linha, porque linha inválida nunca é consultada.
cfs_mount executa cache_reset antes do journal replay.
Isso impede conteúdo cacheado de mount anterior de interferir no novo estado.
Lookup de tag
cache_read percorre linearmente as 64 linhas.
Para toda linha com:
seleciona a cópia com maior age.
Normalmente deve existir no máximo uma linha válida por LBA.
A escolha pelo maior age e a invalidação posterior são defesa contra duplicatas no cache.
Invalidação de duplicatas
Em hit, cache_read faz um segundo scan e invalida qualquer outra linha válida com o mesmo LBA.
Em miss e em raw write, cache_drop_lba invalida todos os matches antes de instalar uma nova cópia.
A implementação reforça o invariante:
mesmo que bug anterior ou bypass tenham criado duplicatas.
Caminho de hit
Em hit:
- incrementa
cache_hits; - invalida duplicatas;
- incrementa cache clock;
- salva o age na linha vencedora;
- copia 512 bytes para o caller.
O backing BlockDevice não é tocado.
Caminho de miss
Em miss:
- incrementa
cache_misses; - invalida eventual stale line do mesmo LBA;
- escolhe victim;
- faz
bd_readde um setor; - preenche victim;
- incrementa age;
- copia payload ao caller.
Se bd_read falha, a victim não é marcada válida.
Como não existem dirty lines, eviction nunca perde dado ainda não persistido.
Política de victim
cache_victim devolve:
- primeira linha inválida, se houver;
- caso contrário, a linha válida com menor
age.
Isso aproxima LRU.
É correto em relação aos ages enquanto o clock de 32 bits não faz wrap.
Não existe tratamento explícito para overflow.
Depois de aproximadamente:
o clock volta a zero e “menor age = mais antigo” deixa temporariamente de refletir recência real.
É edge case de longa execução, não um limite comum.
Write-through
ChrisFS não possui dirty cache lines.
cache_write_raw:
- grava o setor no backing device;
- se falhar, retorna
CFS_EIO; - invalida cópias cacheadas do LBA;
- escolhe victim;
- instala o setor já gravado como linha nova;
- atualiza age.
O device write acontece antes da atualização do cache.
Uma write falha não instala os bytes novos como estado cacheado válido.
Raw write versus write journaled
Existem dois helpers.
cache_write_raw
Grava diretamente o home LBA e atualiza cache.
Ignora interceptação do journal.
É usado em mecanismos como:
- headers/records de journal;
- replay;
- certas writes de superblock.
cache_write
Quando:
primeiro chama:
e só depois:
Assim, a camada de cache write é o principal interception point do journal atual.
O capítulo de journal explica por que isso não produz transação completa.
Sem writeback atrasado
Como toda write normal chega imediatamente em bd_write:
- eviction não precisa flush de dirty line;
cfs_syncnão percorre linhas de cache;- não existe dirty list;
- pressão no cache não causa writeback.
cfs_sync apenas chama:
para pedir flush ao block layer.
Read-ahead separado
Reads alinhados podem bypassar o cache de um setor.
cfs_read_at detecta run de file blocks fisicamente contíguos e lê até:
em um único bd_read.
Payload máximo:
O buffer é global:
e não alocação por Cfs.
Contiguidade física obrigatória
O código começa no primeiro mapped block e estende o run apenas enquanto:
e o próximo block:
- resolve com sucesso;
- está na data region;
- cabe na quantidade pedida;
- mantém run abaixo de 16 setores.
Adjacência lógica no arquivo não basta.
Arquivo fragmentado volta ao caminho cacheado setor a setor.
Read-ahead não aquece o cache
Quando um run multi-sector é lido:
- faz
bd_readdireto parag_cfs_ra; - chama
cache_drop_lbapara cada setor; - copia o buffer ao caller.
Não instala os setores no cache.
Isso evita stale copies após bypass, mas repeated sequential reads grandes não aquecem automaticamente o cache.
Contadores não incluem read-ahead
cache_hits e cache_misses só são alterados em cache_read.
Um read-ahead direto:
- é I/O físico;
- não conta hit;
- não conta miss.
Logo, os counters medem atividade do cache de um setor, não o hit ratio global de I/O do filesystem.
API dos counters
Getters públicos:
Ambos entram no lock global.
Isso mantém leitura consistente com atividade do cache e permite reentrada pelo mesmo owner.
O host test confirma que uma sequência normal de mount/write/read produz pelo menos um hit e um miss.
Não há assertion de replacement trace exato.
Estrutura do bitmap
Allocation usa um bit por setor da data region.
Para índice relativo i:
porque:
Bit 1 significa allocated.
Bit 0 significa livre.
Endereços absolutos e relativos
O allocator trabalha com bitmap index relativo.
Block allocated é devolvido como LBA absoluto no filesystem:
Free faz o inverso:
depois de validar que o LBA está na data region.
Bitmap reads passam pelo cache
bitmap_get chama:
e extrai o bit.
Allocation sequencial consulta repetidamente o mesmo bitmap sector enquanto percorre bits próximos.
Depois do primeiro miss, os próximos probes naquele setor podem ser hits.
Um bitmap sector representa 4096 data sectors.
Bitmap write é read-modify-write
bitmap_set:
- lê o bitmap sector via cache;
- altera um bit em
fs->sector; - grava o setor inteiro por
cache_write.
Uma allocation/free gera, portanto, full-sector bitmap write.
Se journaling metadata estiver ativo, esse setor inteiro pode consumir um journal record.
Allocation hint
Cfs contém:
O comentário no source registra a motivação:
o allocator antigo reiniciava todo scan em zero, fazendo cópia multi-megabyte degradar para comportamento praticamente quadrático e travar o installation gate.
Com o hint, a busca normalmente continua perto da última allocation.
Hint inicial
cfs_mount zera a struct Cfs inteira antes de inicializar.
Não existe assignment posterior explícito de alloc_hint no mount.
Valor inicial:
O root directory data block já está marcado allocated no bitmap, então a primeira allocation ordinária tende a pular índice 0 e usar o próximo livre.
Busca de allocation
block_alloc define:
Se hint está fora da data region, volta para zero.
Depois examina no máximo:
bits candidatos.
O índice faz wrap uma vez pela região.
Assim, toda allocation é bounded e consegue encontrar free block em qualquer posição do bitmap.
Allocation bem-sucedida
Quando encontra bit livre:
- marca bitmap como usado;
- zera scratch sector de 512 bytes;
- grava zeros no block recém-alocado;
- seta:
- devolve LBA absoluto.
Zero write impede que conteúdo antigo de block free seja exposto pela allocation normal.
Rollback de allocation
Se a write de zeros falha, block_alloc tenta:
para desfazer a marcação.
Mas ignora o retorno:
Se a write de dados falha e o rollback do bitmap também falha, pode restar bit allocated para block que nunca foi devolvido ao caller.
fsck pode detectar esse estado como bitmap leak.
Free
block_free valida o LBA contra a data region.
Depois calcula o index.
Se:
move o hint para trás.
Por fim limpa o bit.
Isso favorece reutilização de holes abaixo da fronteira anterior.
Free não zera o block
O caminho de free somente limpa o bitmap bit.
Não apaga o setor de dados.
Os bytes antigos permanecem até reutilização.
A allocation posterior zera o block antes de entregá-lo, então o reuse normal não expõe conteúdo anterior.
Isso não é secure erase.
Localidade de allocation
Após sucesso:
Assim, crescimento sequencial tende a receber blocks fisicamente consecutivos quando existe free run suficiente.
Benefícios:
- menos bitmap misses;
- maior chance de
cfs_read_atusar read-ahead de 16 setores.
Não existe extent allocator; essa localidade é efeito do first-fit-from-hint.
Fragmentação
Quando o hint encontra block ocupado, block_alloc continua até o próximo bit livre.
Free de block inferior pode mover o hint para trás.
Com o tempo isso forma padrão parecido com first-fit.
Não existe:
- best-fit;
- extent reservation;
- locality group;
- free-run tree;
- placement aware de fragmentação.
Prioriza simplicidade e scan bounded.
Complexidade do allocator
Uma allocation isolada pode examinar todos os bits:
no pior caso.
Na prática, cada bitmap sector cacheado contém 4096 bits e alloc_hint avança, reduzindo muito o custo em espaço livre sequencial.
Sem hint, alocar N blocks em prefixo crescente poderia reexaminar todos os bits anteriores e aproximar comportamento quadrático.
Complexidade do cache
Com 64 linhas fixas:
Hit
no scan inicial, mais outro O(64) para remover duplicatas.
Miss
para tags/invalidation/victim, mais um device read.
Raw write
para invalidation/victim, mais um device write.
A constante é pequena e previsível, mas não há hash nem indexação direta.
Interação com lock global
Operações públicas usam:
de fs_lock.h.
O lock é:
- global;
- reentrante por owner;
- spin-based com
pause; - compartilhado por toda atividade ChrisFS.
Isso é necessário para a correção atual porque os seguintes estados são mutáveis e compartilhados:
- cache data/tags/ages;
fs->sector;alloc_hint;- journal;
- buffer global de read-ahead.
O custo é serializar operações independentes.
Reentrada
cfs_read entra no lock e chama cfs_read_at, que também entra.
O lock mantém:
e aceita reentrada do mesmo owner.
No kernel, owner é CPU atual + 1.
O header avisa que não deve ser adquirido em interrupt context.
Validação de concorrência
tools/test_cfs_lock.c executa writer e reader threads simultâneos.
Writer alterna o arquivo de oito bytes entre:
Reader verifica que cada read bem-sucedido contém somente um byte repetido, e não mistura torn.
Ao final, o filesystem precisa passar fsck.
Isso valida serialização coarse-grained no host.
Não valida escalabilidade paralela, pois a implementação deliberadamente serializa.
Evidência de validação do cache
tools/test_cfs_host.c confirma que após format, mount, write, remount e reads:
Assim, hit e miss são exercitados.
Não existe teste dedicado que valide:
- ordem LRU exata;
- boundary de eviction 64→65 linhas;
- repair de duplicatas;
- wrap do clock;
- interação read-ahead/cache;
- preservação do cache após failed write.
Evidência de allocation
A suíte host exercita:
- large file writes;
- crescimento de diretórios;
- bitmap I/O error;
- namespace de alta ocupação.
test_cfs_indirect.c grava e lê 70.000 bytes e termina com fsck.
A suíte mais ampla e installation path exercitam alloc_hint indiretamente durante cópias maiores.
Não existe teste unitário específico de probe count em bitmap fragmentado.
Bypasses diretos do BlockDevice
Nem todo I/O ChrisFS passa pelo cache.
Exemplos:
- writes do format;
- alguns reads de diagnóstico no mount;
- inspeção direta do fsck;
- read-ahead multi-sector.
A coerência vale para runtime paths que explicitamente resetam ou invalidam as linhas relevantes.
Executar fsck e mutation concorrentes não faz parte do modelo suportado; o lock global serializa a interface ChrisFS pública.
Limitações atuais
Na revisão documentada:
- cache fixo de 64 linhas;
- lookup linear;
- age de 32 bits sem correção de wrap;
- sem adaptive sizing;
- sem write-back;
- read-ahead não popula cache;
- I/O de read-ahead não entra nos counters;
- lock global serializa todos os mounts ChrisFS;
- um scratch sector por
Cfs; - buffer global de read-ahead de 8 KiB;
- allocator bitmap first-fit-from-hint;
- pior caso de allocation linear no número de data sectors;
- sem extent allocator;
- sem métrica/política de fragmentação;
- rollback da zero-write pode falhar e é ignorado;
- free não faz secure erase;
- bitmap mutations são full-sector read-modify-write;
- writes repetidas de bitmap pressionam o journal pequeno;
- sem suíte dedicada para replacement e probe behavior.
Fronteira de roadmap
Um subsistema mais forte pode considerar:
- lookup indexado no cache;
- LRU com epoch segura a wrap ou CLOCK;
- cache partitionado por filesystem/CPU;
- write-back opcional com durability explícita;
- read-ahead que aqueça cache;
- counters separados para cache/readahead/raw metadata I/O;
- allocation por extents ou runs;
- summaries de free space;
- rollback transacional;
- métricas de fragmentação;
- secure discard quando o device permitir;
- locking mais granular;
- testes determinísticos de eviction e failure injection.
Esses itens permanecem roadmap até implementação e validação no source.
Mapa de source e revisão
kernel/fs/cfs.h define CfsCacheLine, Cfs e counters. kernel/fs/cfs.c implementa lookup/replacement, read-ahead, bitmap access, allocation e free. kernel/fs/fs_lock.h define o lock global reentrante. kernel/fs/storage_limits.h fixa sector size e 64 cache lines. tools/test_cfs_host.c, test_cfs_lock.c e test_cfs_indirect.c fornecem a evidência host-side principal.
Todas as afirmações de comportamento atual foram reconciliadas com ChrisOS e05a17fd76333114a3fb5c2452f38ca747d4ac56.