
Journaling e recuperação do ChrisFS
Sobre este capítulo Estruturas e recuperação do ChrisFS
Neste capítulo
- Journaling e recuperação do ChrisFS
- Escopo
- Geometria da região
- Magic
- Layout do header
- Estados
- Objeto em memória
- Sequence
- Layout dos records
- Checksum do payload
- Falta de validação do target LBA
- Início de transação
- Logging
- Integração com cache
- Por que não há rollback de BEGIN
- jnl_data e cobertura parcial
- Operações que usam journal
- Cobertura de mkdir
- Cobertura de unlink
- Limite concreto de unlink
- Efeito de exaustão
- Commit
- Ausência de barriers
- Janelas de crash
- Replay no mount
- Replay de BEGIN
- Replay de COMMIT
- Bug de record count acima do máximo
- Interação com journal region curta
- fsck e journal
- Inicialização no format
- Evidência de validação
- Casos sem teste dedicado
- Garantias efetivas
- Limitações atuais
- Fronteira de roadmap
- Mapa de source e revisão
Escopo
ChrisFS possui um pequeno journal em estilo redo, criado para melhorar recuperação de metadata após operações interrompidas.
A implementação atual não é um transaction manager geral e não fornece semântica ACID completa.
Os mecanismos principais são:
- um setor de header;
- até 30 imagens de setor logadas;
- estados BEGIN, COMMIT e EMPTY;
- checksum por payload;
- replay no mount de records committed;
- descarte de estado BEGIN não committed;
- clean/dirty flag no superblock.
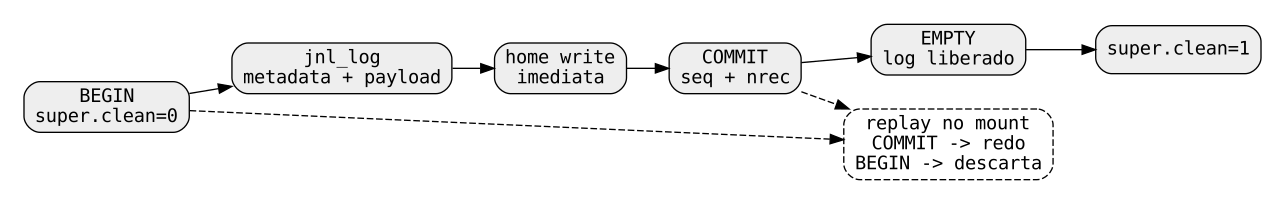
O journal está diretamente integrado ao cache write-through. Toda escrita que passa por cache_write enquanto jnl_active == 1 e jnl_data == 0 é logada antes da home write correspondente.
Este capítulo documenta ChrisOS e05a17fd76333114a3fb5c2452f38ca747d4ac56.
Geometria da região
O formato normal reserva:
setores.
A região contém:
setor 0     header do journal

para record i:
setor 1 + 2*i     metadata do record
setor 2 + 2*i     payload completo de 512 bytes
Com:
o máximo de espaço usado normalmente é:
restando três setores extras na região normal de 64 setores.
O validator do superblock v5 aceita regiões menores que isso; essa limitação está documentada no capítulo de superblock.
Magic
O magic é:
Em little-endian:
ou:
Magic zero também é tratado por replay como representação de journal vazio.
Assim, duas formas de vazio aparecem na prática:
- header CJNL com state EMPTY;
- header totalmente zerado.
Format cria a primeira. Replay de BEGIN descartado cria a segunda.
Layout do header
O header ocupa um setor de 512 bytes.
Campos ativos:
| Offset | Tamanho | Campo |
|---|---|---|
| 0 | 4 | magic |
| 4 | 4 | sequence |
| 8 | 4 | state |
| 12 | 4 | record count |
| 16 | 4 | checksum |
Bytes 20..511 são zerados quando o header é gerado.
O checksum cobre:
e portanto protege:
- magic;
- sequence;
- state;
- nrec.
O próprio checksum e o restante do setor ficam fora.
Estados
Estados definidos:
Qualquer outro state não zero faz replay retornar:
quando magic/checksum são válidos.
Objeto em memória
Jnl mantém:
No BEGIN:
fsaponta para o filesystem;seqrecebefs->super.generation;nrecvira zero.
rec_lba[] recebe os LBAs conforme records são criados.
Na revisão atual, esse array não é consultado depois para deduplicação, validação ou replay.
Sequence
jnl_begin usa:
COMMIT usa a mesma sequence.
jnl_commit escreve EMPTY com:
Mas replay não compara nem valida sequence.
Após replay de COMMIT, o código zera o buffer do header e escreve EMPTY sem restaurar sequence, deixando-a zero.
Logo, sequence é persistida, mas não funciona hoje como invariante de ordering entre transações.
Layout dos records
Cada record ocupa dois setores.
Metadata sector
Campos ativos:
| Offset | Tamanho | Campo |
|---|---|---|
| 0 | 4 | target home LBA |
| 4 | 4 | checksum do payload |
O resto é zero.
Payload sector
O setor seguinte contém a imagem completa de 512 bytes que deve ser escrita no target LBA.
É redo por imagem de setor, não log de byte ranges.
Checksum do payload
jnl_log calcula checksum sobre:
do payload.
Replay valida esse checksum antes de aplicar o record.
Isso detecta corrupção do payload.
Não protege o target LBA armazenado no metadata sector.
Uma corrupção que altere somente:
pode redirecionar um payload válido sem disparar o checksum.
Não existe checksum próprio para a metadata do record.
Falta de validação do target LBA
Replay extrai o LBA e passa diretamente para:
Não há check explícito garantindo que o target:
- esteja dentro do volume declarado;
- esteja fora da própria região de journal;
- pertença a uma região de metadata esperada;
- corresponda a um setor plausível para a operação original.
O block device pode rejeitar write fora do device, mas um LBA corrompido ainda dentro do device pode atingir metadata ou dados não relacionados.
Recovery robusto precisa validar o endereço e proteger a metadata do record.
Início de transação
jnl_begin:
- inicializa
Jnl; - define
super.clean = 0; - encoda o superblock;
- grava o dirty superblock por
cache_write_raw; - grava header BEGIN.
Detalhe importante:
é usado para o dirty-superblock write.
O retorno é ignorado.
Se essa escrita falha, mas o BEGIN header é gravado, jnl_begin pode retornar sucesso sem ter persistido o clean flag como dirty.
Logging
Com journaling habilitado, jnl_log:
- rejeita se
nrec >= 30; - calcula o próximo slot de dois setores;
- grava target LBA e payload checksum;
- grava payload;
- salva target em
rec_lba[nrec]; - incrementa
nrec.
Não existe deduplicação.
Duas writes para o mesmo home sector consomem dois records.
Integração com cache
O caminho normal é:
Se:
então:
é executado antes de:
A ordem no source é:
A home write acontece imediatamente.
Ela não espera COMMIT.
Por que não há rollback de BEGIN
Em um redo journal clássico, a ideia de recovery depende de uma ordem de persistência clara entre log, commit marker e home writes.
No ChrisFS, home write ocorre antes do COMMIT.
Se houver crash em BEGIN, parte das home writes pode já ter sido aplicada.
Replay trata BEGIN como não committed e apenas limpa o journal.
Não restaura conteúdo anterior dos home sectors.
Logo, descartar BEGIN não é rollback.
jnl_data e cobertura parcial
ChrisFS usa jnl_data para desligar logging.
Em cfs_write e cfs_write_at:
durante data writes e allocation/block-tree work.
Somente perto do final muda para:
para persistir o inode.
Assim podem ser modificados sem log:
- file data blocks;
- bitmap;
- indirect pointer blocks;
- double/triple-indirect metadata;
- metadata de allocation escrita durante data mode.
Normalmente o inode final é logado.
Portanto nem mesmo “metadata journaling” descreve perfeitamente o comportamento atual.
Operações que usam journal
O source chama jnl_begin exatamente em quatro caminhos públicos:
cfs_mkdir;cfs_unlink;cfs_write;cfs_write_at.
Não iniciam transação própria:
cfs_create;cfs_rmdir;cfs_rename;cfs_chmod.
cfs_truncate delega ao whole-file write e herda seu comportamento quando chega a cfs_write.
A cobertura é desigual.
Cobertura de mkdir
cfs_mkdir roda com:
durante metadata changes.
Allocation do inode, update de type e parent dirent podem gerar records.
É cobertura mais ampla do que em file write, mas o problema de home-write-before-COMMIT continua.
Cobertura de unlink
cfs_unlink também mantém:
enquanto:
- remove parent dirent;
- libera data blocks no bitmap;
- libera pointer blocks;
- limpa inode.
Cada bitmap update pode consumir um record.
Como não há deduplicação, liberar muitos blocks pode esgotar o journal mesmo que todos os writes atinjam o mesmo bitmap sector.
Limite concreto de unlink
Para regular file na faixa single-indirect, um unlink típico gera pelo menos:
2 records    parent directory sector + parent inode
N records    uma bitmap write por data block
1 record     bitmap write do indirect pointer block
1 record     clear final do inode
Total:
Com máximo de 30:
cabe.
Um arquivo de 27 blocks pode chegar ao record 31 no clear final do inode.
Vinte e sete blocks de 512 bytes representam:
em tamanho cheio, com o 27º block começando assim que o arquivo passa de:
Assim, um arquivo comum na faixa de ~13 KiB+ já pode encontrar exaustão do journal durante unlink.
O ponto exato pode variar caso existam writes adicionais, mas o problema é estrutural: o limite conta writes, não setores únicos.
Efeito de exaustão
Quando jnl_log atinge 30 records, retorna:
antes daquela home write específica.
Mas writes anteriores já foram aplicadas.
A operação retorna sem commit.
No unlink, o estado pode ficar como:
- dirent já removido;
- vários bitmap bits já limpos;
- inode ainda alocado e apontando para blocks agora marcados free;
- journal ainda em BEGIN.
Mount futuro descarta BEGIN e não desfaz essas mudanças.
fsck pode detectar inconsistências derivadas, mas o journal não restaura o estado pré-operação.
Commit
jnl_commit grava:
nessa ordem.
Os payloads já foram escritos nos home sectors durante a operação.
COMMIT funciona principalmente como marker para replay caso nem todas as home writes tenham ficado duráveis.
Ausência de barriers
As funções usam:
que chama:
Não há:
entre:
- metadata do record;
- payload;
- home write;
- COMMIT;
- EMPTY;
- clean-superblock.
Logo, program order não garante durable order.
Controller, emulator ou hardware com write cache pode persistir em ordem diferente.
cfs_sync chama bd_flush, mas commit não o chama.
Além disso, vários backends atuais nem possuem flush real.
Janelas de crash
A sequência é:
sem barrier.
Crash após COMMIT, antes de EMPTY
Mount vê COMMIT e faz replay.
É o caso nominal de redo.
Crash após EMPTY, antes de clean superblock
Mount vê EMPTY e o superblock pode continuar dirty.
Replay não faz nada.
Boot pode executar fsck devido ao clean flag falso.
Persistência reordenada
Sem barriers, EMPTY pode chegar ao storage antes de record/payload/home write anteriores.
Nesse caso a argumentação baseada apenas na ordem do source deixa de valer.
O protocolo atual não possui prova formal de durability sob reorder.
Replay no mount
cfs_mount:
- lê/decodifica superblock;
- reseta cache;
- marca temporariamente filesystem como mounted;
- lê header para diagnóstico;
- chama
jnl_replay; - valida root inode.
Falha de replay aborta mount.
A primeira leitura diagnóstica valida magic/checksum antes de decidir a mensagem serial.
A recovery real ocorre na segunda leitura feita por jnl_replay.
Replay de BEGIN
Para:
replay:
- zera o setor inteiro do header;
- grava de volta.
Nenhum record é aplicado.
Nenhum conteúdo anterior é restaurado.
O clean flag do superblock não é alterado, então dirty persistido continua disponível para disparar fsck posterior.
Replay de COMMIT
Para COMMIT:
- lê metadata do record;
- lê payload;
- valida checksum do payload;
- extrai target LBA;
- regrava payload no home sector;
- incrementa replay count.
Depois grava header CJNL EMPTY.
Não há flush antes de remover o COMMIT marker.
Bug de record count acima do máximo
O loop usa:
Se um header COMMIT com checksum válido declarar:
replay aplica somente os primeiros 30.
Não rejeita o valor.
Depois limpa o journal para EMPTY.
Records excedentes são ignorados silenciosamente em vez de causar corruption error.
O correto seria validar:
antes do replay.
Interação com journal region curta
O superblock v5 aceita:
mas 30 records usam 61 setores.
Nem jnl_log nem jnl_replay verificam se cada slot calculado fica abaixo de:
Volume v5 artificial com journal curto pode levar o journal a acessar setores além da região declarada.
Volumes criados por cfs_format reservam 64 e não sofrem esse caso.
fsck e journal
cfs_fsck lê header e reporta:
em alguns estados.
Porém seu precheck não recalcula checksum do header.
Analisa magic e state.
Assim, header com magic/state plausíveis e checksum incorreto pode ter tratamento diferente no fsck e no replay de mount.
Replay é mais estrito porque valida checksum.
Inicialização no format
cfs_format já zera a metadata region inteira.
Depois cria header CJNL EMPTY com:
- magic;
- state EMPTY;
- checksum.
No fim chama:
Format possui, portanto, uma persistence request final que transações normais do journal não possuem.
Evidência de validação
tools/test_cfs_journal.c cobre quatro grupos.
Geometria
Verifica:
- journal LBA histórico;
- sector count;
- magic CJNL após format.
Descarte de BEGIN
O teste:
- inicia transação;
- loga payload sintético de inode sector;
- não grava o payload no home sector pelo caminho normal;
- remonta;
- verifica descarte de BEGIN.
Isso valida descarte do log.
Não reproduz o caminho normal em que cache_write grava home sector imediatamente após log.
Logo, não prova rollback de operações reais interrompidas.
Replay de COMMIT
O teste força manualmente header COMMIT depois de logar inode modificado.
Após remount verifica aplicação do payload.
Isso valida o caminho redo.
Detecção dirty pelo fsck
O teste grava BEGIN e verifica reason:
Casos sem teste dedicado
Não há testes específicos para:
- crash após home write normal e antes de COMMIT;
- write reordering;
- flush/barrier semantics;
- boundary 30/31 records;
- large unlink esgotando journal;
- target LBA corrompido;
- metadata de record corrompida com payload válido;
nrec > JNL_MAX_REC;- região de journal menor que os slots acessados;
- falha do dirty-superblock write no begin;
- crash entre COMMIT e EMPTY;
- crash entre EMPTY e clean-superblock.
São casos prioritários para recovery testing.
Garantias efetivas
Sob hipóteses estreitas de que:
- writes persistem em source order;
- a região declarada é suficiente;
- targets são válidos;
- record count está no limite;
- não ocorre falha em ponto não coberto;
o journal consegue:
- identificar operação que chegou a COMMIT;
- refazer até 30 imagens de setor;
- descartar header de transação não committed;
- manter indicação dirty em alguns crashes.
Não garante:
- rollback de BEGIN;
- mutation atômica do namespace;
- allocation atômica;
- cobertura completa de metadata;
- durable ordering com write cache;
- atualização all-or-nothing de file data.
Limitações atuais
Na revisão documentada:
- máximo de 30 records;
- limite conta writes, não LBAs únicos;
- sem deduplicação;
rec_lba[]não participa de policy/recovery;- sem checksum da metadata do record;
- target LBA não validado no replay;
- sequence não validada;
nrecacima de 30 é truncado, não rejeitado;- slots não são limitados pela journal geometry declarada;
- descarte de BEGIN não é rollback;
- home writes ocorrem antes de COMMIT;
- sem protocolo de flush/barrier;
- falha do dirty-superblock write é ignorada no begin;
jnl_dataexclui allocation metadata em file-write paths;- coverage varia entre operações;
- create/rmdir/rename/chmod não são transações;
- unlink grande pode esgotar journal após mudanças parciais;
- fsck não valida checksum do header;
- testes não cobrem janelas críticas de crash.
Fronteira de roadmap
Um recovery design mais forte deveria considerar:
- transaction objects com abort semantics;
- deduplicação por home LBA;
- checksum protegendo target LBA e metadata do record;
- validação estrita
nrec <= JNL_MAX_REC; - bounds check de slots contra journal geometry;
- validação da região-alvo antes de replay;
- persistência verificada do dirty superblock;
- flush/barriers entre log, COMMIT, home writes e reclaim;
- journal uniforme para todas as mutações de namespace/metadata;
- capacidade suficiente para worst-case operation ou chunking em múltiplas transações;
- sequence validation;
- failure injection em cada persistence boundary;
- escolha explícita entre redo, undo ou copy-on-write.
Esses itens permanecem roadmap até existirem no source e em recovery tests reproduzíveis.
Mapa de source e revisão
kernel/fs/cfs.h define estados, limite de records e Jnl. kernel/fs/cfs.c implementa interceptação de writes, headers, logging, commit e replay. kernel/fs/cfs_format.h fornece checksum e geometria persistente. kernel/fs/cfs_fsck.c contém os checks atuais de estado do journal. tools/test_cfs_journal.c é a principal evidência host-side.
Todas as afirmações sobre comportamento atual neste capítulo foram reconciliadas com ChrisOS e05a17fd76333114a3fb5c2452f38ca747d4ac56.