
Formato de bytecode e instruction set do CLVM
Sobre este capítulo Execução ChrisC e CLVM
Neste capítulo
- Formato de bytecode e instruction set do CLVM
- Escopo
- Modelo de projeto
- Ordem de bytes
- Header CLV version 1
- Header CLV version 2
- Flags
- Checksum
- Fronteira de validação do loader
- Framing de instructions
- Mapa completo de opcodes atual
- Ordem dos operands na stack
- Representação de integers
- Faults de divisão
- Semântica de shifts
- Representação de floats
- Relative branches
- Conditional branches
- Direct calls
- Indirect calls
- CALLT e operations orientadas a IL
- Encoding de SYS
- SAFEPOINT
- HALT e PRINT
- Encoding produzido pelo ChrisC
- CLASM textual assembler
- Limites de operands no CLASM
- Sincronização de decoders
- Interação com JIT
- Comportamento de malformed bytecode
- Security boundary
- Complexidade
- Evidência de validação
- Limitações atuais
- Fronteira de roadmap
- Mapa de source e revisão
Escopo
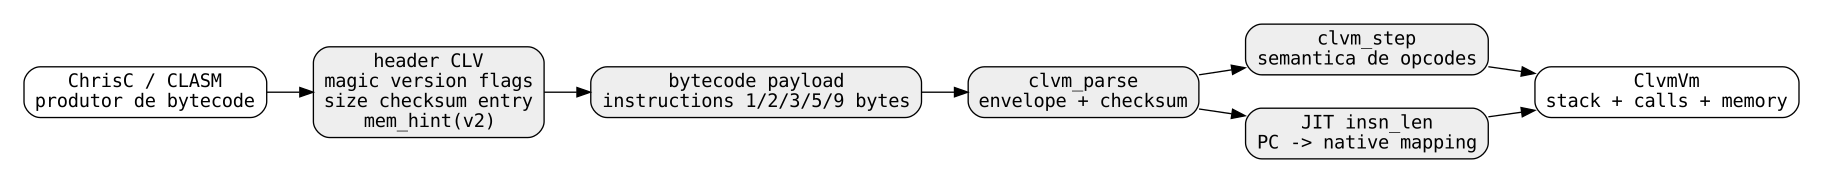
CLVM bytecode é a representação portável de execução usada pelo caminho ChrisC/CLVM no ChrisOS. Ele é distinto de machine code x86-64, de ChrisO native objects e da representação Node[] de nível mais alto usada internamente pelo compiler ChrisC.
Um programa CLVM existe em duas camadas relacionadas:
- raw bytecode, sequência de instructions CLVM de tamanho variável;
- CLV image, envelope de arquivo contendo metadata, entry point, checksum, memory hint opcional e bytecode payload.
O runtime valida o envelope CLV, inicializa um ClvmVm no entry PC da image e então interpreta ou JIT-compila o instruction stream.
Este capítulo define a representação codificada e a semântica atual das instructions. Memory model, syscall ABI e interpreter scheduling policy são tratados separadamente.
Modelo de projeto
CLVM é uma virtual instruction set orientada a stack.
A maioria das arithmetic/logical instructions retira operands da VM operand stack e coloca o result novamente nessa stack. Control-flow calls usam uma segunda stack dedicada a return PCs. Memory instructions interpretam stack values como offsets em guest memory, não como native host pointers.
A máquina possui portanto três domínios importantes:
- bytecode PC: offset dentro do code payload;
- operand value: slot signed de 64 bits na VM operand stack;
- guest address: integer offset interpretado contra vm->memory.
O bytecode não codifica native registers.
Isso mantém instruction encoding compacto e separa o compiler ChrisC de uma host ISA específica.
Ordem de bytes
Todos os multi-byte fields do CLV envelope e todos os immediate operands decodificados pela implementação atual usam little-endian.
clvm_format.c implementa rd16, rd32, wr16 e wr32 explicitamente byte a byte.
clvm_vm.c reconstrói da mesma forma immediates de 32 e 64 bits a partir de sequências little-endian.
O formato não depende de struct packing do host compiler nem das native alignment rules do host CPU.
Nenhuma C structure é simplesmente convertida por cast sobre o header do arquivo CLV.
Header CLV version 1
Version 1 usa header de 16 bytes.
| Offset | Tamanho | Campo |
|---|---|---|
| 0 | 4 | magic: ASCII CLVM |
| 4 | 1 | version = 1 |
| 5 | 1 | flags |
| 6 | 2 | entry PC, little-endian u16 |
| 8 | 4 | code size, little-endian u32 |
| 12 | 4 | bytecode checksum, little-endian u32 |
| 16 | code_size | bytecode payload |
O writer v1 limita code size a 65535 bytes e exige entry < code_size.
O file size deve ser exatamente:
16 + code_size
Não existem trailing sections no formato v1 atual.
Header CLV version 2
Version 2 expande o header para 24 bytes.
| Offset | Tamanho | Campo |
|---|---|---|
| 0 | 4 | magic: ASCII CLVM |
| 4 | 1 | version = 2 |
| 5 | 1 | flags |
| 6 | 2 | reserved, atualmente escrito como zero |
| 8 | 4 | code size, little-endian u32 |
| 12 | 4 | bytecode checksum, little-endian u32 |
| 16 | 4 | entry PC, little-endian u32 |
| 20 | 4 | guest-memory hint, little-endian u32 |
| 24 | code_size | bytecode payload |
Version 2 amplia o range do entry point e permite ao runtime receber memory-size hint.
CLVM_MAX_CODE vale atualmente 16 MiB, portanto code_size v2 precisa ser diferente de zero e não pode superar esse limite.
O parser atual lê o formato mas não atribui semântica independente aos dois reserved bytes em offsets 6-7.
Flags
A image flag definida atualmente é:
CLVM_FLAG_GAME = 0x01
CLVM_KNOWN_FLAGS contém somente essa flag.
clvm_parse rejeita qualquer image cujas flags possuam bits fora da máscara conhecida.
Game flag é metadata da image; ela não modifica opcode decoding.
Runtime components podem usar image metadata para selecionar policy de viewport ou execution behavior, mas o bytecode instruction encoding permanece idêntico.
Checksum
As duas image versions armazenam checksum FNV-1a de 32 bits somente sobre o bytecode payload.
A implementação inicia com:
2166136261
Para cada code byte:
hash = (hash XOR byte) * 16777619 mod 2^32
clvm_parse recalcula o checksum e rejeita a image quando o valor diverge do header.
Isso protege contra corrupção acidental e malformed file transfer.
Não é digital signature e não autentica publisher.
Fronteira de validação do loader
clvm_parse valida o image envelope.
Ele verifica:
- input/output pointers não nulos;
- minimum header size;
- magic CLVM;
- image version suportada;
- known flag mask;
- code size;
- correspondência exata com file size;
- entry point dentro do code;
- checksum.
O loader não executa full semantic verification do instruction stream.
Por exemplo, ele não prova em load time que todo branch target aponta para o começo de uma instruction, que todos execution paths possuem stack height válido ou que todo immediate operand está completamente presente.
Essas propriedades são tratadas posteriormente por execution checks, compiler construction rules, JIT constraints e testes.
Um verifier futuro poderia fortalecer essa boundary.
Framing de instructions
Toda instruction começa com um opcode byte.
Instruction length é determinada pelo opcode.
O decoder atual utiliza cinco classes de tamanho:
| Total de bytes | Encoding |
|---|---|
| 1 | somente opcode |
| 2 | opcode + u8 |
| 3 | opcode + signed relative i16 |
| 5 | opcode + 32-bit immediate/relative field |
| 9 | opcode + 64-bit immediate |
insn_len no JIT é uma representação executável desses widths.
O interpreter obtém operands por fetch, que verifica se os immediate bytes solicitados continuam dentro de code_size.
Operand ausente gera CLVM_FAULT_TRUNCATED quando a instruction é executada.
Mapa completo de opcodes atual
O opcode space atual é contínuo de 0x00 a 0x47.
| Hex | Mnemonic | Bytes | Efeito principal |
|---|---|---|---|
| 00 | NOP | 1 | nenhum state change |
| 01 | PUSH | 5 | push de i32 sign-extended |
| 02 | ADD | 1 | a,b -> a+b |
| 03 | SUB | 1 | a,b -> a-b |
| 04 | MUL | 1 | a,b -> a*b |
| 05 | DIV | 1 | signed division |
| 06 | DUP | 1 | duplica top value |
| 07 | 1 | pop para VM print ring | |
| 08 | HALT | 1 | halt da VM |
| 09 | JMP | 3 | relative i16 jump |
| 0A | JZ | 3 | pop condition; jump se zero |
| 0B | CALL | 3 | relative i16 call |
| 0C | RET | 1 | return pela call stack |
| 0D | LOAD | 1 | guest signed 32-bit load |
| 0E | STORE | 1 | guest 32-bit store |
| 0F | DROP | 1 | descarta top se existir |
| 10 | SWAP | 1 | troca os dois top values |
| 11 | EQ | 1 | igualdade |
| 12 | LT | 1 | signed less-than |
| 13 | JNZ | 3 | pop condition; jump se não zero |
| 14 | MOD | 1 | signed remainder |
| 15 | NE | 1 | desigualdade |
| 16 | LE | 1 | signed <= |
| 17 | GT | 1 | signed > |
| 18 | GE | 1 | signed >= |
| 19 | NEG | 1 | arithmetic negation |
| 1A | LOADB | 1 | guest unsigned byte load |
| 1B | STOREB | 1 | guest byte store |
| 1C | CALLI | 1 | pop de absolute bytecode target e call |
| 1D | UDIV | 1 | unsigned 64-bit division |
| 1E | UMOD | 1 | unsigned 64-bit remainder |
| 1F | ULT | 1 | unsigned < |
| 20 | SYS | 1 | pop de syscall ID e dispatch |
| 21 | JMP32 | 5 | relative i32 jump |
| 22 | JZ32 | 5 | pop condition; relative i32 jump se zero |
| 23 | JNZ32 | 5 | pop condition; relative i32 jump se não zero |
| 24 | CALL32 | 5 | relative i32 call |
| 25 | PUSH64 | 9 | push de raw 64-bit immediate |
| 26 | LOAD64 | 1 | guest 64-bit load |
| 27 | STORE64 | 1 | guest 64-bit store |
| 28 | FLOAD | 1 | load de 32-bit float bits |
| 29 | FSTORE | 1 | store dos low 32-bit float bits |
| 2A | FPUSH | 5 | push de 32-bit float bit pattern |
| 2B | FADD | 1 | binary float addition |
| 2C | FSUB | 1 | binary float subtraction |
| 2D | FMUL | 1 | binary float multiplication |
| 2E | FDIV | 1 | binary float division |
| 2F | FNEG | 1 | float negation |
| 30 | FTOI | 1 | float-to-integer conversion |
| 31 | ITOF | 1 | integer-to-float conversion |
| 32 | FEQ | 1 | float equality |
| 33 | FLT | 1 | float < |
| 34 | FLE | 1 | float <= |
| 35 | AND | 1 | bitwise AND |
| 36 | OR | 1 | bitwise OR |
| 37 | XOR | 1 | bitwise XOR |
| 38 | SHL | 1 | left shift, count mascarado para 0..63 |
| 39 | SHR | 1 | logical right shift |
| 3A | SAR | 1 | arithmetic right shift |
| 3B | NOT | 1 | bitwise complement |
| 3C | LDARG | 2 | push de indexed IL argument |
| 3D | STLOC | 2 | pop para indexed IL local |
| 3E | LDLOC | 2 | push de indexed IL local |
| 3F | NEWOBJ | 5 | aloca guest object bytes |
| 40 | LDFLD | 5 | 64-bit field load em immediate offset |
| 41 | STFLD | 5 | 64-bit field store em immediate offset |
| 42 | CALLT | 5 | call para absolute u32 bytecode PC |
| 43 | LDSTR | 5 | push do u32 immediate como VM value |
| 44 | SAFEPOINT | 1 | runtime safepoint |
| 45 | ULE | 1 | unsigned <= |
| 46 | UGT | 1 | unsigned > |
| 47 | UGE | 1 | unsigned >= |
Opcodes fora do switch implementado produzem CLVM_FAULT_OPCODE quando interpretados.
Ordem dos operands na stack
Binary operations retiram primeiro o right operand e depois o left operand.
Se a stack conceitual é:
[..., a, b] <- b é o top
ADD produz:
[..., a + b]
SUB produz a-b, DIV produz a/b e comparisons comparam a contra b.
Essa ordem é importante para compiler lowering.
STORE-style instructions também usam stack order explícita.
Em STORE/STORE64, address fica no top e value imediatamente abaixo:
[..., value, address] -> [...]
STOREB segue a mesma convention.
STFLD adiciona apenas immediate field offset ao object address retirado; sua entrada conceitual é:
[..., object, value] -> [...]
porque a implementação retira value primeiro e object depois.
Representação de integers
A operand stack armazena entries int64_t.
PUSH lê four-byte immediate e faz sign extension de int32_t para int64_t.
PUSH64 lê os oito immediate bytes.
LOAD lê quatro bytes de guest memory, interpreta como 32-bit integer bit pattern, passa por int32_t e empilha result sign-extended.
LOADB coloca value de 0 a 255.
LOAD64 preserva os 64 bits.
Signed/unsigned arithmetic compartilham o mesmo stack storage; o opcode escolhe se values são interpretados segundo regras signed ou uint64_t.
Faults de divisão
DIV, MOD, UDIV e UMOD rejeitam divisor zero com CLVM_FAULT_DIV_ZERO.
DIV/MOD signed também detectam o overflow de complemento de dois:
INT64_MIN / -1
e geram CLVM_FAULT_DIV_OVERFLOW.
Isso evita depender de comportamento indefinido ou host trap específico nesse edge case.
Semântica de shifts
SHL, SHR e SAR mascaram shift count com 63.
Somente os seis low bits do right operand selecionam a distância.
SHR converte left operand para uint64_t antes do shift, implementando logical right shift.
SAR opera no int64_t signed, implementando o arithmetic-right-shift atual do runtime.
Representação de floats
CLVM não possui float stack separada.
Single-precision values são transportados como seu 32-bit bit pattern dentro dos low 32 bits de um operand slot de 64 bits.
FPUSH lê four-byte immediate bit pattern.
FLOAD/FSTORE transferem quatro bytes entre guest memory e a operand representation.
Nas float operations, interpreter copia o low 32-bit pattern pela union Fbits e executa host float arithmetic.
FADD, FSUB, FMUL e FDIV empilham novamente o result 32-bit pattern.
FEQ, FLT e FLE produzem integer boolean results.
FTOI converte numericamente o float reconstruído para integer.
ITOF converte integer operand para float e empilha o float bit pattern.
FDIV verifica divisor reconstruído == 0.0f e gera CLVM_FAULT_DIV_ZERO.
O instruction set atual modela single precision; não existe encoded double-precision VM format.
Relative branches
JMP, JZ, JNZ e CALL contêm signed 16-bit displacement.
As formas de 32 bits contêm signed 32-bit displacement.
A relative base é o PC depois que a instruction completa foi consumida.
Para branch iniciando no byte offset P com length L:
target = P + L + displacement
O interpreter implementa isso porque fetch avança vm->pc sobre o immediate antes de jump_rel16/jump_rel32 somar o relative value.
Os dois helpers rejeitam targets abaixo de zero ou >= code_size.
Target precisa estar dentro do code payload.
Os helpers não provam independentemente que target coincide com instruction boundary.
Conditional branches
JZ/JNZ e JZ32/JNZ32 sempre consomem um condition value.
JZ desvia se o value for zero.
JNZ desvia se for diferente de zero.
Se a condition não permite branch, execution segue no fall-through PC já avançado.
Assim o stack effect é determinístico independentemente de o branch ser tomado.
Direct calls
CALL/CALL32 usam o mesmo relative-target calculation dos jumps correspondentes.
Antes da transferência, colocam post-instruction PC no array dedicado vm->calls.
Operand stack não guarda return PC.
RET retira vm->calls e restaura vm->pc.
A return stack atual possui 64 entries.
CALL com return stack cheia gera CLVM_FAULT_CALL_OVERFLOW.
RET com return stack vazia gera CLVM_FAULT_CALL_UNDERFLOW.
Indirect calls
CALLI não possui encoded immediate.
Ele retira absolute bytecode target da operand stack.
Interpreter verifica:
0 <= target < code_size
depois grava current PC na return stack e muda vm->pc para target.
É o primitive usado em indirect/function-pointer-style control transfer.
O value é CLVM bytecode offset, não native host function pointer.
CALLT e operations orientadas a IL
CLVM também possui pequeno grupo de instructions usado pelas facilidades IL/managed-style:
- LDARG;
- LDLOC;
- STLOC;
- NEWOBJ;
- LDFLD;
- STFLD;
- CALLT;
- LDSTR.
LDARG usa one-byte index e aceita somente indexes abaixo de 16.
LDLOC/STLOC aceitam apenas indexes abaixo de 32.
Eles correspondem a arrays fixos em ClvmVm.
NEWOBJ contém u32 size; zero é normalizado para allocation de 16 bytes. Ele aloca por clvm_guest_malloc e coloca o resulting guest offset na stack.
LDFLD/STFLD contêm u32 byte offset e transferem 64-bit fields relativos ao guest object address.
CALLT contém absolute 32-bit code target e salva return PC antes da transferência. O interpreter atual atribui o immediate diretamente a vm->pc; um value fora do code range é detectado pelo instruction fetch seguinte como PC fault, em vez do immediate range check usado por CALLI.
LDSTR coloca seu u32 immediate como VM value. O core interpreter não dereference nem tipa esse value como string por conta própria.
Essas operations não devem ser confundidas com a ordinary ChrisC calling convention, que usa guest-memory argument scratch própria.
Encoding de SYS
SYS não possui immediate operand.
O syscall identifier é stack value.
Conceitualmente:
[..., syscall arguments..., id]
    SYS
A VM retira id e chama ClvmSysFn registrado.
O callback pode consumir arguments adicionais e colocar result.
Portanto SYS não possui um stack delta universal; seu contrato completo depende do syscall ID selecionado.
Sem callback ou quando callback rejeita a operation, interpreter gera CLVM_FAULT_BAD_SYS.
A numeric syscall ABI está em capítulo separado.
SAFEPOINT
SAFEPOINT ocupa um byte e não altera operand stack.
Interpreter marca vm->safepoint, chama on_safepoint quando instalado, limpa a flag e pode yield conforme scheduler policy.
Calls, allocations e syscalls também podem marcar estado relacionado a safepoint.
O opcode cria explicit runtime coordination point sem alterar program values.
HALT e PRINT
HALT muda a VM para CLVM_HALTED e retorna CLVM_STEP_HALT.
PRINT não depende diretamente de terminal device. Ele retira um value e o registra por note_print em bounded print ring dentro de ClvmVm.
Essa separação mantém core VM independente de console backend concreto.
Encoding produzido pelo ChrisC
ChrisC não produz textual assembly para depois chamar CLASM em seu normal compiler path.
chrisc.c escreve bytecode diretamente no output buffer por emitter helpers.
One-byte instructions são gravadas diretamente.
PUSH-style helpers adicionam little-endian immediate bytes.
Branches reservam displacement e fazem patch quando target PC se torna conhecido.
O compiler seleciona forms de branch de 16 ou mais bits conforme suas lowering rules.
Function calls são patched contra o recorded bytecode entry da target function.
Por isso instruction format precisa permanecer sincronizado com interpreter e JIT decoders.
CLASM textual assembler
compiler/clvm/clasm.c fornece textual assembler separado para CLVM.
Ele usa tabela OpInfo com mnemonic, opcode, encoded size e operand class.
O assembler executa duas passes.
Pass 1:
- parse das instructions;
- cálculo dos bytecode PCs;
- registro de labels.
Pass 2:
- emissão de opcode bytes;
- escrita de immediate values;
- resolução de labels em relative displacements.
Para label branches:
rel = label_address - (instruction_pc + instruction_size)
Branches de três bytes exigem rel em [-32768, 32767].
As forms de cinco bytes escrevem 32-bit relative displacement.
Label chamado main torna-se assembler result entry point; se não existir, entry fica zero.
Limites de operands no CLASM
O numeric parser do CLASM lê atualmente signed 32-bit values.
Em PUSH64, assembler grava low 32 bits e faz sign extension nos high 32 bits.
Logo textual CLASM PUSH64 usa atualmente source literal i32 sign-extended, embora a encoded VM instruction carregue um full 64-bit immediate.
Outros bytecode producers podem codificar arbitrary 64-bit PUSH64 bit patterns.
Essa é diferença entre assembler frontend capability e bytecode capability.
Sincronização de decoders
Vários components precisam concordar sobre instruction width:
- interpreter operand fetch;
- JIT pre-scan/native-code generation;
- debugger/disassembly helpers;
- textual CLASM;
- compiler branch patching.
insn_len do JIT reconhece:
- PUSH/FPUSH como 5 bytes;
- short jumps/calls como 3;
- LDARG/STLOC/LDLOC como 2;
- object/field/CALLT/LDSTR e long jumps/calls como 5;
- PUSH64 como 9;
- todo o restante como 1.
Alteração de bytecode format que mude instruction width precisa atualizar cada decoder/producer dependente desses lengths.
É compatibility obligation, não simples detalhe do compiler.
Interação com JIT
O JIT usa bytecode PC como identidade estável de VM control flow.
Durante compilation ele constrói mapping de bytecode PCs para generated native offsets.
Native implementations de branch/call precisam preservar CLVM-visible state, incluindo vm->pc e vm->calls.
Instructions fora do direct-native set do JIT podem executar por helper paths preservando a mesma semântica de ClvmVm.
O JIT pre-scan não é full bytecode verifier. Seu objetivo principal é percorrer instruction widths e verificar constraints do JIT.
O interpreter continua sendo a implementação semântica por opcode para paths tratados por helpers.
Comportamento de malformed bytecode
Malformed images podem falhar em fronteiras distintas.
Envelope defects falham em clvm_parse.
Execution defects tornam-se VM faults:
| Defeito | Resultado atual |
|---|---|
| unknown opcode executado | CLVM_FAULT_OPCODE |
| immediate bytes ausentes | CLVM_FAULT_TRUNCATED |
| branch target fora do code | CLVM_FAULT_BAD_JUMP |
| operand stack underflow | CLVM_FAULT_STACK_UNDERFLOW |
| operand stack overflow | CLVM_FAULT_STACK_OVERFLOW |
| return stack underflow/overflow | call fault correspondente |
| guest address inválido | CLVM_FAULT_BAD_ADDRESS |
| syscall rejeitada | CLVM_FAULT_BAD_SYS |
A VM registra fault kind e fault PC.
Isso fornece failure description determinística para debugger/runtime em vez de permitir que interpreter memory operations prossigam sobre estado inválido.
Security boundary
O bytecode format isoladamente não é security sandbox.
A segurança depende da combinação de:
- CLV envelope validation;
- opcode bounds checks;
- guest-memory range checks;
- bounded VM stacks;
- syscall pointer validation;
- syscall ownership/capability checks;
- process/runtime isolation policy.
Checksum evita corrupção acidental, não malicious modification.
Da mesma forma, aceitar opcode stream sintaticamente válido não prova que suas syscalls posteriores são autorizadas.
Bytecode validation e syscall authorization são layers distintas.
Complexidade
Image parsing é O(code_size), pois checksum validation lê todo payload.
Instruction decode no interpreter é O(1) por ordinary instruction, excluindo variable-cost syscalls e memory-copy services.
CLASM é efetivamente O(source_size + emitted_code_size) em duas passes lineares, com bounded label-table searches pequenos sob os fixed limits do assembler.
Branch execution é constante.
O fixed instruction encoding evita variable-length prefix parsing típico de x86.
O trade-off é menor encoding density para algumas operations e dependência de operand stack.
Evidência de validação
tools/test_fuzz_clvm.c fornece repetidamente random short buffers a clvm_parse e verifica que loader errors permanecem no ClvmLoadError range. Também escreve image válida e verifica parse round trip.
tools/test_clasm.c compila textual CLASM e verifica generated bytecode e entry behavior.
tools/test_jit_vm.c compila ChrisC em CLVM e compara important interpreter/JIT execution state.
tools/test_editor_vi.c contém instruction-length decoding próprio para diagnostics/regression e exercita call-stack overflow em interpreter/JIT.
Os testes mais amplos de ChrisC executam programas CLVM gerados, fornecendo cobertura indireta de arithmetic, branches, calls, loads/stores e syscall emission.
Esses testes evidenciam comportamento implementado; não são formal proof de que todo arbitrary byte stream é seguro ou semanticamente válido.
Limitações atuais
Na revisão documentada:
- não existe standalone full bytecode verifier antes de execution;
- CLV images possuem single code payload em vez de general section table;
- symbols, relocations e debug maps não são first-class CLV sections;
- checksum é FNV-1a, não cryptographic authentication;
- entry v1 é limitado a 16 bits;
- v2 continua usando flat header/payload simples;
- branch targets são range-checked, mas clvm_parse não prova globalmente instruction boundaries;
- ordinary VM stack effects não passam por static checking;
- CALLT target validation ocorre por execution posterior, não pelo mesmo immediate check do CALLI;
- CLASM numeric literals são i32-limited mesmo para encoded PUSH64;
- float bytecode modela single precision;
- instruction-width knowledge existe em múltiplos components e precisa permanecer sincronizado.
Fronteira de roadmap
Uma futura bytecode revision pode adicionar:
- formal verifier pass;
- explicit section tables;
- embedded symbols/source maps;
- relocation/module metadata;
- capability/import declarations;
- bytecode feature/version flags;
- integrity/authenticity metadata mais forte;
- typed stack verification;
- exact instruction-boundary maps;
- larger/structured constant pools.
Qualquer mudança desse tipo exige versioning explícito porque o byte stream é consumido por compiler, loader, interpreter, JIT, debugger e tooling.
Até implementação correspondente existir, o formato v1/v2 e o opcode map descritos acima constituem o contract operacional.
Mapa de source e revisão
Image constants, opcode numbers e public image structures são definidos em compiler/clvm/clvm.h.
Header encoding/decoding e checksum validation ficam em compiler/clvm/clvm_format.c.
Instruction execution e runtime fault behavior estão em compiler/clvm/clvm_vm.c.
Textual assembly encoding está em compiler/clvm/clasm.c.
O direct bytecode producer do ChrisC está em compiler/chrisc/chrisc.c.
Instruction-width decoder e bytecode-to-native mapping do JIT estão em compiler/jit/jit_compile.c.
Todas as afirmações de comportamento atual deste capítulo foram reconciliadas com ChrisOS revision e05a17fd76333114a3fb5c2452f38ca747d4ac56.