
Análise semântica e sistemas de tipos
Sobre este capítulo Construção de compiladores
Neste capítulo
- Análise semântica e sistemas de tipos
- Escopo
- Análise semântica como preservação de invariantes
- Estado semântico do ChrisC
- Modelo Symbol do ChrisC
- Scopes e resolução de nomes no ChrisC
- Inserção de declarations e detecção de duplicatas
- Typedef como estado semântico do parser
- Identidade de structures e unions
- Layout de aggregates no ChrisC
- Types incompletos e aggregates aninhados
- Semântica de cast no ChrisC
- Lvalues no ChrisC
- Semântica de pointers no ChrisC
- Classificação floating no ChrisC
- _Generic no ChrisC
- Functions e call semantics no ChrisC
- Representação Type do KCC
- Val e value categories no KCC
- Resolução de symbols no KCC
- Normalização de builtin types no KCC
- Structures e alignment no KCC
- Member access no KCC
- Address-of e dereference no KCC
- Array decay no KCC
- Assignability no KCC
- volatile no KCC
- Fronteira de floating point no KCC
- Semântica de constant expressions
- sizeof como transação semântica
- Static assertions
- Diagnostics e modelo de falha
- Complexidade e custo de armazenamento
- Concorrência e reentrância
- Segurança e robustez
- Evidência de validação
- Limitações atuais
- Fronteira de roadmap
- Mapa de source e revisão
Escopo
Análise semântica determina se um programa sintaticamente válido possui um significado suportado pela implementação da linguagem. Ela resolve nomes, classifica tipos, valida operações contra esses tipos, calcula layout, verifica atribuibilidade, seleciona conversões e transporta informação necessária para a geração de código.
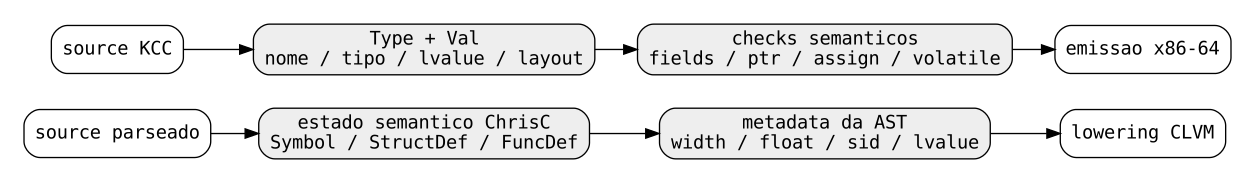
ChrisOS possui atualmente dois caminhos de compilação C-like substancialmente diferentes.
ChrisC produz registros Node semelhantes a uma AST para posterior lowering em CLVM. Seu estado semântico é distribuído entre Symbol, StructDef, FuncDef, tabelas de typedef, constantes e metadados incorporados nos nodes. Parte da semântica ocorre durante o parsing e outra parte volta a ser interpretada no lowering.
KCC não possui uma passagem semântica separada sobre AST. Ele usa registros Type e Val enquanto faz parsing e emite assembly x86-64 imediatamente. Resolução de nomes, propagação de tipos, validação de lvalue, layout e emissão de backend acontecem, portanto, em um pipeline syntax-directed.
Nenhum dos dois caminhos implementa um sistema de tipos ISO C completo. Ambos implementam perfis específicos do projeto moldados pelos programas que ChrisOS precisa compilar.
Análise semântica como preservação de invariantes
Uma forma útil de entender a análise semântica é tratá-la como preservação de invariantes.
Para cada uso de identificador deve existir uma declaração visível ou outro significado reconhecido, como enum constant, builtin ou function.
Para cada acesso a field, a base precisa identificar um structure type e o field precisa existir.
Para cada destino de assignment, a expressão precisa designar armazenamento gravável no modelo suportado.
Para cada operação de pointer, o compilador precisa conhecer informação suficiente sobre o pointee para calcular aritmética de endereços ou rejeitar a operação.
Para cada aggregate, o compilador precisa produzir size e field offsets estáveis antes de o codegen depender desses valores.
Para cada conversão, o compilador precisa preservar o comportamento esperado de width, signedness, floating classification e pointer semantics dentro do subset.
A implementação não reúne esses invariantes em um único semantic-pass object. Eles são distribuídos por tabelas e checks locais.
Estado semântico do ChrisC
ChrisC armazena o universo semântico principal dentro de Compiler.
Entre as tabelas fixas mais importantes estão:
- Symbol syms[] para variables e objects;
- StructDef structs[] para layouts de structures e unions;
- FuncDef funcs[] para functions;
- arrays de typedef para names, widths, pointer classification, structure identity e array metadata;
- tabelas de constants para enums e nomes avaliáveis em compile time;
- Node nodes[] para expressions e statements parseados.
Essa arquitetura evita alocação dinâmica do lado do compilador em muitos objetos comuns, mas introduz limites explícitos de saturação. Uma tabela cheia produz erro de compilação em vez de crescer dinamicamente.
A identidade de entidades também costuma ser um índice inteiro. Structure é referenciado por structure ID, symbol por índice da tabela e child de AST por node index.
Modelo Symbol do ChrisC
Symbol não é um descritor canônico e recursivo de tipo C. Ele é um registro compacto orientado a armazenamento que carrega as propriedades necessárias ao compilador atual.
Entre os campos relevantes estão:
- name e storage address;
- scalar width;
- classificação float;
- classificação packed byte;
- flags de array e pointer;
- flags unsigned e const;
- scope identifier;
- pointee width;
- structure ID;
- stride;
- array count;
- estado global e thread-local.
Isso é suficiente para responder perguntas práticas como:
Quantos bytes este objeto ocupa?
Indexação avança por 1, 4, 8 bytes ou pelo tamanho de uma structure?
O valor é tratado como floating value?
Member access precisa de metadata de structure?
Assignment é proibido porque o symbol é const?
O modelo é menos expressivo que um type graph recursivo. Declarators profundos são comprimidos em flags e side metadata.
Scopes e resolução de nomes no ChrisC
Scopes locais usam IDs numéricos.
scope_enter incrementa uma sequência e empilha o novo ID em um scope stack limitado. scope_leave remove o scope ativo. scope_visible determina se o scope armazenado em um symbol pertence a algum contexto ainda visível.
sym_find_local percorre symbols do mais novo para o mais antigo. Isso implementa shadowing normal de declarações locais visíveis: a declaração compatível mais recente vence.
sym_find primeiro procura locals visíveis, depois nomes static com mangling da translation unit quando aplicável e, por fim, nomes globais através da hash table de symbols.
O modelo combina:
- visibilidade léxica semelhante a stack para locals;
- hash-based lookup para globals;
- translation-unit mangling para symbols static de arquivo.
O reverse scan local é O(n) no número de symbols registrados no pior caso. O global hash lookup tende a custo próximo de constante sob ocupação normal, mas usa tabelas fixas específicas do projeto.
Inserção de declarations e detecção de duplicatas
sym_add primeiro tenta o reaproveitamento permitido de globals e depois percorre as declarações do scope atual procurando duplicatas.
Uma duplicata no mesmo scope produz diagnostic. Shadowing em scope aninhado continua possível porque o scope ID é diferente.
Ao aceitar a declaration, o compilador normaliza propriedades de armazenamento. Pointer objects ocupam width 8 para o próprio pointer, enquanto pointee width é preservado separadamente. Valores pequenos não-pointer podem reservar um slot mínimo de armazenamento segundo o memory model orientado ao CLVM atual.
A distinção central é:
object width != pointee width != allocation stride
O compilador não pode inferir pointer arithmetic apenas a partir do width do pointer object.
Typedef como estado semântico do parser
typedef_find procura o nome na tabela de typedef.
Conhecimento de typedef é necessário antes mesmo de o parser decidir determinada interpretação sintática. is_typename_at consulta typedefs ao distinguir cast de parenthesized expression, e parse_type_n importa width, pointer classification, structure ID, array count e element width armazenados.
Assim, resolução de typedef é simultaneamente estado sintático e semântico.
Forward structure typedefs formam um caso especial. Um typedef pode ser registrado quando a structure ainda está incomplete. typedef_refresh_struct e typedef_live_width reconciliam posteriormente o width do typedef com o size da structure completa.
Isso evita que um width provisório usado antes da definição contamine permanentemente sizeof ou pointer stride.
Identidade de structures e unions
struct_find mapeia tag para StructDef.
Cada StructDef mantém:
- field names;
- field widths;
- classificações floating e pointer;
- field offsets;
- IDs de nested structures;
- array element widths;
- bit-field width e bit offset;
- aggregate size;
- flags packed e union.
field_find procura field name por varredura linear dentro de um aggregate.
Como FIELD_MAX limita a quantidade de fields, o upper bound é pequeno e fixo, mas o custo permanece O(f) no número de fields.
Layout de aggregates no ChrisC
parse_struct_def e struct_recompute_layout calculam a representação atual de structures no ChrisC.
Para fields comuns não packed, widths de um ou dois bytes são promovidos para uma storage unit de quatro bytes por esse modelo. Fields maiores consomem o width registrado. Packed structures usam diretamente o width registrado.
Fields de union recebem offset zero e o aggregate size passa a ser o maior storage requirement entre os fields.
Bit fields são agrupados em units de 32 bits quando suportados. struct_recompute_layout inicia uma nova unit quando o próximo field ultrapassaria a fronteira de 32 bits e registra tanto byte offset quanto bit offset.
Isso é uma decisão de ABI do projeto. Não deve ser generalizada como se ChrisC reproduzisse todas as regras de layout do C do host ou do System V ABI.
Types incompletos e aggregates aninhados
Um StructDef pode existir antes que todos os fields estejam conhecidos. Isso permite tagged forward references.
Nested structures carregam IDs em fstruct. Pointer fields mantêm pointer classification separada para evitar confundir pointer-to-structure com embedded structure value.
Quando o body da structure termina, o semantic metadata precisa estar internamente consistente antes de codegen usar member offsets ou pointer stride.
Portanto, o type system possui dimensão temporal: alguns tipos passam de declared/incomplete para layout-complete.
Semântica de cast no ChrisC
CastType é a representação semântica temporária usada por parse_cast_type.
Ele registra:
- result width;
- classificação float;
- unsignedness;
- pointer state;
- classificações void e boolean;
- pointee width;
- pointee float state;
- structure ID.
A AST armazena informação de cast em formato compacto. Width e flags são codificados no payload do node N_CAST.
Isso reduz espaço de representação, mas acopla interpretação semântica a bit encodings que o lowering posterior precisa conhecer.
O subset atual cobre integer-width changes, boolean normalization, conversões float/integer suportadas, casts com shape de pointer e metadata selecionada de structure/pointee.
Cast não é apenas remoção de syntax: ele muda a forma como o lowering interpreta o valor.
Lvalues no ChrisC
ChrisC não expõe um objeto universal Type + value category para cada expression. Em vez disso, assignability é inferida a partir de node kind e metadata dos symbols referenciados.
Destinos suportados de assignment incluem ordinary variables e formas especializadas de AST para:
- array indexing;
- fields;
- pointer dereference;
- pointer-field access.
Quando nenhum storage form aceito é encontrado, assignment falha com diagnostic "assignment needs lvalue".
Const é rastreado nos symbols, e os caminhos de assignment consultam esse estado para os casos diretos suportados.
A abordagem é prática, porém descentralizada: adicionar uma nova expression que possa designar storage exige atualizar os caminhos semânticos e de code generation que reconhecem lvalues.
Semântica de pointers no ChrisC
Pointer objects ocupam oito bytes, mas Symbol.pointee e Symbol.stride preservam a informação usada para avançar endereços.
Pointer increment/decrement usam expr_ptr_stride. Operações de array e field utilizam element widths ou structure metadata.
A regra central implementada é:
address_delta = integer_delta * pointee_stride
O sistema suporta as categorias de pointer exigidas pelo codebase atual, mas não constitui um modelo recursivo completo de C declarators. Distinções profundas de pointer levels e qualifiers só existem na medida em que os campos e o cast encoding atuais conseguem representá-las.
Classificação floating no ChrisC
Node possui flag is_float, e Symbol e StructDef carregam metadata equivalente.
Arithmetic lowering consulta a classificação float dos operands e pode inserir conversão integer-to-float quando apenas um lado exige representação floating.
Pointer dereference exige cuidado adicional, porque "o pointer não é float" e "o pointee é float" são afirmações diferentes. deref_pointee_float segue cast metadata, symbol pointee classification e expression metadata para decidir a classe do valor carregado.
É mais um exemplo de semântica distribuída entre AST nodes e symbol records.
_Generic no ChrisC
ChrisC implementa um subset de _Generic.
A controlling expression é parseada e sua classificação semântica é inspecionada para escolher entre as associations suportadas. A implementação é mais estreita que a noção ISO C completa de compatible types.
O ponto arquitetural é que generic selection consome type information durante parsing. Ela não é postergada para uma passagem posterior na árvore.
Functions e call semantics no ChrisC
FuncDef armazena names, argument count, width e floating classification por argumento, return classification, body node e metadata de generated entry.
Function lookup é separado do lookup de ordinary variables.
Ao construir calls, ChrisC distingue builtins, functions conhecidas e values com shape de function pointer. Return metadata é propagado ao call node para que expressions posteriores classifiquem o resultado.
Isso atende ao ABI CLVM atual, mas não representa um compatibility engine geral para todas as regras de prototypes do C.
Representação Type do KCC
KCC usa um registro Type mais explícito.
Type contém:
- kind;
- is_ptr;
- pointee_size;
- array_len e inner_len;
- struct_id;
- size e alignment;
- volatile state;
- pointee volatile state;
- function-pointer state.
type_make inicializa um scalar type. type_ptr deriva um pointer preservando pointee size, structure identity e pointee volatility.
A representação continua compacta, mas é carregada diretamente pelas expressions através de Val.
Val e value categories no KCC
Val combina semantic type com current value category e backend state.
Ele registra:
- Type type;
- flag lvalue;
- function classification;
- lvalue location kind;
- frame slot;
- immediate-value state;
- global symbol name.
O enum de localização distingue:
LV_LOCAL
LV_GLOBAL
LV_ADDR
Essa distinção importa porque duas expressions podem ter o mesmo Type e ainda exigir sequências totalmente diferentes de load/store.
A semântica no KCC classifica, portanto, tanto "qual é o type?" quanto "onde este value vive?".
Resolução de symbols no KCC
KCC mantém Sym records em uma tabela fixa.
sym_find percorre do último para o primeiro e retorna o primeiro symbol alive com name correspondente. Isso dá prioridade natural à declaração mais recente.
Ao contrário do scope stack numérico explícito do ChrisC, KCC usa liveness do symbol e gerenciamento do parser para representar visibilidade atual.
O lookup tem custo O(n) no pior caso.
Typedefs ficam em tabelas separadas de name para Type, g_td_name e g_td_type. td_find também faz busca linear numa tabela fixa.
Normalização de builtin types no KCC
parse_base reconhece o vocabulário de builtin e typedef types do compilador.
A implementação mapeia vários spellings familiares de C para um universo interno menor. Diversos nomes de inteiros de 64 bits convergem, por exemplo, para uma representação Type orientada a width.
Essa simplificação é adequada para compilação do kernel, mas significa que diferenças de source-level type nem sempre permanecem como semantic kinds distintos.
KCC também registra volatile, structure identity, pointer depth nas formas suportadas, array geometry e alignment.
Structures e alignment no KCC
KCC StructDef guarda Field records, aggregate size e aggregate alignment.
Cada Field possui um Type completo e um byte offset.
O parser de structure calcula field layout imediatamente. O offset é alinhado ao alignment escolhido, exceto quando packed behavior reduz esse alinhamento. Aggregate alignment torna-se o maior alignment aplicável, e o final size é arredondado para esse alignment.
Os tests exercitam explicitamente layout normal e packed.
O modelo se aproxima mais de uma descrição convencional de native compiler layout que os compact field arrays do ChrisC, mas continua sendo o layout implementado pelo KCC, não uma afirmação de ABI C completo.
Member access no KCC
postfix_tail executa checks semânticos para dot e arrow.
Para arrow:
- a base precisa ser pointer;
- o type precisa carregar structure ID válido.
Para dot:
- a base não pode ser pointer;
- o type precisa carregar structure ID válido.
Depois, o field name é procurado no StructDef selecionado. Field ausente falha imediatamente.
O Val resultante torna-se address lvalue com o Type do field.
Assim, member selection combina resolução de nome, type checking, cálculo de offset e construção de value category.
Address-of e dereference no KCC
Address-of exige lvalue. Se o operand não for addressable, a compilação falha.
Quando válido, gen_addr materializa o endereço e type_ptr converte o operand type em pointer type.
Dereference faz o check oposto. O operand precisa ser pointer ou forma array-like suportada. O pointee size é usado para construir o element Type e o resultado torna-se LV_ADDR lvalue.
As transições semânticas são:
lvalue T --&--> rvalue pointer-to-T

pointer-to-T --*--> lvalue T
Essas transições são conectadas diretamente ao assembly emitido.
Array decay no KCC
load_val contém a regra de array-to-pointer decay.
Se um Val é array lvalue, carregá-lo não copia o array inteiro. O compilador gera o endereço, limpa a value category de lvalue e converte seu type com type_ptr.
Essa é uma regra semântica implementada dentro de um helper voltado ao backend, demonstrando novamente que KCC não separa semantic analysis de lowering.
Indexing calcula element address a partir de base + index * element size e retorna um address lvalue com o element Type.
Assignability no KCC
Assignments simples e compostos exigem out->lvalue.
Assignment simples rejeita adicionalmente arrays como destinos.
O compilador salva o Val de destination antes de parsear o right side, avalia o right side em RAX e chama store_val com a descrição preservada do destino.
Increment e decrement seguem a mesma ideia. inc_lv rejeita non-lvalues, deriva step 1 para scalars ou pointee_size para pointers, calcula o novo value e faz store através da category original.
volatile no KCC
Type registra volatile no object e separadamente no pointee.
load_val e store_val alteram comportamento para volatile memory. Em particular, volatile globals não passam pela lógica de dead-store elimination usada em globals comuns.
A test suite verifica que repeated volatile stores e loads permanecem no emitted assembly, enquanto ordinary redundant stores podem ser reduzidos.
Isso é propriedade semântica relevante: volatile afeta observable access behavior, não apenas a escrita do type.
Fronteira de floating point no KCC
KCC reconhece float no vocabulário de types, mas o native code generation atual rejeita operações ordinárias de floating value através de reject_float.
Portanto, a existência de TY_FLOAT não implica implementação nativa completa de floating point.
É necessário distinguir:
- parsing/recognition do type;
- armazenamento de type metadata;
- operações executáveis realmente suportadas pelo codegen.
A fronteira atual retorna erro "float is outside this subset" em caminhos que exigem load ou store nativos de valores float.
Semântica de constant expressions
KCC possui um evaluator separado para constant expressions.
ce_primary, ce_unary, ce_bin e ce_expr são usados em contextos como:
- array bounds;
- enum values;
- preprocessor conditions;
- static assertions.
O evaluator calcula uint64_t diretamente e valida condições como division by zero e shift count inválido.
Como runtime expressions e constant expressions têm implementações separadas, parity semântica entre elas é um risco de manutenção explícito. Precedence e accepted forms podem divergir sem cobertura de tests.
sizeof como transação semântica
parse_sizeof_type aceita tanto type quanto expression.
Para type, size vem do Type metadata.
Para expression, KCC precisa descobrir o Type resultante sem manter side effects de runtime code generation. Ele salva assembly length, overflow state, dead-store state, temporary count e frame state, parseia a expression e depois restaura o backend state.
Isso funciona como uma semantic transaction sobre um parser/backend que, no restante do compilador, é fundido.
Se o type resultante não possui size positivo válido, sizeof reporta incomplete type.
Static assertions
_Static_assert usa o evaluator de constant expressions.
A condição é parseada e avaliada em compile time. Resultado zero produz compile failure.
Isso é validação semântica porque o statement pode ser sintaticamente válido e ainda assim inválido pelo valor de sua expressão constante.
Diagnostics e modelo de falha
Os dois compiladores são predominantemente fail-fast.
ChrisC registra source coordinates no token stream e retorna diagnostics via ChrisResult.
KCC mantém KccDiag com file, line, column, severity e message.
Semantic errors incluem classes como:
- duplicate variable;
- unknown symbol ou field;
- assignment para non-lvalue;
- address-of de expression não addressable;
- dereference de non-pointer;
- dot ou arrow sobre base incompatível;
- invalid array bound;
- incomplete type em sizeof;
- builtin ou type operation fora do subset.
Não existe passagem geral de semantic recovery com múltiplos erros. Depois que parser e backend state são parcialmente modificados, continuar de forma segura exigiria arquitetura mais transacional ou multi-phase.
Complexidade e custo de armazenamento
As operações semânticas dominantes são operações em tabelas limitadas.
No ChrisC, local name lookup é linear em symbols registrados; vários lookups globais, de typedef e structure usam fixed hash tables; field lookup é linear em fields.
No KCC, buscas de symbol, typedef, enum e field são majoritariamente linear scans em arrays fixos.
Aggregate layout é linear no número de fields.
Expression type propagation ocorre durante a mesma travessia usada pelo parser, adicionando trabalho semântico O(1) local para a maioria dos nodes. A compilação normal permanece aproximadamente linear no tamanho do source, além dos fatores de lookup, preprocessing expansion e scans repetidos.
Fixed tables oferecem allocation behavior previsível e evitam dependência do allocator em caminhos importantes, mas impõem hard capacity limits.
Concorrência e reentrância
ChrisC mantém a maior parte do estado num Compiler explícito, estrutura mais adequada a compilations independentes.
KCC armazena grande parte do estado em file-scope globals como g_p, g_struct, g_sym, g_td_type e assembly buffers.
KCC, portanto, não é um compiler context reentrant na implementação atual. Compilations concorrentes no mesmo processo exigiriam serialização ou refactor para um context explícito.
Isso é propriedade da implementação, não limitação geral do language profile.
Segurança e robustez
Compiler input pode ser hostil mesmo quando o compiler é principalmente ferramenta do próprio projeto.
Entre as fronteiras semânticas relevantes estão:
- fixed table saturation;
- aritmética de aggregate e array sizes;
- invalid ou incomplete types;
- recursive declarator depth;
- malformed field graphs;
- pointer-width assumptions;
- rollback correctness durante speculative semantic parsing;
- diagnostics após partial state mutation.
O código possui bounds explícitos e vários fail-fast checks, mas isso não basta para descrever os compiladores como hardened contra arbitrary adversarial source.
Evidência de validação
A validação do ChrisC inclui test_chrisc_c17.c, que cobre typedefs, structures, arrays, casts, sizeof, _Generic, function pointers, compound literals e outros recursos do perfil C. test_chrisc_lang.c compila e executa programas ChrisC sobre CLVM. test_fuzz_chrisc.c envia inputs malformados aos caminhos de robustez.
A validação do KCC em test_kcc.c compila snippets focados e arquivos reais do ChrisOS. Os tests cobrem structure layout, packed structures, nested aggregates, enums, volatile access, operações orientadas a pointers, static assertions e fluxos de native object/link.
Esses testes são evidência da implementação atual. Eles não estabelecem conformidade completa com o padrão da linguagem.
Limitações atuais
Na revisão documentada:
- nenhum dos compiladores possui uma passagem autônoma e limpa de semantic analysis;
- nenhum implementa regras completas de ISO C compatibility;
- ChrisC distribui type facts entre symbols, AST flags e side tables;
- KCC combina type checking com native emission;
- KCC usa global compiler state e não é reentrant;
- operações native float continuam fora do subset do KCC;
- type compatibility é mais estreita que um canonical recursive type system completo;
- semantic diagnostics são majoritariamente fail-fast;
- symbol e type tables possuem capacidades fixas;
- constant e runtime expression semantics são mantidas por caminhos separados no KCC;
- qualifier propagation cobre apenas o subset representado pelo metadata atual;
- function compatibility não é um engine completo de ISO C prototype compatibility;
- diferenças de source-level types podem ser reduzidas a internal types orientados a width.
Essas fronteiras precisam permanecer explícitas ao avaliar que código as toolchains conseguem compilar.
Fronteira de roadmap
Possíveis evoluções incluem:
- uma representação de type canônica e recursiva compartilhada por declarations e expressions;
- semantic-analysis passes explícitos sobre AST estável ou typed IR;
- rotinas de type compatibility e conversions separadas do parser;
- qualifier propagation mais rica;
- function types completos e prototype checking;
- structured semantic diagnostic codes;
- multiple-error recovery;
- estado KCC reentrant baseado em context;
- semântica unificada de operators para constant/runtime expressions;
- property tests para layout e pointer arithmetic;
- differential tests contra regras declaradas do language profile;
- contratos de ABI mais explícitos para aggregate layout.
Esses itens pertencem ao roadmap e não descrevem comportamento atual.
Mapa de source e revisão
A semântica do ChrisC está concentrada em compiler/chrisc/chrisc.c em torno de Symbol, StructDef, DeclType, CastType, scope e symbol lookup, structure layout, parse_type_n, parse_cast_type, construção de primary/postfix/unary expressions, validação de assignments e lowering para CLVM.
A semântica do KCC está concentrada em compiler/kcc/kcc.c em torno de Type, Field, StructDef, Sym, Val, type_make, type_ptr, parse_base, parse_primary, postfix_tail, parse_unary, parse_binary, load_val, store_val, constant expressions e structure layout.
Todas as afirmações sobre comportamento atual deste capítulo foram reconciliadas com a revisão ChrisOS e05a17fd76333114a3fb5c2452f38ca747d4ac56.